特斯拉MODEL 3三月底發佈 預估售價約合人民幣22.77萬

據報導,特斯拉將於3月31日發佈全新MODEL 3車型,新車將於同期開始接受預訂,最快有望於2017年晚些時候交付客戶。新車的預估售價約為35000美元(約合人民幣22.77萬元)。

發佈當日,特斯拉將同期開始接受現場預訂,訂金為1000美元(約合人民幣6506元),次日(4月1日)起接受線上預訂,而新車實際交付將會於2017年晚些時候進行。根據消息,預售價為35000美元(約合人民幣22.77萬元)的MODEL 3作為入門車型,其電池續航里程或低於定位更高的MODEL S和MODEL X車型。即將發佈的MODEL 3車型為一款三廂轎車,但未來不排除有跨界版本出現的可能。

特斯拉CEO埃隆•馬斯克曾經表示,MODEL 3未來有望在中國投產,而價格預計只有MODEL S的一半。作為特斯拉的入門車型,MODEL 3將是一款肩負走量任務的產品,適合進行當地語系化生產。未來國產後,其價格可能會下降三分之一。

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開

戴姆勒 2016 年底前擬推出長續航距離電動車

據美國科技部落格 VentureBeat 報導,德國汽車廠商戴姆勒 (Daimler) 將在 2016 年 10 月份舉行的巴黎國際汽車展上,首次推出超長續航距離電動汽車,希望電動 SUV 的市場與特斯拉 Model X 一較高下。   報導中表示,戴姆勒技術研發部門負責人湯瑪斯‧韋伯 (Thomas Weber) 在出席位於德國斯圖加特舉行的記者會時宣布,該公司將會展示續航里程達 500 公里的賓士電動汽車原型車,與特斯拉 Model X 一較高下。不過, Thomas Weber 並未透露這款電動汽車何時上路行駛,只說會在 2020 年前完成這一目標。   目前,戴姆勒和歐洲其他汽車廠商正加緊對電動汽車的投資,以滿足歐盟新的排放標準,並且追趕上美國電動汽車產業的當紅炸子雞──特斯拉 (Tesla) 。另外,戴姆勒在德國本土的競爭對手,福斯旗下子公司包括奧迪與保時捷均已推出續航里程很長的電動汽車原型車,至於 BMW 也正在開發這種車型。   Thomas Weber 表示,戴姆勒將在 2016 年底推出第四代 Smart 電動汽車,包括兩座和四座兩個車型。戴姆勒目前共有 Smart 和 B 系列兩個全電動車型,還有眾多插電式混合動力車,即同時採用電池和汽油引擎驅動的車型。新款混合動力車也在開發之中。據了解,戴姆勒的目標是在 2020 年以前,每年售出超過 10 萬輛電動車。不過,Thomas Weber 拒絕提供 2015 年的銷售資料。   除了長距離續航力的電動車之外,戴姆勒還在開發燃料電池汽車,這種車型使用由氫發的電。該公司原計劃在 2014 年推出燃料電池汽車,但由於價格問題,不得不延遲發表。消息指出,戴姆勒燃料電池汽車 SUV GLC 預計將在 2017 年投產,屆時可能會與豐田 Mirai 展開競爭。   (首圖來源: CC BY 2.0)   (本文授權轉載自《》─〈〉)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

Nikola 氫電皮卡概念車 Badger 登場,續航將近一千公里,你信嗎?

電動車新創 Nikola 推出全新電動皮卡概念車 Badger,同時採用電池動力與氫燃料電池,續航里程高達 960 公里,零到一百加速只要 2.9 秒,問題是還有多少人相信他們?

超狂電動車新創 Nikola Motor(尼古拉)再次發出豪語,他們全新的皮卡車 Badger,將可以擁有傲視全球的 600 英哩續航力(約 960 公里),並且輸出高達 906 馬力,扭力也是兇猛的 1328 牛頓米。而且這台新車將採用雙動力模式,能夠以電池動力行駛,里程就已經有 300 英哩(約 480 公里),還可以再用氫燃料電池行駛額外的 300 英哩(480 公里),來吸引沒辦法充氫氣的族群。

Badger 的官方數據非常嚇人,完全樂勝競爭對手。

這輛新車的規格完全足以跟 Tesla Cybertruck、Rivian R1T 和電動悍馬車相抗衡,同時還有超越對手的續航力,Nikola 將在今年 9 月的技術大會上展示這輛全新的 Badger。

然而,Nikola 最不缺乏的就是漂亮的數據與規格,他們最需要的是一款真正能夠銷售的「產品」。Nikola 跟 Tesla 同樣用偉大科學家為名,也同樣喜歡講大話,但是 Tesla 在 2004 年到 2007 年總共進行了 3 輪募資,總金額約 6,500 萬美元。2006 年 Tesla 推出第一台原型車 Roadster,並且開始接單,2008 年第一季交車。儘管在初期有許多瑕疵,但至少他們把產品做出來也賣了出去。

但是 Nikola 的吸金功力遠遠超越它的前輩,他們光是 2017 年第一輪就募到 1.1 億美元後,目前已經進行了四輪募資,最新一輪的投資者包含 Bosch(博世)、Hanhwa(韓華技佳) 和 CNH(凱斯紐環球),金額超過 5 億,也讓它的募資總金額超過十億美元。

大廠領投加上跨時代的高科技,或許還要感謝 Tesla 的成功故事,讓這家連原型車都還沒做出來的車廠,就能拿下超過十億美元的資金。

Nikola 氫燃料電池卡車頭 TRE,直接和 Tesla Semi 打對台。

今年 9 月,Nikola 將舉辦 Nikola World 2020 大會,原先預定在這場大會上展示的,是他們新的氫燃料電池,根據之前官方釋出的消息,將能夠讓電動車續航力高達 1,200 公里,卡車甚至能高達 1,600 公里,讓所有人都嚇傻了。如今又新增這台氫電皮卡車 Badger 也要在 9 月展示,到底真相如何,屆時就能分曉。

如果 Nikola 真的掌握了革命性的技術,那麼未來發展很有機會超越特斯拉,成為商用市場的電動車小霸王;相反的,如果 Nikola 沒辦法兌現這些承諾,那就成了電動車界的 Theranos,對整體產業發展產生負面衝擊。

(合作媒體:。首圖來源:)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

現實生活中的鋼鐵人──Tesla 聯合創辦人 Elon Musk

漫威系列中的鋼鐵人 Anthony Stark 擁有極佳的政治和商業手腕,縱橫在各個領域之間。現實生活中的 Tesla 聯合創辦人 Elon Musk,除了在電動車市場佔有一席之地以外,過往他成立的電子支付平臺 PayPal,或是現在同時經營的太空計畫 SpaceX,甚至是打造未來交通系統全新樣貌的 Hyperloop,其成就都可以和 Anthony Stark 比擬。  
Elon Musk 簡介   1971 年出生在南非,Elon Musk 本身具有多重身分,最廣為世人所知的是 SpaceX 創辦人,以及 PayPal 和 Tesla 的聯合創辦人。他有過兩段婚姻和 5 個孩子,最終都以離婚收場。其投資或創立的公司眾多且跨足各種領域,並能善用之間的脈絡進行技術整合,被喻為鋼鐵人的真人版,也曾在電影《鋼鐵人》客串飾演自己。  

▲ Elon Musk 在鋼鐵人中客串演出自己。(Source:)  
創業的起點-Zip2、PayPal   24 歲那年,Musk 從史丹佛的物理研究所中輟離開學校,開創他的第一家公司 Zip2 Corporation,一家對線上報紙提供地圖和商業指引的公司。4 年後,1999 年 Musk 將公司以 3 億 700 萬美元出售,寫下了當年網路產業有史以來最高的成交價。   出售 Zip2 的同年,Musk 從出售 Zip2 得到的錢中撥出一千萬美元投資成立線上金融服務公司 X.com。他想要利用新科技(例如 email)完成支付,並將自己創立的公司和競爭對手 Confinity 合併,後者正是 PayPay 的前身。然而經歷一些衝突後,Confinity 的共同創辦人將 Musk 從董事會中開除,並將公司名稱改為 PayPal,其後在 2002 年被 eBay 以 15 億美元收購。  

▲ PayPal 的商標。  
顛覆汽車產業的 Tesla   2003 年 Martin Eberhard 和 Marc Tarpenning 砸重金成立 Tesla,Musk 隨後加入公司的董事會。該公司推出的第一輛 Roadste 令人驚豔,不僅因為可以在四秒內從 0 加速到 60 英哩 / 每小時,更可以在單次充飽電後行駛 250 英哩。2008 年金融風暴後,Musk 取得公司主導的地位,並接下了 CEO 的職務。   2016 年 3 月,一輛售價 3.5 萬美元(約新台幣 110 萬元)的 Model 3 在全新預售時吸引了全球 32 萬筆以上的訂單。電動車的市場如火如荼發展下,Tesla 改採直銷的方式站在第一線和客戶交互動,並根據顧客回饋隨時修正市場方向。Musk 放話在 2018 年要達到年度出貨 50 萬輛以上的目標,有別於競爭對手使用的鋰電池,Tesla 電動車的電池是數千個普通電池聚合成,可以在行駛長程路線和短時間內加速等方面表現亮眼,其驚豔程度甚至打破了 Consumer Reports 的評比系統。  

 
▲Medel 3(Source:)    
Tesla 的未來發展關鍵:Model 3 能否在 2017 年如期交貨   Tesla 帶起一股電動車的潮流,自然也會吸引競爭對手的模仿。德國福特執行長對外表示他們正積極研發可以與 Model 3 匹敵的長程電動車,目標是每次充飽電可以行駛高達 200 英哩。不僅汽車大廠紛紛投入長程電動車的研發,電池蓄電能力的提升也是另一大技術關鍵。賓士母公司戴姆勒日前對外公開表示正在生產用於家用儲能的電池組,未來計劃販售給電力供應商或太陽能公司,結合太陽能電池儲存功能。這塊電動車大餅的瓜分潮也延燒到中國,其熱度不輸當年的 2000 年網路泡沫。   不過,Tesla 會帶來的是個實際的未來或是幻想呢?2016 年 Model 3 的預售掀起一股熱潮,一天內湧入了 11 萬筆訂單,預售第一周累積筆數高達 32 萬筆。不過 5 月 4 日公布的 2016 年第一季財報看來,雖然營收比去年同期增加 22%,但因為擴張階段帶來的高營業費用支出,以及 2017 年是否能如期交貨仍是個未知數,公司整體仍呈現虧損狀態。另外,預售時的簽訂合約也是個隱藏版玄機,消費者只要交付 1,000 美元,可在未來無條件解約拿回全額訂金。Tesla 的方面,只在合約中提及「可能在 2017 年交貨」,到時候若延至 2018 年或更更遙遠的時間點,趙文字敘述並未違反合約規定。Tesla 能否具足產能在 2017 年順利出貨,將會直接影響 Tesla 未來的發展。  
SpaceX:一手包辦設計、製造和發射火箭的公司   在 2002 年的最後,Musk 成立了 SpaceX,目標是讓火箭的價格變得平易近人。2012 年,SpaceX 推出的 Dragon 成為了第一個在國際太空站和地球間運送貨櫃的商業宇宙飛船。Musk 最終希望透過 Dragon 將人類送上外太空,並且計劃將人類送到火星殖民地。   經歷了 4 次的失敗,SpaceX 成功讓獵鷹 9 號火箭在發射太空梭到太空後,成功的降落在海上平台。Musk 近日對外宣布要在 2018 年登上火星,回顧 SpaceX 發展的光景,有以下的重大成就:

  1. SpaceX 為一家掌握了設計、製造和發送等製造流程的私人公司,正因為一條龍的供應鏈整合降低了成本,相對於一般需花費 4.6 億美元,SpaceX 的支出僅 9,000 萬美元。
  2. SpaceX 的獵鷹 9 號火箭由9 座 Merlin 1D 引擎建構,即使其中一座引擎在發射期間故障,不過火箭仍順利將運載的貨物成功送上太空完成任務。
  3. 第一家回收火箭的私人公司,完成發射衛星到地球軌道後,還能將獵鷹 9 號成功回收,這可是唯大做到的公司,是可相當大的創新壯舉。

SpaceX 公司員工數從 2002 年創立的 14 人,到現在已有 2,000 人,短時間人力資源速度增加之快令人佩服。近期 SpaceX 也獲得 NASA 的認可,拿下了運送太空人往返國際太空站的權利,預計最快 2017 年就能達成此目標。此外,也打敗了競爭對手聯合發射聯盟(United Launch Alliance)得到了軍事衛星的發射資格。台灣的福爾摩沙衛星五號將由 SpaceX 提供 Falcon 9 火箭,預計 2016 年第二季發射。  
SolarCity:太陽能乾淨能源系統的擁護者   Musk 長久以來就以支持永續和綠能科技聞名。為了讓 Tesla 可以保持在節省能源之流,他投資巨額在 SolarCity,一個由他的表兄弟 Lyndon 和 Peter Rive 成立安裝家戶太陽能的公司,目前 Musk 擔任該公司的主席。   SolarCity 設計和裝設太陽能乾淨能源系統,同時也監管和建構電動車充電站。2015 年 4 月,他宣布SloarCity 和 Tesla 的電池合作,推動太陽能電池後衛系統。同年底,Musk 對外宣稱通過 Renewable Energy Test Center(RETC)的測試,其太陽能板的轉換率高達 22.04%,勝過最大競爭對手 SunPower X 的 21.5% 轉換效率。   SolarCity 看好的前景,吸引 Google 投資 3 億美元協助開拓住宅太陽能市場。SolarCity 也大動作進軍非洲,或者與 Tesla、Nest 結盟,目標在缺乏能源的夏威夷推出自給自足的能源系統。然而,SolarCity 推出的家庭能源儲存系統的 10 Wh 容量 Powerwall 已在 2016 年 3 月悄悄下架,只留下號稱 7 Wh 的 6.4 Wh 版本,不禁讓外界質疑 Powerwall 的前景。  

▲ Powerwall 展示。(Source:)  
Hyperloop :未來交通系統樣貌的超迴路列車   超迴路列車(Hyperloop)是 Musk 著手的新計畫,一項可以加快兩地之間移動速度的交通系統。摩擦力是造成交通工具移動速度快慢的關鍵,Hyperloop 計劃以懸浮的運行方式,利用膠囊型的座艙載客,速度預計可以在 30 分鐘內橫跨越約 350 英里(約 560 公里)的距離,有可能超越飛機的飛行速度。不過這項運輸建設尚在計劃當中,相關的費用估計也存有爭議。

(首圖來源: CC BY 2.0)

(本文授權轉載自《》─〈〉)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※南投搬家前需注意的眉眉角角,別等搬了再說!

每賣一輛 Model S 特斯拉得賠超過 4,000 美元

美國豪華電動車廠特斯拉(Tesla)若以營業虧損來結算,每賣出一輛 Model S 電動汽車,就要賠超過 4,000 美元(約新台幣 12.7 萬元),上季特斯拉在豪華車的牛市燒掉 3.59 億美元。   特斯拉第 2 季交貨量為 1 萬 1,532 輛,營業虧損大約 4,700 萬美元,換算成每輛為虧損 4,000 美元左右。   特斯拉 5 日已削減今年與明年的生產目標。執行長馬斯克(Elon Musk)表示,他正在思考擴大募資的選項,且不排除脫手更多股票。  

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

從代碼的視角深入淺出理解DevOps

對於DevOps的理解大家眾說紛紜,就連維基百科(Wikipedia)都沒有給出一個統一的定義。一般的解釋都是從字面上來理解,就是把開發(Development)和運維(Operations)整合到一起,來加速產品從啟動到上線的過程,並使之自動化。這個是對DevOps的廣義解釋,而且大多數人都是認可的。但這個解釋太寬泛了,幾乎包括了IT的所有內容,使之沒有太大意義。 而DevOps是近幾年才興起的(2014年才開始流行),它是對某種項目模式的描述,是有着其特定內涵的。任何項目都可以分成開發和運維兩個部分,而開發的一整套流程和工具在DevOps之前早就有了,並沒有改變。

DevOps真正改變的是運維。因此從運維的角度去理解DevOps,才能抓住它的本質。你可以把它理解為用開發的方式做運維(Operation as Development),這就是對它的狹義的理解。 開發的方式就是寫代碼,換句話說DevOps就是通過寫代碼來做運維。運維里一個非常流行的概念叫“Iac()” 基礎設施即代碼,也就是把運行環境的創建用代碼的形式來描述出來,通過運行代碼來創建環境。它是運維領域的一場革命,開創了現代運維技術,它也是DevOps的基石。但基礎設施創建只是運維的一部分,如果我們把這場革命繼續延伸到運維的各個領域,讓代碼覆蓋整個運維,那時就是代碼即運維(Operation as Code),這才是DevOps的精髓。

那麼從一個應用程序項目的角度看,什麼是DevOps呢?它就是把應用程序的代碼和運維的代碼都放到一個源程序庫中,並對它進行版本管理,這樣你就擁有了關於這個項目的所有信息,隨時可以部署這個程序(包括程序本身和它的運行環境),而且可以保證每次創建出來的程序的運行結果是一樣的(因為它的運行環境也是一樣的)。

運維即代碼(Operation as Code):

下面我們就把運維所做的事情一件一件拆分開,看看他們是怎麼用代碼來實現的。

運維的工作通常包括下面幾個方面:

  • 基礎設施:即程序運行環境的創建和維護。
  • 持續部署:部署應用程序,並使整個過程自動化。
  • 服務的健壯性:是指當服務的的運行環境出現了問題,例如網絡故障或服務過載或某些微服務宕機的情況下,程序仍能夠提供部分或大部分服務。
  • 運行監測:它既包含對程序的監測也包含對運行環境的監測。

基礎設施即代碼 (Infrastructure as code)

我們通過一個Go(別的語言也大同小異)微服務程序做例子來展示如何用代碼來創建基礎設施。程序本身的功能非常簡單,只是用SQL語句訪問數據庫中的數據,並寫入日誌。你可以簡單地把它分成兩層,後端數據訪問層和數據庫層。程序的部署環境是基於k8s的容器環境。在k8s中它被分成兩個服務。一個是後端程序服務,另一個是數據庫(用MySQL)服務。後端程序要調用數據庫服務,然後會把一些數據寫入日誌。

在這種新的模式下,運行環境的代碼和應用程序的代碼是存在一個源碼庫中的,這樣當你下載了源碼庫之後,你不但擁有了程序的所有源碼,而且也擁有了運行環境的源碼。這樣當要創建新的運行環境時,只要運行一遍代碼就能創建出整套的運行環境,而且每次創建出來的環境都是一致的。

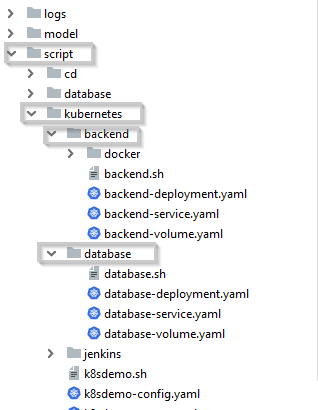
上面就是這個Go程序的目錄結構,它裏面有一個目錄“script”是專門存放與運行環境相關的文件的,裏面的“kuburnetes”子目錄就是整個運行環境的代碼。除了“script”之外的其它目錄存有應用程序的代碼。這樣,與這個應用程序有關的信息都以代碼的方式保存在了一個源代碼庫。有了它之後,你可以隨時部署出一個相同的程序的運行環境,而且保證是一模一樣的。

“kubernetes”目錄下有兩個子目錄“backend”和“database”分別存放後端程序和數據庫的配置文件。它們內部的結構是類似的,都有三個“yaml”文件:

  • backend-deployment.yaml:部署配置文件,
  • backend-service.yaml:服務配置文件
  • backend-volume.yaml:持久卷配置文件.

另外還有一個“.sh”文件是它的運行命令,當你運行這個shell文件時,它就調用上面三個k8s配置文件來創建運行環境。

kubernetes目錄的最外層有兩個“yaml”文件“k8sdemo-config.yaml”和”k8sdemo-secret.yaml”,它們是用來創建k8s運行環境參數的,因為它們是被不同服務共享的,因此放在最外層。另外還有一個”k8sdemo.sh”文件是k8s命令文件,用來創建k8s對象。

這種源程序結構的一個好處就是使應用程序和它的運行環境能夠更好地集成。舉個例子,當你要修改服務的端口時,以前,你需要在運行環境和源碼里分別修改,但它是分別由開發和運維完成的,這很容易造成修改的不同步。當你把它們放在同一個源碼庫中,只需要修改一個地方,這樣就保證了應用程序和運行環境的一致性。

下面就是後端服務的k8s配置代碼:

apiVersion: v1
kind: Service
metadata:
  name: k8sdemo-backend-service
  labels:
    app: k8sdemo-backend
spec:
  type: NodePort
  selector:
    app: k8sdemo-backend
  ports:
    - protocol : TCP
      nodePort: 32080
      port: 80
      targetPort: 8080

由於篇幅的關係,這裏就不詳細解釋程序了,有興趣的請參見.

基礎設施可以分成兩個層面,一個就是上面講到的k8s層面,也就是容器層面,這個是跟應用程序緊密相關的。還有一個層面就是容器下面的支持層,也就是虛機層面,當然還包括網絡,負載均衡等設備或軟件。當你在阿里雲或華為雲上創建k8s之前,先要把這些構建好才行。它的部署也可以用代碼來完成。Terraform就是一款非常流行的用來完成創建的工具,它是被ThoughtWorks推薦的(詳見 ),它支持用代碼來創建虛機。

代碼如下:

resource "aws_instance" "example" {
  count         = 10
  ami           = "ami-v1"
  instance_type = "t2.micro"
}

但在這一層面,基礎設施的工作與應用程序的關聯並沒有那麼緊密,因此這部分的代碼沒有放在應用程序里,你可以單獨創建一個基礎設施的源碼項目,用來存放這部分代碼。

持續部署(Continuous Deployment)

部署應用程序是運維的一項重要工作。隨着商業競爭的加劇,要求更快的程序更新,從原來的的幾周部署一次,到後來的一天部署十幾次甚至幾十次。這樣手工部署就完全不能滿足需要,於是就要把整個流程自動化,這就是持續部署。

管線(pipeline)是一個很重要的概念,它用來描述持續部署的整個步驟和流程。Jenkin是一款非常流行的持續集成和部署工具,它提出了“管線即代碼”(“Pipeline as code”,詳見)。就是把持續部署的管線也作為程序源碼的一部分,和應用程序一起管理起來,讓它有着和應用程序一樣的版本和複審流程。

下面我們就通過一個具體例子來說明他是怎樣實現的。這個例子用的是和上面一樣的程序。先來看一下程序的目錄結構。

與持續部署相關的文件都在“script”目錄下,他被分成兩部分,一個是“cd”子目錄,它存有Jenkins的管線,另一個是“Kubernetes”下的“jenkins”子目錄,它存有Jenkinsde的k8s配置文件。你如果仔細看一下的話會發現它裏面的文件和前面講到的後端程序和數據庫的k8s配置文件很相似,有了它,你就可以在k8s里創建出Jenkins的運行環境。

這裏我把Jenkins的k8s配置文件也放在應用程序里了,但實際上它是應該放在前面提到的基礎設施項目源碼里。因為Jenkins是被應用程序共享的,而不是屬於單獨的一個應用。這裏為了說明方便放在一起了,真正用的時候要把它抽取出來。

下面就是管線的代碼:

def POD_LABEL = "k8sdemopod-${UUID.randomUUID().toString()}"
podTemplate(label: POD_LABEL, cloud: 'kubernetes', containers: [
    containerTemplate(name: 'modified-jenkins', image: 'jfeng45/modified-jenkins:1.0', ttyEnabled: true, command: 'cat')
  ],
  volumes: [
     hostPathVolume(mountPath: '/var/run/docker.sock', hostPath: '/var/run/docker.sock')
  ]) {

    node(POD_LABEL) {
       def kubBackendDirectory = "/script/kubernetes/backend"
       stage('Checkout') {
            container('modified-jenkins') {
                sh 'echo get source from github'
                git 'https://github.com/jfeng45/k8sdemo'
            }
          }
       stage('Build image') {
            def imageName = "jfeng45/jenkins-k8sdemo:${env.BUILD_NUMBER}"
            def dockerDirectory = "${kubBackendDirectory}/docker/Dockerfile-k8sdemo-backend"
             container('modified-jenkins') {
               withCredentials([[$class: 'UsernamePasswordMultiBinding',
                 credentialsId: 'dockerhub',
                 usernameVariable: 'DOCKER_HUB_USER',
                 passwordVariable: 'DOCKER_HUB_PASSWORD']]) {
                 sh """
                   docker login -u ${DOCKER_HUB_USER} -p ${DOCKER_HUB_PASSWORD}
                   docker build -f ${WORKSPACE}${dockerDirectory} -t ${imageName} .
                   docker push ${imageName}
                   """
               }
             }
           }
       stage('Deploy') {
           container('modified-jenkins') {
               sh "kubectl apply -f ${WORKSPACE}${kubBackendDirectory}/backend-deployment.yaml"
               sh "kubectl apply -f ${WORKSPACE}${kubBackendDirectory}/backend-service.yaml"
             }
       }
    }
}

由於篇幅的關係,這裏不詳細解釋。如果有興趣並想了解如何運行Jenkins來完成持續部署,請參閱 .

這裏我用的是Jenkins軟件,它另外還有一個子項目叫Jenkins-x,是專門為k8s環境量身打造的,它的主要功能是能夠幫助你自動生成管線代碼(你需要回答他的一些問題)。如果你不想自己寫代碼,那麼你可以試一下它,詳情請見。

服務的韌性(Service Resilience as Code)

又叫服務的健壯性,這部分不像前面兩個部分有着公認的名字,英文叫“Service Resilience”,翻譯成中文就五花八門了,我覺得叫服務的韌性比較合適。

“Service Resilience”是指當服務的的運行環境出現了問題,例如網絡故障或服務過載或某些微服務宕機的情況下,程序仍能夠提供部分或大部分服務,這時我們就說服務的韌性很強。它是衡量服務質量的一個重要指標。

這部分的功能包括下面幾個部分:

  • 服務超時 (Timeout)
  • 服務重試 (Retry)
  • 服務限流(Rate Limiting)
  • 熔斷器 (Circuit Breaker)
  • 故障注入(Fault Injection)
  • 艙壁隔離技術(Bulkhead)

這部分與前面兩個部分略有不同,前面兩個部分都是典型的運維任務,而這部分以前是應用程序的一部分,只是這些年才慢慢開始轉移到運維的。

最開始的時候,這些功能都是和程序的業務邏輯混在一起,對業務邏輯的侵入很大,後來,大家開始把這部分邏輯抽取出來,劃分成單獨的一部分。下面通過一個具體的例子(Go微服務程序)來講解:

上圖是程序的目錄結構,它分為客戶端(client)和服務端(server),它們的內部結構是類似的。“middleware”包是實現服務韌性功能的包。 “service”包是業務邏輯包,在服務端就是微服務的實現函數,在客戶端就是調用服務端的函數。在客戶端(client)下的“middleware”包中包含四個文件並實現了三個功能:服務超時,服務重試和熔斷器。“clientMiddleware.go”是總入口。在服務端(server)下的“middleware”包中包含了兩個文件並實現了一個功能,服務限流。“serverMiddleware.go”是總入口。

注意,這裏的服務韌性的功能是完全從業務邏輯中抽出來了,對業務邏輯沒有任何侵入,它是在一個單獨的包(middleware)里實現的。這裏用的是修飾模式。有關程序實現的詳情,請參閱。

上面講的是用程序來實現這些功能,但從本質上來講這些功能不應該屬於應用程序,而是應該由基礎設施來完成。現在公認的看法是,服務網格(Service Mesh)是完成這些功能的最佳方案。使用服務網格的方式和k8s類似,也是創建配置文件,然後通過運行配置文件來建立服務網格的運行環境。我們這裏用Istio來舉例說明,Istio是一款非常流行的服務網格軟件。

上圖就是下載的Istio軟件的目錄,“bookinfo”是它的一個示例程序,在這個例子里,它展示了多種使用Istio的方式,其中就有如何實現服務韌性的方法。詳情請參見.

運行監測 (Monitoring or Observability)

運行監測是運維的一項重要內容,它通常包含如下幾個方面的內容:

  • 日誌(logging): 記錄的是程序運行過程中的信息
  • 跟蹤(tracing): 記錄的是與一條請求相關的信息,特別是請求的與時間有關的信息。
  • 指標(metrics): 與上面的離散的信息不同,這裏記錄的是可累加的信息,一般是按照時間軸進行累加。

我們經常稱之為觀測的三個支柱(Three Pillars of Observabilty),有一篇很不錯的講解它們之間關係的文章,詳情請見””。

這部分的內容可能會有些爭議。因為前幾個部分都是清清楚楚的運維工作,即使服務韌性, 雖然以前是開發的工作,但現在也已經一直公認是運維的事,而且它們的代碼都能很乾凈的摘出來。但運行監測不一樣,雖然主要工作還是由運維來完成,但它的代碼與業務邏輯代碼混在一起,很難摘得清楚。

日誌:

這部分的代碼都是在應用程序里,但日誌的採集,匯總,分析和展示都是由運維來完成。它的代表就是著名的ELK系列。採用DevOps之後,這裏面的變化不大,頂多就是採集代理(Agent)更好地和服務網格或k8s進行集成,使之變得更為容易。

分佈式跟蹤:

這部分有點像服務韌性,開始的時候是由程序完成,慢慢地把它變成單獨的部分與應用程序隔離開,最終大部分的工作交由服務網格來完成。但它又與服務韌性不太相同。服務韌性可以和應用程序做一個非常乾淨的切割,而分佈式跟蹤取決於跟蹤的顆粒度。如果僅是服務之間的跟蹤,就一點問題都沒有,完全可以由服務網格來完成。但如果是服務內部的跟蹤,服務網格就無能為力了,還是要由程序代碼來完成,就像日誌一樣。但我覺得服務之間的跟蹤是投入產出比最高的,大多數情況下有它就足夠了,不必需要服務內部的跟蹤。

詳細情況請參見

Metrics:

這部分觀測的是累加信息。大多數情況下,只要安裝好工具,就能採集數據進行分析。最流行的工具是Prometheus. 你不需要寫代碼來獲取數據,不過你如果想要快速地找到需要的信息,k8s的配置還是要和Prometheus的設置相匹配,因此你需要做一些詳細的設計。詳細情況請參見。

當然你如果有一些更細緻的監測需求,Prometheus不能直接滿足。這時需要在應用程序里插入一些Prometheus的監測代碼來滿足你的需要。

其他工作

是不是還有其他運維工作被漏掉了?

持續集成(Continious Integration)

很多人都把持續集成(CI)算作DevOps的重要組成部分,那是因為他用的是廣義的定義。按照狹義的理解,DevOps只包括運維的內容。持續集成(CI)與持續部署(CD)有着明顯的不同,持續集成是開發的工作,而持續部署是運維的工作,下圖展示了它們的差異。

如圖所示,整個流程是這樣的:
程序員從源碼庫(Source Control)中下載源代碼,編寫程序,完成后提交代碼到源碼庫,持續集成(Continuous Integration)工具從源碼庫中下載源代碼,編譯源代碼,然後提交到運行庫(Repository),然後持續交付(Continuous Delivery)工具從運行庫(Repository)中下載代碼,生成發布版本,併發布到不同的運行環境(例如DEV,QA,UAT, PROD)。

圖中,左邊的部分是持續集成,它主要跟開發和程序員有關;右邊的部分是持續部署,它主要跟測試和運維有關。持續交付(Continuous Delivery)又叫持續部署(Continuous Deployment),它們如果細分的話還是有一點區別的,但我們這裏不分得那麼細,統稱為持續部署

我並沒有把持續集成放到DevOps裏面,因為本文用的是狹義的解釋,也就是只包含運維的部分。

結論

本文從代碼的視角詮釋了對DevOps的理解,DevOps的精髓就是用寫代碼的方式來做運維,並對運維的各個部分給出了具體的實例,希望能對想採用DevOps的朋友有所幫助。DevOps對開發和運維的改變都是巨大的,尤其是對運維。在不久的將來,就沒有開發和運維之分了,只有一個工作,就是寫代碼,當然也許會細分成開發碼農和運維碼農。運維的工作都是通過寫代碼來完成。應用程序里不但包括業務邏輯的代碼,也包括運維的代碼,它們會被同時存儲在一個源碼庫中。

源碼庫

完整源碼的github鏈接:

索引:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

Java基礎系列6:深入理解Java異常體系

該系列博文會告訴你如何從入門到進階,一步步地學習Java基礎知識,並上手進行實戰,接着了解每個Java知識點背後的實現原理,更完整地了解整個Java技術體系,形成自己的知識框架。


前言:

Java的基本理念是“結構不佳的代碼不能運行”。

“異常”這個詞有“我對此感到意外”的意思。問題出現了,你也許不清楚該如何處理,但你的確知道不應該置之不理;你要停下來,看看是不是有別人或在別的地方,能夠處理這個問題。只是在當前的環境中還沒有足夠的信息來解決這個問題,所以就把這個問題提交到一個更高級別的環境中,在這裏將作出正確的決定。

使用異常所帶來的另一個相當明顯的好處是,它往往能夠降低錯誤處理代碼的複雜度。如果不使用異常,那麼就必須檢查特定的錯誤,並在程序中的許多地方去處理它。而如果使用異常,那就不必在方法調用處進行檢查,因為異常機制將保證能夠捕獲這個錯誤。並且,只需在一個地方處理錯誤,即所謂的異常處理程序中。這種方式不僅節省代碼,而且把“描述在正常執行過程中做什麼事”的代碼和“出了問題怎麼辦”的代碼相分離。總之,與以前的錯誤處理方法相比,異常機制使代碼的閱讀、編寫和調試工作更加井井有條。


異常概述:

現在我們需要編寫一個五子棋程序,當用戶輸入下期坐標時,程序要判斷用戶輸入是否合法,如果保證程序有較好的容錯性,將會有如下的代碼(偽代碼):

if(用戶輸入包含除逗號之外的其他非数字字符)
{
	alert 坐標只能是數值
	goto retry
}
else if(用戶輸入不包含逗號) {
	alert 應使用逗號分隔兩個坐標值
	goto retry
}

else if(用戶輸入坐標值超出了有效範圍) {
	alert 用戶輸入坐標應位於棋盤坐標之內
	goto retry
}

else if(用戶輸入的坐標已有棋子)
{
	alert 只能在沒有棋子的地方下棋
	goto retry
}
else {
	.....
}


上面代碼還未涉及任何有效處理,只是考慮了4種可能的錯誤,代碼就已經急劇增加了。但實際上,上面考慮的4種情形還遠未考慮到所有的可能情形(事實上,世界上的意外是不可窮舉的),程序可能發生的異常情況總是大於程序員所能考慮的意外情況。

對於上面的錯誤處理機制,主要有以下兩個缺點:

  • 無法窮舉所有的異常情況。因為人類知識的限制,異常情況總比可以考慮到的情況多,總有“漏網之魚”的異常情況,所以程序總是不夠健壯。
  • 錯誤處理代碼和業務實現代碼混雜。這種錯誤處理和業務實現混雜的代碼嚴重影響程序的可讀性,會增加程序維護的難度。

我們希望有這樣一種處理機制:

if(用戶輸入的數據不合法){
    .....
}else{
   處理邏輯
   .....  
}


上面偽碼提供了一個非常強大的“if塊”——程序不管輸入錯誤的原因是什麼,只要用戶輸入不滿足要求,程序就一次處理所有的錯誤。這種處理方法的好處是,使得錯誤處理代碼變得更有條理,只需在一個地方處理錯誤。

這就需要用到java異常了。


異常是程序中的一些錯誤,但並不是所有的錯誤都是異常,並且錯誤有時候是可以避免的。

比如說,你的代碼少了一個分號,那麼運行出來結果是提示是錯誤java.lang.Error;如果你用System.out.println(11/0),那麼你是因為你用0做了除數,會拋出java.lang.ArithmeticException的異常。

異常發生的原因有很多,通常包含以下幾大類:

  • 用戶輸入了非法數據。
  • 要打開的文件不存在。
  • 網絡通信時連接中斷,或者JVM內存溢出。


Java中的異常有以下三種類型:

檢查異常:最具代表的檢查性異常是用戶錯誤或問題引起的異常,這是程序員無法預見的。例如要打開一個不存在文件時,一個異常就發生了,這些異常在編譯時不能被簡單地忽略。

運行異常:運行時異常是可能被程序員避免的異常。與檢查性異常相反,運行時異常可以在編譯時被忽略。

錯誤:錯誤不是異常,而是脫離程序員控制的問題。錯誤在代碼中通常被忽略。例如,當棧溢出時,一個錯誤就發生了,它們在編譯也檢查不到的。


異常的體繫結構:

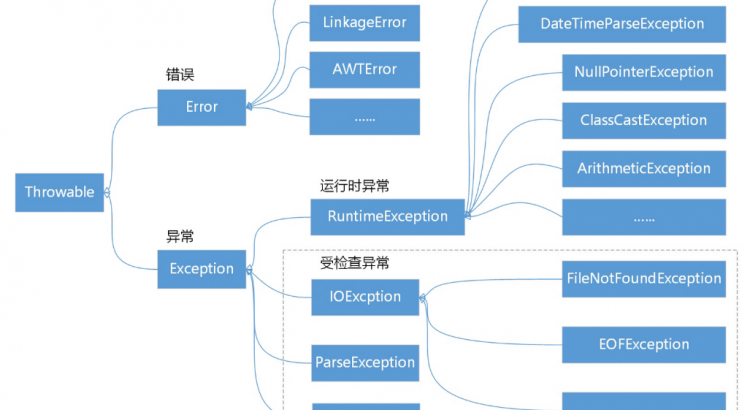
我們先來統觀以下Java的異常體繫結構圖:


Java的異常被分為兩大類:Checked異常和Runtime異常(運行時異常)。所有的RuntimeException類及其子類的實例被稱為Runtime異常;不是RuntimeException類及其子類的異常實例則被稱為Checked異常。

只有Java語言提供了Checked異常,其他語言都沒有提供Checked異常。Java認為Checked異常都是可以被處理(修復)的異常,所以Java程序必須顯式處理Checked異常。如果程序沒有處理Checked異常,該程序在編譯時就會發生錯誤,無法通過編譯。


Throwable:

Java異常的頂級類,所有的類都繼承自Throwable

Error:

Error錯誤,一般是指與虛擬機相關的問題,如系統崩潰、虛擬機錯誤、動態鏈接失敗等,這種錯誤無法恢復或不可能捕獲,將導致應用程序中斷。通常應用程序無法處理這些錯誤,因此應用程序不應該試圖使用catch 塊來捕獲Error對象。
在定義該方法時,也無須在其throws子句中聲明該方法可能拋出Error及其任何子類。


Exception:

Exception中異常主要分為兩大類,運行時異常和檢查異常。常見的運行時異常有ArrayIndexOutOfBoundsException(數組下標越界)、NullPointerException(空指針異常)、ArithmeticException(算術異常)、ClassNotFoundException(類型找不到),這些異常時非檢查異常,程序可以選擇處理,也可以不處理,編譯器編譯時期並不會報錯。這些異常一般是由於程序邏輯錯誤引起的,所以建議程序員還是處理一下。除運行時異常外的所有異常我們都稱為非運行時異常,也是必須處理的異常,如果不出來,程序編譯會報錯。


Error和Exception的區別:

Error和Exception的區別:Error通常是災難性的致命的錯誤,是程序無法控制和處理的,當出現這些異常時,Java虛擬機(JVM)一般會選擇終止線程;Exception通常情況下是可以被程序處理的,並且在程序中應該盡可能的去處理這些異常。


檢查異常:必須處理的異常

除了RuntimeException及其子類以外,其他的Exception類及其子類都屬於檢查異常,當程序中可能出現這類異常,要麼使用try-catch語句進行捕獲,要麼用throws子句拋出,否則編譯無法通過。


非檢查異常:可以不處理

包括RuntimeException及其子類和Error。

不受檢查異常為編譯器不要求強制處理的異常,檢查異常則是編譯器要求必須處置的異常。


異常處理機制:

Java的異常處理機制可以讓程序具有極好的容錯性,讓程序更加健壯。當程序運行出現意外情形時,系統會自動生成一個Exception對象來通知程序,從而實現將“業務功能實現代碼”和“錯誤處理代碼”分離,提供更好的可讀性。

java異常關鍵字:

  • try – 用於監聽。try后緊跟一個花括號括起來的代碼塊(花括號不可省略),簡稱try塊,它裏面放置可能引發異常的代碼,當try語句塊內發生異常時,異常就被拋出。【監控區域】
  • catch – 用於捕獲異常。catch后對應異常類型和一個代碼塊,用於處理try塊發生對應類型的異常。【異常處理程序】
  • finally – 用於清理資源,finally語句塊總是會被執行。 多個catch塊后還可以跟一個finally塊,finally塊用於回收在try塊里打開的物理資源(如數據庫連接、網絡連接和磁盤文件)。只有finally塊執行完成之後,才會回來執行try或者catch塊中的return或者throw語句,如果finally中使用了return或者throw等終止方法的語句,則就不會跳回執行,直接停止。【使用finally進行清理】
  • throw – 用於拋出一個實際的異常。throw可以單獨作為語句使用,拋出一個具體的異常對象。【拋出異常】
  • throws –用在方法簽名中,用於聲明該方法可能拋出的異常。【異常說明】


1、使用try…catch捕獲異常:

語法格式:

try{
   //業務實現代碼
   ...
}catch(Exception e){
  //異常處理代碼
  ...
}


如果執行try塊里的業務邏輯代碼時出現異常,系統自動生成一個異常對象,該異常對象被提交給Java運行時環境,這個過程被稱為拋出(throw)異常。

當Java運行時環境收到異常對象時,會尋找能處理該異常對象的catch塊,如果找到合適的catch塊,則把該異常對象交給該catch塊處理,這個過程被稱為捕獲(catch)異常;如果Java運行時環境找不到捕獲異常的catch塊,則運行時環境終止Java程序也將退出。

下面看幾個簡單的異常捕獲的例子:

例1:

public class DivTest {
	
	public static void main(String[] args) {
		try {
			int a=Integer.parseInt(args[0]);
			int b=Integer.parseInt(args[1]);
			int c=a/b;
			System.out.println("您輸入的兩個數相除的結果是"+c);
		}catch(IndexOutOfBoundsException e) {
			System.out.println("數組越界,運行時參數不夠");
		}catch(NumberFormatException e) {
			System.out.println("数字格式異常");
		}catch(ArithmeticException e) {
			System.out.println("算術異常");
		}catch(Exception e) {
			System.out.println("未知異常");
		}
	}

}


  • 如果運行該程序時輸入的參數不夠,將會發生數組越界異常,Java運行時將調用IndexOutOfBoundsException對應的catch塊處理該異常。
  • 如果運行該程序時輸入的參數不是数字,而是字母,將發生数字格式異常,Java運行時將調用NumberFormatException 對應的catch塊處理該異常。
  • 如果運行該程序時輸入的第二個參數是0,將發生除0異常,Java運行時將調用ArithmeticException對應的catch塊處理該異常。
  • 如果程序運行時出現其他異常,該異常對象總是Exception類或其子類的實例,Java運行時將調用Exception對應的catch塊處理該異常。

上面程序中的三種異常是我們在編程中經常遇見的,讀者應該掌握這些異常。

例2:

import java.util.Date;


public class Test {
	
	public static void main(String[] args) {
		Date d=null;
		try {
			System.out.println(d.after(new Date()));
		}catch(NullPointerException e) {
			System.out.println("空指針異常");
		}catch(Exception e) {
			System.out.println("未知異常");
		}
	}

}


上面程序針對NullPointerException異常提供了專門的異常處理塊。上面程序調用一個null對象的after0方法,這將引發NullPointerException異常(當試圖調用一個null對象的實例方法或實例變量時,就會引發NullPointerException異常),Java 運行時將會調用NullPointerException對應的catch塊來處理該異常;如果程序遇到其他異常,Java運行時將會調用最後的catch塊來處理異常。

catch塊處理異常遵循着:先小后大,即先子類後父類。正如在前面程序所看到的,程序總是把對應Exception類的catch塊放在最後,這是為什麼呢?讀者可能明白原因:如果把Exception類對應的catch塊排在其他catch塊的前面,Java運行時將直接進入該catch塊(因為所有的異常對象都是Exception或其子類的實例),而排在它後面的catch塊將永遠也不會獲得執行的機會。


多異常捕獲:

在Java7之前,每個catch塊只能捕獲一個異常,Java7之後,每個catch塊可以捕獲多種類型的異常。

上面的例1可以改成如下代碼實現:

public class Test {
	
	public static void main(String[] args) {
		try {
			int a=Integer.parseInt(args[0]);
			int b=Integer.parseInt(args[1]);
			int c=a/b;
			System.out.println("您輸入的兩個數相除的結果是"+c);
		}catch(IndexOutOfBoundsException|NumberFormatException|ArithmeticException e) {
			System.out.println("數組越界,数字格式異常,算術異常");
		}catch(Exception e) {
			System.out.println("未知異常");
		}
	}

}


2、使用throws聲明拋出異常:

使用throws聲明拋出異常的思路是,當前方法不知道如何處理這種類型的異常,該異常應該由上一級調用者處理;如果main方法也不知道如何處理這種類型的異常,也可以使用throws聲明拋出異常,該異常將交給JVM處理。JVM對異常的處理方法是,打印異常的跟蹤棧信息,並中止程序運行,這就是前面程序在遇到異常后自動結束的原因。

import java.io.FileInputStream;
import java.io.FileNotFoundException;

public class Test {
	
	public static void main(String[] args) throws FileNotFoundException {
		FileInputStream fis=new FileInputStream("a.txt");
	}

}


上面程序聲明不處理IOException異常,將該異常交給JVM處理,所以程序一旦遇到該異常,JVM就會打印該異常的跟蹤棧信息,並結束程序。運行上面程序,會看到如下圖所示的運行結果。


3、使用throw拋出異常:

public class Test {
	
	public static void main(String[] args) throws Exception {
		try {
			int a=Integer.parseInt(args[0]);
			int b=Integer.parseInt(args[1]);
			int c=a/b;
			if(b==0) {
				throw new Exception("除數不能為0");
			}
			System.out.println("您輸入的兩個數相除的結果是"+c);
		}catch(Exception e) {
			System.out.println("未知異常");
		}
	}

}


上面程序中粗體字代碼使用throw語句來自行拋出異常。當Java運行時接收到開發者自行拋出的異常時,同樣會中止當前的執行流,跳到該異常對應的catch塊,由該catch塊來處理該異常。也就是說,不管是系統自動拋出的異常,還是程序員手動拋出的異常,Java運行時環境對異常的處理沒有任何差別。


4、訪問異常信息:

如果程序需要在catch塊中訪問異常對象的相關信息,則可以通過訪問catch塊的后異常形參來獲得。當Java運行時決定調用某個catch塊來處理該異常對象時,會將異常對象賦給catch塊后的異常參數,程序即可通過該參數來獲得異常的相關信息。

所有的異常對象都包括如下幾個常用的方法:

getMessage():返回該異常信息的跟蹤棧信息輸出到標準錯誤輸出

printStackTrace():將該異常的跟蹤棧信息輸出到標準錯誤輸出。

printStackTrace(PrintStream s):將該異常的跟蹤棧信息輸出到指定輸出流。

getStackTrace():返回該異常的跟蹤棧信息。


5、使用finally回收資源:

有些時候,程序在try塊里打開了一些物理資源(例如數據庫連接、網絡連接和磁盤文件),這些物理資源都必須显示回收。

在哪裡回收這些物理資源呢?在try塊里回收?還是在catch塊中進行回收?假設程序在try塊里進行資源回收,根據圖10.1所示的異常捕獲流程—一如果try塊的某條語句引起了異常,該語句后的其他語句通常不會獲得執行的機會,這將導致位於該語句之後的資源回收語句得不到執行。如果在catch塊里進行資源回收,但catch塊完全有可能得不到執行,這將導致不能及時回收這些物理資源。

為了保證一定能回收try塊中打開的物理資源,異常處理機制提供了finally塊。不管try塊中的代碼是否出現異常,也不管哪一個catch塊被執行,甚至在try塊或catch塊中執行了return語句,finally塊總會被執行。完整的Java異常處理語法結構如下:

try{
  //業務實現代碼
  ...
}catch(SubException e){
  //異常處理塊
  ...
}catch(SubException e2){
   //異常處理塊
   ...
}finally{
   //資源回收
   ...
}


例如:

public class Test {
	
	public static void main(String[] args) throws Exception {
		try {
			int a=10;
			int b=0;
			int c=a/b;
		}catch(Exception e) {
			System.out.println("未知異常");
		}finally {
			System.out.println("資源回收");
		}
	}

}


結果:

未知異常
資源回收


總結:


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

mysql 排它鎖之行鎖、間隙鎖、后碼鎖

MySQL InnoDB支持三種行鎖定

  • 行鎖(Record Lock):鎖直接加在索引記錄上面,鎖住的是key。

  • 間隙鎖(Gap Lock):鎖定索引記錄間隙,確保索引記錄的間隙不變。間隙鎖是針對事務隔離級別為可重複讀或以上級別而設計的。

  • 后碼鎖(Next-Key Lock):行鎖和間隙鎖組合起來就叫Next-Key Lock。

默認情況下,InnoDB工作在可重複讀隔離級別下,並且會以Next-Key Lock的方式對數據行進行加鎖,這樣可以有效防止幻讀的發生。Next-Key Lock是行鎖和間隙鎖的組合,當InnoDB掃描索引記錄的時候,會首先對索引記錄加上行鎖(Record Lock),再對索引記錄兩邊的間隙加上間隙鎖(Gap Lock)。加上間隙鎖之後,其他事務就不能在這個間隙修改或者插入記錄。

行鎖(Record Lock)

  • 當需要對表中的某條數據進行寫操作(insert、update、delete、select for update)時,需要先獲取記錄的排他鎖(X鎖),這個就稱為行鎖。
create table x(`id` int, `num` int, index `idx_id` (`id`));
insert into x values(1, 1), (2, 2);

-- 事務A
START TRANSACTION;
update x set id = 1 where id = 1;

-- 事務B
-- 如果事務A沒有commit,id=1的記錄拿不到X鎖,將出現等待
START TRANSACTION;
update x set id = 1 where id = 1;

-- 事務C
-- id=2的記錄可以拿到X鎖,不會出現等待
START TRANSACTION;
update x set id = 2 where id = 2;
  • 針對InnoDB RR隔離級別,上述SQL示例展示了行鎖的特點:“鎖定特定行不允許進行修改”,但行鎖是基於表索引的,如果where條件中用的是num字段(非索引列)將產生不一樣的現象:
-- 事務A
START TRANSACTION;
update x set num = 1 where num = 1;

-- 事務B
-- 由於事務A中num字段上沒有索引將產生表鎖,導致整張表的寫操作都會出現等待
START TRANSACTION;
update x set num = 1 where num = 1;

-- 事務C
-- 同理,會出現等待
START TRANSACTION;
update x set num = 2 where num = 2;

-- 事務D
-- 等待
START TRANSACTION;
insert into x values(3, 3);

Gap鎖(Gap Lock)

在MySQL中select稱為快照讀,不需要鎖,而insert、update、delete、select for update則稱為當前讀,需要給數據加鎖,幻讀中的“讀”即是針對當前讀。

RR事務隔離級別允許存在幻讀,但InnoDB RR級別卻通過Gap鎖避免了幻讀

產生間隙鎖的條件(RR事務隔離級別下)

  • 使用普通索引鎖定
  • 使用多列唯一索引
  • 使用唯一索引鎖定多行記錄

唯一索引的間隙鎖

測試環境

MySQL,InnoDB,默認的隔離級別(RR)

數據表

CREATE TABLE `test` (
  `id` int(1) NOT NULL AUTO_INCREMENT,
  `name` varchar(8) DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

數據

INSERT INTO `test` VALUES ('1', '小羅');
INSERT INTO `test` VALUES ('5', '小黃');
INSERT INTO `test` VALUES ('7', '小明');
INSERT INTO `test` VALUES ('11', '小紅');

以上數據,會生成隱藏間隙

(-infinity, 1]
(1, 5]
(5, 7]
(7, 11]
(11, +infinity]

只使用記錄鎖,不會產生間隙鎖

/* 開啟事務1 */
BEGIN;
/* 查詢 id = 5 的數據並加記錄鎖 */
SELECT * FROM `test` WHERE `id` = 5 FOR UPDATE;
/* 延遲30秒執行,防止鎖釋放 */
SELECT SLEEP(30);

-- 注意:以下的語句不是放在一個事務中執行,而是分開多次執行,每次事務中只有一條添加語句

/* 事務2插入一條 name = '小張' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (4, '小張'); # 正常執行

/* 事務3插入一條 name = '小張' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (8, '小東'); # 正常執行

/* 提交事務1,釋放事務1的鎖 */
COMMIT;

以上,由於主鍵是唯一索引,而且是只使用一個索引查詢,並且只鎖定一條記錄,所以,只會對 id = 5 的數據加上記錄鎖,而不會產生間隙鎖。

產生間隙鎖

/* 開啟事務1 */
BEGIN;
/* 查詢 id 在 7 - 11 範圍的數據並加記錄鎖 */
SELECT * FROM `test` WHERE `id` BETWEEN 5 AND 7 FOR UPDATE;
/* 延遲30秒執行,防止鎖釋放 */
SELECT SLEEP(30);

-- 注意:以下的語句不是放在一個事務中執行,而是分開多次執行,每次事務中只有一條添加語句

/* 事務2插入一條 id = 3,name = '小張1' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (3, '小張1'); # 正常執行

/* 事務3插入一條 id = 4,name = '小白' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (4, '小白'); # 正常執行

/* 事務4插入一條 id = 6,name = '小東' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (6, '小東'); # 阻塞

/* 事務5插入一條 id = 8, name = '大羅' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (8, '大羅'); # 阻塞

/* 事務6插入一條 id = 9, name = '大東' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (9, '大東'); # 阻塞

/* 事務7插入一條 id = 11, name = '李西' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (11, '李西'); # 阻塞

/* 事務8插入一條 id = 12, name = '張三' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (12, '張三'); # 正常執行

/* 提交事務1,釋放事務1的鎖 */
COMMIT;

從上面我們可以看到,(5, 7]、(7, 11] 這兩個區間,都不可插入數據,其它區間,都可以正常插入數據。所以當我們給 (5, 7] 這個區間加鎖的時候,會鎖住 (5, 7]、(7, 11] 這兩個區間。

鎖住不存在的數據

/* 開啟事務1 */
BEGIN;
/* 查詢 id = 3 這一條不存在的數據並加記錄鎖 */
SELECT * FROM `test` WHERE `id` = 3 FOR UPDATE;
/* 延遲30秒執行,防止鎖釋放 */
SELECT SLEEP(30);

-- 注意:以下的語句不是放在一個事務中執行,而是分開多次執行,每次事務中只有一條添加語句

/* 事務2插入一條 id = 3,name = '小張1' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (2, '小張1'); # 阻塞

/* 事務3插入一條 id = 4,name = '小白' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (4, '小白'); # 阻塞

/* 事務4插入一條 id = 6,name = '小東' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (6, '小東'); # 正常執行

/* 事務5插入一條 id = 8, name = '大羅' 的數據 */
INSERT INTO `test` (`id`, `name`) VALUES (8, '大羅'); # 正常執行

/* 提交事務1,釋放事務1的鎖 */
COMMIT;

我們可以看出,指定查詢某一條記錄時,如果這條記錄不存在,會產生間隙鎖

結論

  • 對於指定查詢某一條記錄的加鎖語句,如果該記錄不存在,會產生記錄鎖和間隙鎖,如果記錄存在,則只會產生記錄鎖,如:WHERE id = 5 FOR UPDATE;
  • 對於查找某一範圍內的查詢語句,會產生間隙鎖,如:WHERE id BETWEEN 5 AND 7 FOR UPDATE;

普通索引的間隙鎖

數據準備

創建 test1 表:

  • 注意:number 不是唯一值
CREATE TABLE `test1` (
  `id` int(1) NOT NULL AUTO_INCREMENT,
  `number` int(1) NOT NULL COMMENT '数字',
  PRIMARY KEY (`id`),
  KEY `number` (`number`) USING BTREE
) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8;

id 是主鍵,number上建立了一個普通索引。先加一些數據:

INSERT INTO `test1` VALUES (1, 1);
INSERT INTO `test1` VALUES (5, 3);
INSERT INTO `test1` VALUES (7, 8);
INSERT INTO `test1` VALUES (11, 12);

test1表中 number 索引存在的隱藏間隙:

(-infinity, 1]
(1, 3]
(3, 8]
(8, 12]
(12, +infinity]

執行以下的事務(事務1最後提交)

/* 開啟事務1 */
BEGIN;
/* 查詢 number = 5 的數據並加記錄鎖 */
SELECT * FROM `test1` WHERE `number` = 3 FOR UPDATE;
/* 延遲30秒執行,防止鎖釋放 */
SELECT SLEEP(30);

-- 注意:以下的語句不是放在一個事務中執行,而是分開多次執行,每次事務中只有一條添加語句

/* 事務2插入一條 number = 0 的數據 */
INSERT INTO `test1` (`number`) VALUES (0); -- 正常執行

/* 事務3插入一條 number = 1 的數據 */
INSERT INTO `test1` (`number`) VALUES (1); -- 被阻塞

/* 事務4插入一條 number = 2 的數據 */
INSERT INTO `test1` (`number`) VALUES (2); -- 被阻塞

/* 事務5插入一條 number = 4 的數據 */
INSERT INTO `test1` (`number`) VALUES (4); -- 被阻塞

/* 事務6插入一條 number = 8 的數據 */
INSERT INTO `test1` (`number`) VALUES (8); -- 正常執行

/* 事務7插入一條 number = 9 的數據 */
INSERT INTO `test1` (`number`) VALUES (9); -- 正常執行

/* 事務8插入一條 number = 10 的數據 */
INSERT INTO `test1` (`number`) VALUES (10); -- 正常執行

/* 提交事務1 */
COMMIT;

這裏可以看到,number (1 – 8) 的間隙中,插入語句都被阻塞了,而不在這個範圍內的語句,正常執行,這就是因為有間隙鎖的原因。

加深對間隙鎖的理解

將數據還原成初始化的那樣

/* 開啟事務1 */
BEGIN;
/* 查詢 number = 5 的數據並加記錄鎖 */
SELECT * FROM `test1` WHERE `number` = 3 FOR UPDATE;
/* 延遲30秒執行,防止鎖釋放 */
SELECT SLEEP(30);

/* 事務1插入一條 id = 2, number = 1 的數據 */
INSERT INTO `test1` (`id`, `number`) VALUES (2, 1); -- 阻塞

/* 事務2插入一條 id = 3, number = 2 的數據 */
INSERT INTO `test1` (`id`, `number`) VALUES (3, 2); -- 阻塞

/* 事務3插入一條 id = 6, number = 8 的數據 */
INSERT INTO `test1` (`id`, `number`) VALUES (6, 8); -- 阻塞

/* 事務4插入一條 id = 8, number = 8 的數據 */
INSERT INTO `test1` (`id`, `number`) VALUES (8, 8); -- 正常執行

/* 事務5插入一條 id = 9, number = 9 的數據 */
INSERT INTO `test1` (`id`, `number`) VALUES (9, 9); -- 正常執行

/* 事務6插入一條 id = 10, number = 12 的數據 */
INSERT INTO `test1` (`id`, `number`) VALUES (10, 12); -- 正常執行

/* 事務7修改 id = 11, number = 12 的數據 */
UPDATE `test1` SET `number` = 5 WHERE `id` = 11 AND `number` = 12; -- 阻塞

/* 提交事務1 */
COMMIT;

這裡有一個奇怪的現象:

事務3添加 id = 6,number = 8 的數據,給阻塞了;
事務4添加 id = 8,number = 8 的數據,正常執行了。
事務7將 id = 11,number = 12 的數據修改為 id = 11, number = 5的操作,給阻塞了;

這是為什麼呢?我們來看看下邊的圖

從圖中可以看出,當 number 相同時,會根據主鍵 id 來排序,所以:

事務3添加的 id = 6,number = 8,這條數據是在 (3, 8) 的區間裡邊,所以會被阻塞;
事務4添加的 id = 8,number = 8,這條數據則是在(8, 12)區間裡邊,所以不會被阻塞;
事務7的修改語句相當於在 (3, 8) 的區間裡邊插入一條數據,所以也被阻塞了。

結論

  • 在普通索引列上,不管是何種查詢,只要加鎖,都會產生間隙鎖,這跟唯一索引不一樣
  • 在普通索引跟唯一索引中,數據間隙的分析,數據行是優先根據普通索引排序,再根據唯一索引排序

后碼鎖(Next-key Locks)

后碼鎖是記錄鎖與間隙鎖的組合,它的封鎖範圍,既包含索引記錄,又包含索引區間。

注:Next-key Lock的主要目的,也是為了避免幻讀(Phantom Read)。如果把事務的隔離級別降級為RC,Next-key Lock則也會失效。

總結

  • 記錄鎖、間隙鎖、后碼鎖,都屬於排它鎖;
  • 記錄鎖就是鎖住一行記錄;
  • 間隙鎖只有在事務隔離級別 RR 中才會產生;
  • 唯一索引只有鎖住多條記錄或者一條不存在的記錄的時候,才會產生間隙鎖,指定給某條存在的記錄加鎖的時候,只會加記錄鎖,不會產生間隙鎖;
  • 普通索引不管是鎖住單條,還是多條記錄,都會產生間隙鎖;
  • 間隙鎖會封鎖該條記錄相鄰兩個鍵之間的空白區域,防止其它事務在這個區域內插入、修改、刪除數據,這是為了防止出現 幻讀 現象;
  • 普通索引的間隙,優先以普通索引排序,然後再根據主鍵索引排序;
  • 事務級別是RC(讀已提交)級別的話,間隙鎖將會失效。

資料

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開

大咖分享| 百度語義技術及應用全解

分享嘉賓:孫宇,百度NLP主任研發架構師、語義計算技術負責人。

本文根據作者在“2019自然語言處理前沿論壇”語義理解主題的特邀報告整理而成。

本報告提綱分為以下3個部分:

·    語義表示

·    語義匹配

·    未來重點工作

語義計算方向在百度NLP成立之初就開始研究,研究如何利用計算機對人類語言的語義進行表示、分析和計算,使機器具備語義理解能力。相關技術包含語義表示、語義匹配、語義分析、多模態計算等。

本文主要介紹百度在語義表示方向的技術發展和最新的研究成果艾尼(ERNIE),同時也會介紹工業應用價值很大、百度積累多年的語義匹配SimNet的相關內容,最後再談談未來的重點工作。

 一、語義表示

 計算機理解語言是一個具有很大挑戰的問題。人類在理解語言的過程中,除了語言符號本身的識別,還包含符號背後的語義和知識。舉個例子,當人看到“計算機”這個符號時,腦子里能迅速浮現出計算機的畫面以及和計算機相關的知識和概念,但是這對於計算機就比較困難。所以如何讓計算機能夠表示語言是研究的重點,讓其既能夠蘊含語義信息又可以計算。

當前主要有兩類方法,一是基於形式化規則的方法,如通過構建語義關係網絡來描述語義的信息;二是基於統計的方法,包括主題模型、Word Embedding等技術。

1、百度早期語義表示技術:基於檢索的表示方法


2007年百度便開始語義表示研究,最開始的思路是利用搜索引擎來完成。通過搜索引擎把要表示的句子或者詞語檢索出來,再根據檢索的結果通過Term的分析以及網頁的分析,把相關的詞、信息抽取出來,做成語言符號的表示。但是這個表示實際上停留在原始詞彙空間,表示的空間大小依然是詞表的維度,只是相對於One-Hot的表示來說更精細,這個方法是基於1954年Harris提出來的“上下文相似的詞,其語義也相似”的假設。

2、百度早期語義表示技術:Topic Model


此後,百度又研究了Topic Model的語義表示技術,這種方法的核心思路是把文檔詞彙空間降維,將文檔映射到淺層主題的分佈上,而這種主題空間要比詞的分佈空間更小一些。通過降維的方法,可以得到每個詞到主題的映射,通過這種主題的方法做語義的表示。

當時百度主要解決的問題是怎樣做這種新文檔的表示,難點是超大規模語料訓練、Online EM、MPI并行化。此外,百度還將自研的主題模型以及一些主流的主題模型整理為工業應用工具,對外開源了百度NLP主題模型工具包FAMILIA。

3、基於DNN的語義表示技術:Word Embedding


深度學習技術興起,基於Word Embedding的表示佔了主流,此類技術在各種NLP任務中也表現出色。從NNLM到現在BERT的技術,取得了很多進展。2013年的Word2vec成為NLP標配性的初始化向量,2018年有了上下文相關的詞向量ELMo等。


從2013年到2016年,百度也大力投入到Word Embedding的研究,主要研究工作是在工業界如何用大規模分佈式從海量數據中計算詞向量。比如,怎麼才能高效訓練規模為1T的語料?如何構建大規模分佈式文本計算?此外,算法上我們也有一些研究,比如,如何在一百萬超大規模的詞表裡完成Softmax分類?我們通過一些策略和技術,做成啟髮式Hierarchical Softmax的方法,從而有效地提升分類的效率。2016年,百度把訓練的1T的網頁數據和100萬詞表規模的詞向量對業界進行了開放。

4、多特徵融合的表示模型


BERT的核心思路還是大力出奇迹,它利用了大規模的無監督數據,同時藉助Transformer這種高性能的Encoder的能力,在MASK建模任務上做了一些優化,導致這個效果能夠在各個任務上顯著提升。

百度實際在2017年進行了這方面的探索,當時是研究基於對話的口語理解問題,這個問題的核心是做意圖的分類和槽位的標註。難點在於口語理解的問題標註語料非常少。當時想能不能利用海量的搜索語料做Pre-Training,把這個Model作為初始化模型用到下游的SLU任務里。

我們採用20億搜索的Query,通過LSTM模型做單向Language Model的預訓。我們發現在SLU任務上,在各個垂類上樣本數的增加非常顯著,從10個樣本到2000個樣本。但遺憾的是,當時研究的是一個超小規模數據上效果,即2000的數據,在2萬甚至是20萬的數據上的表現並沒有研究,同時在其他應用的通用性上的研究也不夠充分。

5、知識增強的語義表示模型

 BERT提出后,我們發現一個問題,它學習的還是基礎語言單元的Language Model,並沒有充分利用先驗語言知識,這個問題在中文很明顯,它的策略是MASK字,沒有MASK知識或者是短語。在用Transformer預測每個字的時候,很容易根據詞包含字的搭配信息預測出來。比如預測“雪”字,實際上不需要用Global的信息去預測,可以通過“冰”字預測。基於這個假設,我們做了一個簡單的改進,把它做成一個MASK詞和實體的方法,學習這個詞或者實體在句子裏面Global的信號。


基於上述思想我們發布了基於知識增強的語義表示ERNIE(1.0)。


我們在中文上做了ERNIE(1.0)實驗,找了五個典型的中文公開數據集做對比。不管是詞法分析NER、推理、自動問答、情感分析、相似度計算,ERNIE(1.0)都能夠顯著提升效果。


英文上驗證了推廣性,實驗表明ERNIE(1.0)在GLUE和SQuAd1.1上提升也是非常明顯的。為了驗證假設,我們做了一些定性的分析,找了完形填空的數據集,並通過ERNIE和BERT去預測,效果如上圖。


我們對比了ERNIE、BERT、CoVe、GPT、ELMo模型,結果如上圖所示。ELMo是早期做上下文相關表示模型的工作,但它沒有用Transformer,用的是LSTM,通過單向語言模型學習。百度的ERNIE與BERT、GPT一樣,都是做網絡上的Transformer,但是ERNIE在建模Task的時候做了一些改進,取得了很不錯的效果。


在應用上,ERNIE在百度發布的面向工業應用的中文NLP開源工具集進行了驗證,包括ERNIE與BERT在詞法分析、情感分類這些百度內部的任務上做了對比分析。同時也有一些產品已經落地,在廣告相關性的計算、推薦廣告的觸發、新聞推薦上都有實際應用。目前模型已經開源(

7月31日,百度艾尼(ERNIE) 再升級,發布了持續學習語義理解框架ERNIE 2.0,同時藉助飛槳(PaddlePaddle)多機多卡高效訓練優勢發布了基於此框架的ERNIE 2.0 預訓練模型。該模型在共計16个中英文任務上超越了BERT 和XLNet,取得了SOTA 效果。

二、語義匹配

1、文本語義匹配及挑戰


語義匹配在工業界具有非常大的技術價值,它是一個很基礎的問題,很多產品、應用場景都會用到它。很多問題也可以抽象為語義匹配問題,比如,搜索解決的是Query和Document相關性的問題,推薦解決的是User和Item關聯度、興趣匹配度的問題,檢索式問答解決的是問題與答案匹配度,以及檢索對話Query和Response的匹配問題。由於語言比較複雜,匹配靠傳統的方法是比較難的。


百度搜索在匹配相似度計算方面做了較多工作,包括挖掘同義詞、詞級別泛化、語義緊密度、對齊資源挖掘、共線關聯計算等。


2、神經網絡語義匹配模型:SimNet

2013年百度提出SimNet技術,用於解決語義匹配的問題。這個技術基於DNN框架,沿襲Word Embedding的輸入,基於End-to-End的訓練做表示和匹配,並結合Pairwise訓練。當時,微軟也提出了DSSM,中科院、CMU等研究機構也做了很多語義匹配研究工作。


這幾年,百度整體上從語義匹配的框架上做了升級,抽象了三個層次,改進了基礎算法,包括擴展針對不同場景的模型,比如字和語義的匹配模型;在不同的應用場景,針對問題網頁和問題答案的匹配情況分別做了針對性地優化,集成到了匹配框架里。


匹配算法主要有兩種範式,一種是基於表示的匹配,首先把自然語言表示成向量,然後再進行相似度計算,這方面也有一些改進,主要是做一些Attention;另一種新匹配範式Interaction-based Model,強調更細的匹配,即一個句子的表示不再是一個向量,而是原來的Term,並把原來的位置信息保留,最後以Attention的方式表示,讓匹配更加充分和精細。


關於SimNet技術前瞻性工作,2019年百度在IJCAI上發表了一篇論文“RLTM:An Efficient Neural IR Framework for Long Documents”,其中長文本匹配有一個很大的挑戰,就是讓Document直接做表示,如果文本太長,很多信息會丟失,計算效率也非常低。但如果我們先做一個粗匹配,選擇好相關的句子以後再做精細化的匹配,效果就比較不錯。

3、SimNet的應用


SimNet技術在百度應用非常廣泛,包括搜索、資訊推薦、廣告、對話平台都在使用。


搜索是百度非常重要的產品,搜索有兩個核心功能,下圖的左側上方是搜索的精準問答,通過問答技術把精準答案直接呈現出來;下方是自然排序,主要採用LTR框架和相關性、權威性、時效性等Features。

SimNet在百度搜索的發展可以分為三個時期。萌芽期,上線了BOW Model,這是業界第一次在搜索引擎上線DNN模型;發展期,做了CNN、RNN,並把知識融合進RNN,在語義相關性計算中,除了標題很多其他文本域在相關性建模中也很重要,所以,我們還做多文本域融合匹配的Model;拓展期,除了相關性,在權威性、點擊模型和搜索問答上都有推廣和使用。


在搜索中,SimNet是用超大規模用戶反饋數據訓練。那麼如何依靠海量數據來提升效果?頻次如何選?我們發現模型應用效果並不是靜態的,而是動態變化的,特別是搜索反饋的數據,隨着時間的推移,網民在搜索的時候,Term的分佈、主題的分佈會發生變化,所以數據的時效性影響還是非常大的。


除了模型上的融合,我們把Bigram知識也融入了進去。儘管RNN已經很厲害了,但加入知識、模型還是會有很大地提升。

4、新模型:SimNet-QC-MM


另外,我們還做了Query和網頁正文的建模,由於Query中每個詞都有一定的用戶意圖,所以在模型建模時,會考慮Query中每個詞被Title和正文覆蓋的情況,並基於Matching Matrix匹配方法計算。此外,搜索架構也做了配合改進,搜索也上線了基於GPU和CPU的異構計算架構。


上圖是一個案例,“羋殊出嫁途中遇到危險”,我們後來做了一些分析,發現“危險”和“投毒”有很強的語義關聯,就把這個結果排了上去。

5、語義模型壓縮技術


在模型裁減壓縮上,我們也做了很多工作,包括量化的壓縮和哈希技術的壓縮。整個語義的模型基本上已經從依靠一個Embedding 32bits來存,到現在達到Embedding一維僅需4bits,節省線上DNN匹配模型87.5%的內存消耗。這項技術,除了搜索的使用,移動端的使用也有非常大的價值。


SimNet技術除了百度搜索,包括Q&A,Query和Answer的匹配等方面都有一些嘗試。

三、未來重點工作

接下來我們會在通用語義表示方面進一步研究與突破,除了如何充分地利用先驗知識,利用一些弱監督信號外,模型方面也會進一步探索創新。技術拓展上,跨語言、多語言表示,面向生成、匹配等任務的表示,面向醫療、法律等領域的表示,多模態表示等都是我們的一些重點方向。

RLTM論文地址:

至此,“2019自然語言處理前沿論壇”語義計算主題《百度語義計算技術及其應用》的分享結束。如果大家想更深入地了解百度持續學習語義理解框架艾尼(ERNIE),歡迎加入ERNIE官方交流群(QQ群號:760439550)。

——————-

划重點!!!

掃碼關注百度NLP官方公眾號,獲取百度NLP技術的第一手資訊!

加入ERNIE官方技術交流群(760439550),百度工程師實時為您答疑解惑!

立即前往GitHub(  )為ERNIE點亮Star,馬上學習和使用起來吧! 


最強預告!!!

11月23日,艾尼(ERNIE)的巡迴沙龍將在上海加場,乾貨滿滿的現場,行業A級的導師,還有一群志同道合的小夥伴,還在等什麼?感興趣的開發者們趕緊掃描下方“二維碼”或點擊“鏈接”報名參加吧!


報名鏈接:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

遷移桌面程序到MS Store(11)——應用SVG圖標

在傳統桌面程序中,對圖標的使用大多是直接嵌入JPG或者PNG的圖片。在祖傳的1366×768分辨率下,並沒有什麼問題。相對於手機硬件的突飛猛進,也側面反映了PC行業的落寞和桌面程序開發的不思進取。用360衛士的群眾並不能倒推PC行業的升級。反倒是水果公司雙高的利潤和口碑讓人很是眼饞。加之某軟跳出來教豬隊友做硬件。現在倒是有些起色,1080p的屏幕已是標配,4k也算常見。那麼傳統桌面程序在升級過程中,就會遇到今天要討論的,如何解決高分辨率下圖標模糊的問題。

一種解決方案是按最高的分辨率提供圖片。這種適合較大的圖片,比如背景啥的。另一種就是今天要討論的,針對當前流行的、扁平化圖標的解決方案。

 從本篇的標題可以看出,我們希望應用SVG矢量圖來適應各種分辨率的情況。以WPF程序為例,首先要面對的問題是,WPF並不支持像嵌入JPG/PNG圖標這樣,直接使用SVG圖標。大動干戈的引用第三方library通過自定義類型來支持SVG並不是本文的目的。這裏我們要介紹如何通過字體文件,進而在WPF或UWP中使用SVG圖標的方式。

雖然WPF不支持直接使用SVG文件,但是Windows是支持矢量字體的。而我們的目的就是要將圖標以字體的形式在WPF程序中显示。具體使用的字體TrueType,則是由微軟和蘋果共同開發的字體類型標準,該字體文件的擴展名是.ttf。

接下來我們依然是通過Sample工程來說明。首先給出GitHub的地址:

首先我們打開WpfAppWithPNGs工程,圖標的使用代碼如下:

        <Image Grid.Row="0" Grid.Column="0"  Width="32" Height="32" Source="Resources/Airplane_Off.png" ></Image>
        <Image Grid.Row="0" Grid.Column="1"  Width="64" Height="64" Source="Resources/Airplane_On.png" ></Image>
        <Image Grid.Row="0" Grid.Column="2"  Width="96" Height="96" Source="Resources/Bluetooth_Off.png"  ></Image>
        <Image Grid.Row="0" Grid.Column="3"  Width="128" Height="128" Source="Resources/Bluetooth_On.png"  ></Image>


這裏主要有兩個問題,因為我們默認提供的是32×32的圖標,因此除了第一列Width和Height設置為32的圖標,其他的圖標都存在模糊的問題。第二個問題是針對圖標的每一種顏色,都需要對應提供不同的圖標文件(圖中的例子需要有灰色和藍色兩份文件)。相對的SVG圖標僅僅需要一份文件。即可在程序中動態設定不同的顏色了。

這裏先給出最終WPF項目中,對SVG圖標的引用的代碼,然後我們再進行詳細解釋。對應的工程名為WpfAppWithFontIcons。

        <TextBlock Grid.Row="0" Grid.Column="0" Text="{x:Static local:FontIcons.airplane_mode_circ}"   Foreground="Gray"  FontSize="32" ></TextBlock>
        <TextBlock Grid.Row="0" Grid.Column="1" Text="{x:Static local:FontIcons.airplane_mode_circ}"  Foreground="{StaticResource dellBlue}"  FontSize="64" ></TextBlock>
        <TextBlock Grid.Row="0" Grid.Column="2" Text="{x:Static local:FontIcons.bluetooth_inactive}"   Foreground="Orange"  FontSize="96" ></TextBlock>
        <TextBlock Grid.Row="0" Grid.Column="3" Text="{x:Static local:FontIcons.bluetooth_inactive}"    Foreground="Brown"  FontSize="128" ></TextBlock>

代碼最大的不同應該是由<Image/>標籤更改為<TextBlock/>標籤,這是因為我們是通過ttf字體文件,曲線救國的方式來使用SVG圖標。

具體的步驟如下:

準備SVG圖標文件,將這些文件打包成一整個ttf字體文件。打包的方式有很多種,通常我使用的是IcoMoon的免費解決方案。地址如下:

通過這個網站選擇SVG圖標文件上傳,打包生成一個zip文件。解壓後文件夾結構如下圖:

ttf文件在fonts文件夾中,實際使用時,需要作為資源文件,添加到WPF工程中。點擊圖中的demo.html會打開一個本地網頁,可用於查找ttf文件中包含的SVG圖標,以及對應的unicode。實際我們是通過對unicode的引用來显示SVG圖標的。

完整的project結構如下圖,Fonts文件夾是手動添加用來放置ttf文件。ttf文件名字都是根據項目需要來取,並不固定。

ttf字體文件需要以<FontFamily/>的形式添加到項目的<Resources/>節點中。然後再通過<Style/>指定給<TextBlock/>。當然不在<Resources/>節點定義Style,而是在每個<TextBlock/>中指定FontFamily屬性也是可以的。有關XAML的語法細節,回字的四種寫法什麼的,這裏略過不提。

    <Window.Resources>
        <FontFamily x:Key="Fonticon">/Fonts/rcc-fonticon-ribbon-v2.ttf#rcc-fonticon-ribbon-v2</FontFamily>
        <Style TargetType="TextBlock">
            <Setter Property="FontFamily" Value="{StaticResource Fonticon}" ></Setter>
        </Style>
        <SolidColorBrush x:Key="dellBlue">#007DB8</SolidColorBrush>
    </Window.Resources>

這裏說明一下“/Fonts/rcc-fonticon-ribbon-v2.ttf#rcc-fonticon-ribbon-v2”值的定義,#前面的是文件路徑,#後面的是font name,查看的方法是雙擊ttf文件,參考下圖。

在定義好FontFamily之後,我們並不推薦直接將unicode寫到XAML或.cs文件中。因為在XAML中,你需要如下編寫:

<TextBlock Grid.Row="0" Grid.Column="0" Text="&#xe900;" Foreground="Gray"  FontSize="32" ></TextBlock>

而在C#代碼中,又需要以下面這種格式:

textBlockAirplane.Text = "\ue900";

兩種不統一的格式會在將來修改時帶來極大的困難,特別是圖標被多處引用時,全局的查找替換根本就是噩夢。此外,毫無意義的unicode值的可讀性根本等於0。正常人類無法將”&#xe900;”,”\ue900″和Airplane的圖標聯繫起來。

我推薦的做法是生成一個FontIcons Class,以string類型屬性的形式暴露出來。這樣可以獲得IDE智能語法提示的支持,更新時也僅需修改這個Class,Find All Reference更是方便無比。同時無論在XAML文件,還是C#代碼中,我們看到的都是統一的“FontIcons.airplane_mode_circ”。

    public static class FontIcons
    {
        public static string airplane_mode_circ { get; } = "\ue900";
        public static string bluetooth_inactive { get; } = "\ue901";
        public static string brightness { get; } = "\ue902";
        public static string brightness_inactive { get; } = "\ue903";
        public static string browse_inactive { get; } = "\ue904";
        public static string camera { get; } = "\ue905";
    }

那麼我們是不是需要手工來編寫FontIcons Class呢?大哥我們是能把午飯(我不愛喝咖啡)轉換成Code的生物啊!當然是寫個小工具來自動生成了。在Sample庫中,參考IcoMoonReader工程,只需將IcoMoon生成的.svg文件(icomoon.zip解壓后的fonts文件夾里)丟在IconMoonReader.exe同級目錄,即可生成相應代碼。

 其實只有一個方法啦,使用時需要注意具體的文件名是否正確。

            using (var stream = new FileStream("rcc-fonticon-ribbon-v2.svg", FileMode.Open))
            {
                using (var reader = new StreamReader(stream))
                {
                    var pattern = "unicode(\\S)*\\sglyph-name(\\S)*\"";
                    var input = reader.ReadToEnd();
                    foreach (Match match in Regex.Matches(input, pattern))
                    {
                        pattern = "\"\\S*\"";
                        var list = new List<string>();
                        foreach (var result in Regex.Matches(match.Value, pattern))
                        {
                            list.Insert(0, result.ToString());
                        }
                        var name = list[0].Replace("\"", "").Replace("-","_");
                        var code = list[1].Replace("&#x", "\\u").Replace(";", "");
                        Console.WriteLine($"public static string {name} {{ get; }} = {code};");
                    }
                }
            }

把生成的C#字符串定義貼到具體工程的FontIcons Class(名字隨意)。

這樣一個優秀的解決方案如果僅支持WPF,那又談何遷移到MS Store呢?實際上這套機制放到UWP工程中也是可以的。雖然UWP可以通過SvgImageSource屬性原生支持SVG了,但我們的這套方案在圖標的應用方面毫不遜色,甚至可以說更為方便。具體的例子可以參考AppWithFontIcon工程。在這個UWP的工程中,除了放ttf文件的位置我換到了現成的Assets文件夾,幾乎沒有改變。

        <TextBlock Grid.Row="0" Grid.Column="0" Text="{x:Bind local:FontIcons.airplane_mode_circ}"   Foreground="Gray"  FontSize="32" ></TextBlock>
        <TextBlock Grid.Row="0" Grid.Column="1" Text="{x:Bind local:FontIcons.airplane_mode_circ}"  Foreground="{StaticResource dellBlue}"  FontSize="64" ></TextBlock>
        <TextBlock Grid.Row="0" Grid.Column="2" Text="{x:Bind local:FontIcons.bluetooth_inactive}"   Foreground="Orange"  FontSize="96" ></TextBlock>
        <TextBlock Grid.Row="0" Grid.Column="3" Text="{x:Bind local:FontIcons.bluetooth_inactive}"    Foreground="Brown"  FontSize="{x:Bind DynamicFontSize(),Mode=OneWay,FallbackValue=128}" ></TextBlock>

因為UWP沒有了x:static關鍵字,所以我換成了x:Bind。換成x:Bind之後甚至可以動態的響應值的變化。比如我在這裏把FontSize做了一個x:bind到DynamicFontSize()方法,讓字體隨着界面改變,動態的變大變小。雖然並沒有什麼卵用……但是Demo的時候可以增加點噱頭……

本篇到此結束,照例貼上Github地址:

感謝耐着性子看到這裏的同學!

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享