Docker-Compose基礎與實戰,看這一篇就夠了

what & why

Compose 項目是 Docker 官方的開源項目,負責實現對 Docker 容器集群的快速編排。使用前面介紹的Dockerfile我們很容易定義一個單獨的應用容器。然而在日常開發工作中,經常會碰到需要多個容器相互配合來完成某項任務的情況。例如要實現一個 Web 項目,除了 Web 服務容器本身,往往還需要再加上後端的數據庫服務容器;再比如在分佈式應用一般包含若干個服務,每個服務一般都會部署多個實例。如果每個服務都要手動啟停,那麼效率之低、維護量之大可想而知。這時候就需要一個工具能夠管理一組相關聯的的應用容器,這就是Docker Compose。
Compose有2個重要的概念

  • 項目(Project):由一組關聯的應用容器組成的一個完整業務單元,在 docker-compose.yml 文件中定義。
  • 服務(Service):一個應用的容器,實際上可以包括若干運行相同鏡像的容器實例。

docker compose 安裝與卸載

安裝

二進制包在線安裝

curl -L https://github.com/docker/compose/releases/download/1.25.0/docker-compose-`uname -s`-`uname -m` -o /usr/local/bin/docker-compose 

sudo chmod +x /usr/local/bin/docker-compose

這個方法現在基本行不通,下載太慢了,不推薦使用。

二進制包離線安裝

從https://github.com/docker/compose/releases/download/1.25.0/docker-compose-Linux-x86_64下載對應的安裝包,比如我下載了Linux-x86_64的。

將下載好的安裝包剪切到/usr/local/bin/docker-compose目錄下
mv /app/download/docker-compose-Linux-x86_64 /usr/local/bin/docker-compose

添加執行權限
sudo chmod +x /usr/local/bin/docker-compose

pip安裝

  • 先安裝好pip工具
#安裝依賴 
yum -y install epel-release 
#安裝PIP 
yum -y install python-pip 
#升級PIP 
pip install --upgrade pip
  • 驗證pip 版本
[root@tymonitor bin]# pip --version
pip 8.1.2 from /usr/lib/python2.7/site-packages (python 2.7)
  • 安裝docker compose
    pip install -U docker-compose==1.25.0

  • 驗證docker compose版本
[root@tymonitor bin]# docker-compose --version
docker-compose version 1.25.0, build b42d419

安裝補全插件

curl -L https://raw.githubusercontent.com/docker/compose/1.25.0/contrib/completion/bash/docker-compose > /etc/bash_completion.d/docker-compose

卸載

二進制卸載

rm /usr/local/bin/docker-compose

pip卸載

pip uninstall docker-compose

docker compose 重要命令

命令選項

  • -f, –file FILE 指定使用的 Compose 模板文件,默認為 docker-compose.yml,可以多次指定。
  • -p, –project-name NAME 指定項目名稱,默認將使用所在目錄名稱作為項目名。
  • –x-networking 使用 Docker 的可拔插網絡後端特性
  • –x-network-driver DRIVER 指定網絡後端的驅動,默認為 bridge
  • –verbose 輸出更多調試信息。
  • -v, –version 打印版本並退出。

常用&重要命令

  • config
    驗證 Compose 文件格式是否正確,若正確則显示配置,若格式錯誤显示錯誤原因。
    如:docker-compose -f skywalking.yml config
    此命令不會執行真正的操作,而是显示 docker-compose 程序解析到的配置文件內容:

  • images
    列出 Compose 文件中包含的鏡像。如docker-compose -f skywalking.yml images

  • ps
    列出項目中目前的所有容器。如docker-compose -f skywalking.yml ps

  • build
    構建(重新構建)項目中的服務容器。如:docker-compose -f skywalking.yml build,一般搭配自定義鏡像,比如編寫的Dockfile,功能類似於docker build .

  • up
    該命令十分強大(重點掌握),它將嘗試自動完成包括構建鏡像,(重新)創建服務,啟動服務,並關聯服務相關容器的一系列操作。如docker-compose -f skywalking.yml up。默認情況,docker-compose up 啟動的容器都在前台,控制台將會同時打印所有容器的輸出信息,可以很方便進行調試。

    如果使用docker-compose up -d將會在後台啟動並運行所有的容器。一般推薦生產環境下使用該選項。
    默認情況,如果服務容器已經存在,docker-compose up 將會嘗試停止容器,然後重新創建(保持使用 volumes-from 掛載的卷),以保證新啟動的服務匹配 docker-compose.yml 文件的最新內容。如果用戶不希望容器被停止並重新創建,可以使用 docker-compose up --no-recreate。這樣將只會啟動處於停止狀態的容器,而忽略已經運行的服務。如果用戶只想重新部署某個服務,可以使用 docker-compose up --no-deps -d <SERVICE_NAME> 來重新創建服務並後台停止舊服務,啟動新服務,並不會影響到其所依賴的服務。此命令有如下選項:
    ①:-d 在後台運行服務容器。
    ②:--no-color 不使用顏色來區分不同的服務的控制台輸出。
    ③:--no-deps 不啟動服務所鏈接的容器。
    ④:--force-recreate 強制重新創建容器,不能與 –no-recreate 同時使用。
    ⑤:--no-recreate 如果容器已經存在了,則不重新創建,不能與 –force-recreate 同時使用。
    ⑥:--no-build 不自動構建缺失的服務鏡像。
    ⑦:-t, --timeout TIMEOUT 停止容器時候的超時(默認為 10 秒)。

  • down
    此命令停止用up命令所啟動的容器並移除網絡,如docker-compose -f skywalking.yml down

  • stop
    格式為 docker-compose stop [options] [SERVICE...]
    停止已經處於運行狀態的容器,但不刪除它。通過 docker-compose start 可以再次啟動這些容器,如果不指定service則默認停止所有的容器。如docker-compose -f skywalking.yml stop elasticsearch
    選項:
    -t, --timeout TIMEOUT 停止容器時候的超時(默認為 10 秒)。

  • start
    啟動已經存在的服務容器。用法跟上面的stop剛好相反,如docker-compose -f skywalking.yml start elasticsearch

  • restart
    重啟項目中的服務。用法跟上面的stop,start一樣

  • logs
    格式為docker-compose logs [options] [SERVICE...]
    查看服務容器的輸出。默認情況下,docker-compose 將對不同的服務輸出使用不同的顏色來區分。可以通過 –no-color 來關閉顏色。該命令在調試問題的時候十分有用。如docker-compose -f skywalking.yml logs 查看整體的日誌,docker-compose -f skywalking.yml logs elasticsearch 查看單獨容器的日誌

docker compose 模板文件

模板文件是使用 Compose 的核心,涉及到的指令關鍵字也比較多。本文主要列出幾個常見&重要的指令,其他指令大家可以自行百度。
默認的模板文件名稱為 docker-compose.yml,格式為 YAML 格式。

version: '3'
services:
  elasticsearch:
    image: elasticsearch:6.8.5
    container_name: elasticsearch
    restart: always
    volumes:
      - /app/skywalking/elasticsearch/data:/usr/share/elasticsearch/data:rw
      - /app/skywalking/elasticsearch/conf/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
      - /app/skywalking/elasticsearch/conf/jvm.options:/usr/share/elasticsearch/config/jvm.options
      - /app/skywalking/elasticsearch/logs:/usr/share/elasticsearch/logs:rw
    environment:
      - TZ=Asia/Shanghai
      - xpack.monitoring.enabled=false
      - xpack.watcher.enabled=false
    ports:
      - "9200:9200"
      - "9300:9300"

注意每個服務都必須通過 image 指令指定鏡像或 build 指令(需要 Dockerfile)等來自動構建生成鏡像。如果使用 build 指令,在 Dockerfile 中設置的選項(例如:CMD, EXPOSE, VOLUME, ENV 等) 將會自動被獲取,無需在 docker-compose.yml 中重複設置。

常用&重要命令

  • images
    指定為鏡像名稱或鏡像 ID。如果鏡像在本地不存在,Compose 將會嘗試拉取這個鏡像。
image: apache/skywalking-oap-server:6.5.0
image: apache/skywalking-ui:6.5.0
  • ports
    暴露端口信息。
    使用宿主端口:容器端口 (HOST:CONTAINER) 格式,或者僅僅指定容器的端口(宿主將會隨機選擇端口)都可以,端口字符串都使用引號包括起來的字符串格式。
ports: 
    - "3000" 
    - "8080:8080" 
    - "127.0.0.1:8001:8001"
  • volumes
    數據卷所掛載路徑設置。可以設置為宿主機路徑(HOST:CONTAINER)或者數據卷名稱(VOLUME:CONTAINER),並且可以設置訪問模式 (HOST:CONTAINER:ro)。
volumes:
      - /app/skywalking/elasticsearch/data:/usr/share/elasticsearch/data:rw
      - conf/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
version: "3"
services:
  my_src:
    image: mysql:8.0
    volumes:
      - mysql_data:/var/lib/mysql
volumes:
  mysql_data:
  • ulimits
    指定容器的 ulimits 限制值。
    例如,指定最大進程數為 65535,指定文件句柄數為 20000(軟限制,應用可以隨時修改,不能超過硬限制) 和 40000(系統硬限制,只能 root 用戶提高)。
ulimits:
   nproc: 65535
   nofile:
     soft: 20000
     hard: 40000
  • depends_on
    解決容器的依賴、啟動先後的問題。以下例子中會先啟動 redis mysql 再啟動 web
version: '3'
services:
  web:
    build: .
    depends_on:
      - db
      - redis     
  redis:
    image: redis    
  db:
    image: mysql
  • environment
    設置環境變量。你可以使用數組或字典兩種格式。
environment:
      SW_STORAGE: elasticsearch
      SW_STORAGE_ES_CLUSTER_NODES: elasticsearch:9200
      
environment:
      - SW_STORAGE= elasticsearch
      - SW_STORAGE_ES_CLUSTER_NODES=elasticsearch:9200
  • restart
    指定容器退出后的重啟策略為始終重啟。該命令對保持服務始終運行十分有效,在生產環境中推薦配置為 always 或者 unless-stopped。
    restart: always

docker-compose 實戰

首先我需要推薦兩件事:

  • 配置docker加速鏡像
    創建或修改/etc/docker/daemon.json
sudo mkdir -p /etc/docker
sudo tee /etc/docker/daemon.json <<-'EOF'
{
    "registry-mirrors": [
        "https://hub-mirror.c.163.com",
        "https://mirror.ccs.tencentyun.com",
        "https://reg-mirror.qiniu.co"
    ]
}
EOF
sudo systemctl daemon-reload
sudo systemctl restart docker
  • 給你的ide工具裝上docker插件

本次實戰我們以docker-compose部署skywalking為例。編寫skywalking.yml,內容如下。

version: '3.3'
services:
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:6.8.5
    container_name: elasticsearch
    restart: always
    ports:
      - 9200:9200
      - 9300:9300
    environment:
      discovery.type: single-node
    ulimits:
      memlock:
        soft: -1
        hard: -1
  oap:
    image: skywalking/oap
    container_name: oap
    depends_on:
      - elasticsearch
    links:
      - elasticsearch
    restart: always
    ports:
      - 11800:11800
      - 12800:12800
    environment:
      SW_STORAGE: elasticsearch
      SW_STORAGE_ES_CLUSTER_NODES: elasticsearch:9200
  ui:
    image: skywalking/ui
    container_name: ui
    depends_on:
      - oap
    links:
      - oap
    restart: always
    ports:
      - 8080:8080
    environment:
      SW_OAP_ADDRESS: oap:12800

部署完成后將其上傳至服務器,執行docker-compose -f /app/skywalking.yml up -d即可。

個人公眾號:JAVA日知錄 ,

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
PL真有意思(五):數據類型

前言

現在大多數程序設計語言中都有表達式和/或對象的類型概念。類型起着兩種主要作用:

  • 為許多操作提供了隱含的上下文信息,使程序員可以在許多情況下不必显示的描述這種上下文。比如int類型的兩個對象相加就是整數相加、兩個字符串類型的對象相加就是拼接字符串、在Java和C#中new object()隱含在背後的就是要分配內存返回對象的引用等等。

  • 類型描述了其對象上一些合法的可以執行的操作集合。類型系統將不允許程序員去做一個字符和一個記錄的加法。編譯器可以使用這個合法的集合進行錯誤檢查,好的類型系統能夠在實踐中捕獲很多錯誤

類型系統

從編譯方面的知識我們可以知道,計算機硬件可以按多種不同的方式去解釋寄存器里的一組二進制位。處理器的不同功能單元可能把一組二進制位解釋為指令、地址、字符、各種長度的整數或者浮點數等。當然,二進制位本身是無類型的,對存儲器的哪些位置應該如何解釋,大部分硬件也無任何保留信息。彙編語言由於僅僅是對一些二進制指令的“助記符號”翻譯,它也是這種無類型情況。高級語言中則總是關聯值與其類型,需要這種關聯的一些原因和用途就如前面說到的上下文信息和錯誤檢測。

一般來說,一個類型系統包含一種定義類型並將它們與特定的語言結構關聯的機制;以及一些關於類型等價、類型相容、類型推理的規則。 必須具有類型的結構就是那些可以有值的,或者可以引用具有值得對象的結構。類型等價規則確定兩個值得類型何時相同;類型相容規則確定特定類型的值是否可以用在特定的上下文環境里;類型推理規則基於一個表達式的各部分組成部分的類型以及其外圍上下文來確定這個表達式的類型。

在一些多態性變量或參數的語言中,區分表達式(如一個名字)的類型與它所引用的那個對象的類型非常重要,因為同一個名字在不同時刻有可能引用不同類型的對象。

在一些語言中,子程序也是有類型的,如果子程序是一級或者二級值,其值是動態確定的子程序,這時語言就需要通過類型信息,根據特定的子程序接口(即參數的個數和類型)提供給這種結構的可接受的值集合,那麼子程序就必須具有類型信息。在那些不能動態創建子程序引用的靜態作用域語言(這種語言中子程序是三級值),編譯器時就能確定一個名字所引用的子程序,因此不需要子程序具有類型就可以保證子程序的正確調用。

類型檢查

類型檢查時一個處理過程,其目的就是保證程序遵循了語言的類型相容規則,違背這種規則的情況稱為類型衝突。說一個語言是強類型的,那麼就表示這個語言的實現遵循一種禁止把任何操作應用到不支持這種操作的類型對象上的規則。說一個語言是靜態類型化(statically type)的,那麼它就是強類型的,且所有的類型檢查都能在編譯時進行(現實中很少有語言是真正的靜態類型,通常這一術語是指大部分類型檢查可以在編譯器執行,其餘一小部分在運行時檢查)。如C#我們通常都認為它是靜態類型化的語言。

動態(運行時)類型檢查是遲約束的一種形式,把大部分的檢查操作都推遲到運行的時候進行。採用動態作用域規則的語言大部分都是動態類型語言,因為它的名字和對象的引用都是在運行時確定的,而確定引用對象的類型則更是要在引用確定之後才能做出的。

類型檢查是把雙刃劍,嚴格的類型檢查會使編譯器更早的發現一些程序上的錯誤,但是也會損失一部分靈活性;動態類型檢查靈活性大大的,但是運行時的代價、錯誤的推遲檢查,各種語言的實現也都在這種利弊上進行權衡。

多態性

多態性使得同一段代碼體可以對多個類型的對象工作。它意味着可能需要運行時的動態檢查,但也未必一定需要。在Lisp、Smalltalk以及一些腳本語言中,完全的動態類型化允許程序員把任何操作應用於任何對象,只有到了運行時採取檢查一個對象是否實現了具體的操作。由於對象的類型可以看作它們的一個隱式的(未明確聲明的,一個不恰當的比喻就如C#中的this)參數,動態類型化也被說成是支持隱式的參數多態性。

雖然動態類型化具有強大的威力(靈活性),但卻會帶來很大的運行時開銷,還會推遲錯誤報告。一些語言如ML採用了一種複雜的類型推理系統,設法通過靜態類型化支持隱式的參數多態性。

在面向對象語言里,子類型多態性允許類型T的變量X引用了從T派生的任何類型的對象,由於派生類型必定支持基類型的所有操作,因此編譯器完全可以保證類型T的對象能接受的任何操作,X引用的對象也都能接受。對於簡單的繼承模型,子類型多態的類型檢查就能完全在編譯時實現。採用了這種實現的大多數語言(如C++,JAVA和C#)都提供另一種显示的參數化類型(泛型),允許程序員定義帶有類型參數的類。泛型對於容器(集合)類型特別有用,如T的列表(List )和T的棧(Stack )等,其中T只是一個類型佔位符,在初始化的這個容器對象時提供具體的類型來代替它。與子類型多態類似,泛型也可以在編譯時完成類型檢查。比如C++的模板完全就是編譯期間的東西,編譯后就完全沒有了模板的痕迹;JAVA則是利用一種“擦除”的技術實現的泛型,需要在運行時做一些檢查。

類型的含義

現在至少存在三種不同的考慮類型問題的方式,分別稱之為指稱的、構造的和基於抽象的

  • 指稱的

按照指稱的觀點,一個類型就是一組值,一個值具有某個類型的條件是他屬於這個值集合,一個對象具有某個類型的條件是他的值保證屬於這個值集合

  • 構造的

從構造的觀點看,一個類型或者是以一小組內部類型,或者是通過對一個或幾個更簡單些的類型,應用某個類型的構造符構造出來的

  • 基於抽象的

從基於抽象的角度來看,一個類型就是一個接口,由一組定義良好而且具有相互協調的語義的操作組成。

類型的分類

在不同語言里,有關類型的術語也不相同,這裏說的通常都是常用的術語,大部分語言多提供的內部類型差不多就是大部分處理器所支持的類型:整數、字符、布爾和實數。

一般語言規範中都會規定數值類型的精度問題,以及一些字符的編碼規定。通常特殊的一個數值類型是枚舉類型,具體的語法在不同的語言中略有差異,但是其也都是一個目的(用一個字符友好的表示一個數值)。

關於枚舉類型,由一組命名元素組成。在C中可以這樣寫:

enum weekday { sun, mon, tue, wed, thu, fri, sat };

在C中這樣的寫法和直接對裏面的元素直接賦值除了語法上效果完全一樣。但是在之後的許多語言中,枚舉類型是一個真正的類型

還有一些語言中提供一種稱為子界的類型,它表示一種基於基本數值的一個連續的區間。比如Pascal中表示1到100:

type test_score = 0..100

複合類型:由一些簡單的基本類型組合成的一些類型稱為複合類型,比如常見的記錄、變體記錄、數組、集合、指針、表等,具體的都會在後面詳細介紹。

類型檢查

大多數的靜態類型語言中,定義一個對象都是需要描述清楚它的類型,進一步講,這些對象出現的上下文也都是有類型的,也就是說語言中的一些規則限制了這種上下文中可以合法出現的對象類型。

類型相容確定了一個特定類型的對象的能否用在一個特定上下文中。在最極端的情況下,對象可使用的條件就是它的類型與上下文所期望的類型等價。但是在大多數語言中,相容關係都比等價更寬鬆一些,即使對象與上下文的類型不同,它們也可以相容。

而類型推理想回答的是從一個簡單的表達式出發構造另一個表達式時,這整個的表達式的類型是什麼

類型等價

在用戶可以定義新類型的語言中,類型等價的定義一般基於兩種形式。

type R2 = record
    a : integer
    b : integer
end;

type R2 = record
    b : integer
    a : integer
end;
  • 結構等價

基於類型定義的內容,就是它們由同樣的組成部分且按照同樣的方式組合而成

它的準確定義在不同的語言中也不一樣,因為它們要決定類型之間的哪些潛在差異是重要的,哪些是可以接受的(比如上面的兩個定義,是否還認為是等價的)。結構等價是一種很直接的認識類型的方式,早期的一些語言(Algol 68、Modula-3、ML)有些事基於結構等價的,現在的大部分語言(Java、C#)大都是基於名字等價了,為何呢?因為從某種意義上看,結構等價是由底層、由實現決定的,屬於比較低級的思考方式。就如一個上下文,如果你傳遞了一個結構等價但是不是所期待對象,實施結構等價的編譯器是不會拒絕這種情況的(假如這不是你希望的,那麼你也不會得到任何提示或者錯誤信息,很難排查的)。

  • 名字等價

基於類型的詞法形式,可以認為是每一個名字都引進一個新的類型;

它基於一種假設,就是說程序員花時間定義了兩個類型,雖然它們的組成部分可能相同,但是程序員要表達的意思就是這是兩個不同的類型。名字等價的常規判斷就非常簡單了,看看聲明兩個對象的類型是否是一個就是了。但是也會有一些特殊的情況出現,比如類型別名(C、C++的程序員很熟悉這種東西吧),比如 typedef int Age; 就為int類型重新定義了一個別名”Age”。那些認為int不等價越Age的語言稱為嚴格名字等價,認為等價的稱為寬鬆名字等價。其實這兩種也是很容易區分的,只要能區分聲明和定義兩個概念的差異就可以區分。在嚴格名字等價中看待typedef int Age是認為定義了一個新類型Age,在寬鬆名字等價看來這就是一個類型聲明而已,int和Age共享同一個關於整數的定義。

類型變換和轉換

在靜態類型的語言中,如果“a=b”,那麼我們會期望b的類型和a的相同;現在假定所提供的類型和期望的類型和所提供的類型相同,那麼我們在要求某個類型的上下文中使用另外一個類型時就需要显示的寫出類型變換(或稱為類型轉換)。根據具體的變換的具體情況,在運行時執行這種變化會有以下三種主要的情況出現:

  • 所涉及的類型可以認為是結構等價的,這種情況裏面因為涉及的類型採用了相同的底層的表示,則這種變換純粹就是概念上的操作,不需要運行時執行任何代碼。

  • 所涉及的類型具有不同的值集合,但它們的值集合具有相同的表示形式。比如一個類型和它的子類型,一個整數和一個無符號的整數。拿無符號整數變換為整數來說,由於無符號整數的最大值是整數類型所容納不了的,則運行時就必須執行一些代碼來保證這種變換的合法性,如果合法則繼續下去,否則會產生一個動態語義錯誤。

  • 所涉及的類型具有不同的底層表示,但是我們可以在它們的值之間定義某種對應關係。比如32位整數可以變換到IEEE的雙精度浮點數,且不會丟失精度。浮點數也可以通過舍入或割斷的形式變換成整數,但是會丟失小數部分。

非變換的類型轉換

有這麼一種情況,我們需要改變一個值,但是不需要改變它的二進製表示形式,更通俗點說就是我們希望按照另外一個類型的方式去解釋某個類型的二進制位,這種情況稱為非變換類型轉換。最簡單的一個例子比如說,一個byte類型的數值65,按byte類型來解釋它是65,如果按照char類型來解釋它就是字符“A”。比如C++中的static_cast執行類型變換,reinterpret_cast執行非變換的類型轉換。c中出現的union形式的結構,就可以認為是這種非變換的類型轉換的合法的安全的語言結構。在比如下面C中一般性非變換類型轉換代碼:

r=*((float *) &n);

任何非變換的類型轉換都極其危險的顛覆了語言的類型系統。在弱類型系統的語言中,這種顛覆可能很難發現,在強類型系統的語言中显示的使用這種非變換的類型轉換,起碼從代碼上可以看得出來它是這麼一回事,或多或少的有利於排查問題。

類型相容

大多數語言的上下文中並不要求類型等價,相應的一般都是實施較為“寬鬆”的類型相容規則。比如賦值語句要求右值相容與左值、參數類型相容,實際返回類型與指定的返回類型相容。在語言中,只要允許把一個類型的值用到期望的另外一個類型的上下文中,語言都必須執行一個到所期望類型的自動隱式變換,稱為類型強制(比如int b;double a=b;)。就像前面說的显示的類型變換一樣,隱式的類型變換也可能需要執行底層代碼或者做一些動態類型檢查。

重載

一個重載的名字可能引用不同類型的對象,這種歧義性需要通過上下文信息進行解析。比如a+b這個表達式可以表示整數或者浮點數的加法運算,在沒有強制的語言中,a和b必須都是整數或都是浮點數。如果是有強制的語言,那麼在a或者b有一個是浮點數的情況下,編譯器就必須使用浮點數的加法運算(另外一個整數強制轉換為浮點數)。如果語言中+只是進行浮點數運算,那麼即使a和b都是整數,也會被全部轉成浮點數進行運算(這代價就高了好多了)。

通用引用類型

通用引用類型:一些語言根據實習需求,設計有通用的引用類型,比如C中的void*、C#中的Object,任意的值都可以賦值給通用引用類型的對象。但是問題是存進去容易取出來難,當通用引用類型是右值的時候,左值的類型可能支持某些操作,然而這些操作右值對象是不具備的。為了保證通用類型到具體類型的賦值安全,一種解決辦法是讓對象可以自描述(也就是這個對象包含其真實類型的描述信息),C++,JAVA,C#都是這種方式,C#中如果賦值的類型不匹配則會拋出異常,而C++則是使用dynamic_cast做這種賦值操作,具體的後果呢,也是C++程序員負責。

類型推理

通過前面的類型檢查我們可以保證表達式的各各組成部分具有合適的類型,那麼這整個表達式的類型是什麼來着?其實在大多數的語言中也是比較簡單的,算術表達式的類型與運算對象相同、比較表達式總是布爾類型、函數調用的結果在函數頭聲明、賦值結果就是其左值的類型。在一些特殊的數據類型中,這個問題並不是那麼清晰明了,比如子界類型、複合類型。比如下面的子界類型問題(Pascal):

type Atype=0..20;
type Btype=10..20;

var a: Atype;
var b: Btype;

那麼a+b什麼類型呢???它確實是不能是Atype或者Btype類型,因為它可能的結果是10-40。有人覺得那就新構造一個匿名的子界類型,邊界時10到40。實際情況是Pascal給的答案是它的基礎類型,也就是整數。

在Pascal中,字符串’abc’的類型是array[1..3] of char、而Ada則認為是一種未完全確定的類型,該類型與任何3個字符數組相容,比如在Ada中’abc’ & ‘defg’其結果是一個7字符的數組,那麼這個7字符數組的類型是array[1..7] of cahr呢還是某一個也是7個字符組成的類型array (weekday) of character呢,更或者是其他任意一個也是包含七個字符數組的另外一個類型。這種情況就必須依賴表達式所處的上下文信息才能推到出來具體的類型來。

記錄(結構)與變體(聯合)

一些語言中稱記錄為結構(struct),比如C語言。C++把結構定義為class的一種特殊形式(成員默認全局可見),Java中沒有struct的概念,而C#則對struct採用值模型,對class採用引用模型。

語法與運算

一個簡單的結構體在C中可以這樣定義:

struct element{
    char name[2];
    int number;
    double weight;
    Bool merallic;    
}; 

等價於Pascal中的:

 type two_chars=packed array [1..2] of char;
 type element - record
     name:two_chars;
     number:integer;
     weight:real;
     metallic:Boolean
 end

記錄裏面的成員(如name,number…)稱為域(field)。在需要引用記錄中的域時,大部分語言使用“.”記法形式。比如Pascal中:

 var copper:eement;
 copper.name=6.34;

大部分語言中還允許記錄的嵌套定義,比如在Pascal中:

 type short_string=packed array[1..30] of char;
 type ore=record
      name:short_string;
      element_yielded:record /*嵌套的記錄定義*/
          name:two_chars;
          number:integer;
          weight:real;
          metallic:Boolean
      end
 end

存儲布局及其影響

一個記錄的各個域通常被放入內存中的相鄰位置。編譯器在符號表中保存每個域的偏移量,裝載和保存的時候通過基址寄存器和偏移量即可得到域的內存地址。類型element在32位的機器中可能的布局如下:

此處有圖

(圖在最後面,因為markdown的這個畫表格不符合這個要求,又不想引圖了,就直接用html寫了,會被擠到最後去)

(table標籤和我博客園的樣式生成的時候會出bug,刪除了)

在對結構體的存儲布局方案上,如果使用正常排序,結構中的空洞會浪費空間。但是如果通過壓縮來節省空間,但是可能很帶來很嚴重的訪問時間的代價

數組

數組是最常見也是最重要的複合數據類型。記錄用於組合一些不同類型的域在一起;而數組則不同,它們總是同質的。從語義上看,可以把數組想象成從一個下標類型到成員(元素)類型的映射。

有些語言要求下標類型必須是integer,也有許多語言允許任何離散類型作為下標;有些語言要求數組的元素類型只能是標量,而大多數語言則允許任意類型的元素類型。也有一些語言允許非離散類型的下標,這樣產生的關聯數組只能通過散列表的方式實現,而無法使用高效的連續位置方式存儲,比如C++中的map,C#中的Dictionary。在本節中的討論中我們假定數組的下標是離散的。

語法和操作

大多數的語言都通過數組名后附加下標的方式(圓括號|方括號)來引用數組裡的元素。由於圓括號()一般用於界定子程序調用的實際參數,方括號在區分這兩種情況則有易讀的優勢。Fortran的數組用圓括號,是因為當時IBM的打卡片機器上沒有方括號

維數、上下界和分配

對於數組的形狀在聲明中就已經描述,對於這種有靜態形狀的數組,可以用通常的方式來管理內存:生存期是整個程序的數組使用棧分配,具有更一般的生存期的動態生成數組使用堆分配。但是對於在加工之前不知道其形狀的數組,或其形狀在執行期間可能改變的數組,存儲管理就會更複雜一點。

  • 內情向量

在編譯期間,符號表維護者程序中的每個數組的維度和邊界信息。對於每個記錄,它還維護着每個域的偏移量。如果數組維度的數目和邊界是靜態已知的,編譯器就可以在符號表中找出它們,以便計算數組元素的地址。如果這些值不是靜態已知的,則編譯器就必須生成代碼,在運行時從一個叫內情向量的數據結構來查找它

  • 棧分配

子程序參數是動態形狀數組最簡單的例子,其中數組的上下界在運行時才確定,調用方都會傳遞數組的數據和一個適當的內情向量,但是如果一個數組的形狀只能到加工時才知道,這種情況下仍可以在子程序的棧幀里為數組分配空間,但是需要多做一層操作

  • 堆分配

在任意時間都可以改變形狀的數組,有時被稱為是完全動態的。因為大小的變化不會以先進先出的順序進行,所以棧分配就不夠用了。完全動態的數組必須在堆中分配。比如Java中的ArrayList

#### 內存布局

大多數語言的實現里,一個數組都存放在內存的一批連續地址中,比如第二個元素緊挨着第一個,第三個緊挨着第二個元素。對於多維數組而言,則是一個矩陣,會出現行優先和列優先的選擇題,這種選擇題對於語言使用者而言是透明的,而對語言的實現者則需要考慮底層方面的優化問題了。

在一些語言中,還有另外一種方式,對於數組不再用連續地址分配,也不要求各行連續存放,而是允許放置在內存的任何地方,再創建一個指向各元素的輔助指針數組,如果數組的維數多於兩維,就再分配一個指向指針數組的指針數組。這種方式稱為行指針布局,這種方式需要更多的內存空間,但是卻有兩個優點:

  • 首先,可能加快訪問數組裡單獨元素的速度;
  • 其次,允許創建不用長度的行,而且不需要再各行的最後留下對齊所用的空洞空間,這樣節省下來的空間有時候可能會超過指針佔據的空間。C,C++和C#都支持連續方式或行指針方式組織多維數組,從技術上講,連續布局才是真正的多維數組,而行指針方式則只是指向數組的指針數組。

字符串

許多語言中,字符串也就是字符的數組。而在另一些語言中,字符串的情況特殊,允許對它們做一些其他數組不能用的操作,比如Icon以及一些腳本語言中就有強大的字符串操作功能。

字符串是編程中非常重要的一個數據類型,故而很多語言都對字符串有特殊的處理以便優化其性能以及存儲(比如C#中的字符串不可變性保證了性能,字符串駐留技術照顧了存儲方面的需要),由於這些特殊的處理,故而各各語言中為字符串提供的操作集合嚴重依賴語言設計者對於實現的考慮。

集合

程序設計語言中的一個集合,也就是具有某個公共類型的任意數目的一組值的一種無序彙集。集合的元素所具有的類型叫做元類型或者基類型。現在的大多數程序設計語言都對集合提供了很大的支持,為集合提供了很多相關的操作

指針和遞歸類型

所謂的遞歸類型,就是可以在其對象中包含一個或多個本類型對象的引用類型。遞歸類型用於構造各種各樣的“鏈接”數據結構,比如樹。在一些對變量採用引用模型的語言中,很容易在創建這種遞歸類型,因為每個變量都是引用;在一些對變量採用值模型的語言中,定義遞歸類型就需要使用指針的概念,指針就是一種變量,其值是對其他對象的引用。

對於任何允許在堆里分配新對象的語言,都存在一個問題:若這種對象不在需要了,何時以及以何種方式收回對象佔用的空間?對於那些活動時間很短的程序,讓不用的存儲留在那裡,可能還可以接受,畢竟在它不活動時系統會負責回收它所使用的任何空間。但是大部分情況下,不用的對象都必須回收,以便騰出空間,如果一個程序不能把不再使用的對象存儲回收,我們就認為它存在“內存泄漏”。如果這種程序運行很長一段時間,那麼它可能就會用完所有的空間而崩潰。許多早期的語言要求程序員显示的回收空間,如C,C++等,另一些語言則要求語言實現自動回收不再使用的對象,如Java,C#以及所有的函數式語言和腳本語言。显示的存儲回收可以簡化語言的實現,但會增加程序員忘記回收不再使用的對象(造成內存泄漏),或者不當的回收了不該回收的正在使用的對象(造成懸空引用)的可能性。自動回收可以大大簡化程序員的工作,但是為語言的實現帶來了複雜度。

語法和操作

對指針的操作包括堆中對象的分配和釋放,對指針間接操作以訪問被它們所指的對象,以及用一個指針給另一個指針賦值。這些操作的行為高度依賴於語言是函數式還是命令式,以及變量/名字使用的是引用模型還是值模型。

函數式語言一般對名字採用某種引用模型(純的函數式語言里根本沒有變量和賦值)。函數式語言里的對象傾向於採取根據需要自動分配的方式。

命令式語言里的變量可能採用值模型或引用模型,有時是兩者的某種組合。比如 A=B;

  • 值模型: 把B的值放入A。
  • 引用模型: 使A去引用B所引用的那個對象。

Java的實現方式區分了內部類型和用戶定義的類型,對內部類型採用值模型,對用戶定義的類型採用則採用引用模型,C#的默認方式與Java類似,另外還提供一些附加的語言特性,比如“unsafe”可以讓程序員在程序中使用指針。

懸空引用

在前兩篇的名字、作用域和約束中我們列舉了對象的3種存儲類別:靜態、棧和堆。靜態對象在程序的執行期間始終是活動的,棧對象在它們的聲明所在的子程序執行期間是活動的,而堆對象則沒有明確定義活動時間。

在對象不在活動時,長時間運行的程序就需要回收該對象的空間,棧對象的回收將作為子程序調用序列的一部分被自動執行。而在堆中的對象,由程序員或者語言的自動回收機制負責創建或者釋放,那麼如果一個活動的指針並沒有引用合法的活動對象,這種情況就是懸空引用。比如程序員显示的釋放了仍有指針引用着的對象,就會造成懸空指針,再進一步假設,這個懸空指針原來指向的位置被其他的數據存放進去了,但是實際卻不是這個懸空指針該指向的數據,如果對此存儲位置的數據進行操作,就會破壞正常的程序數據。

那麼如何從語言層面應對這種問題呢?Algol 68的做法是禁止任何指針指向生存周期短於這個指針本身的對象,不幸的是這條規則很難貫徹執行。因為由於指針和被指對象都可能作為子程序的參數傳遞,只有在所有引用參數都帶有隱含的生存周期信息的情況下,才有可能動態的去執行這種規則的檢查。

廢料收集

對程序員而已,显示釋放堆對象是很沉重的負擔,也是程序出錯的主要根源之一,為了追蹤對象的生存軌跡所需的代碼,會導致程序更難設計、實現,也更難維護。一種很有吸引力的方案就是讓語言在實現層面去處理這個問題。隨着時間的推移,自動廢料收集回收都快成了大多數新生語言的標配了,雖然它的有很高的代價,但也消除了去檢查懸空引用的必要性了。關於這方面的爭執集中在兩方:以方便和安全為主的一方,以性能為主的另一方。這也說明了一件事,編程中的很多地方的設計,架構等等方面都是在現實中做出權衡。

廢料收集一般有這兩種思想,就不詳細說了。

  • 引用計算
  • 追溯式收集

表

表具有遞歸定義的結構,它或者是空表,或者是一個有序對,有序對由一個對象和另一個表組成。表對於函數式或者邏輯式語言程序設計非常適用,因為那裡的大多數工作都是通過遞歸函數或高階函數來完成的。

在Lisp中:

(cons 'a '(b))  => (a b)
(car '(a b))    => a
(cdr '(a b c))  => (b c)

在Haskell和Python還由一個非常有用的功能,叫做列表推導。在Python中可以這樣推導出一個列表

[i * i for i in range(1, 100) if i % 2 == 1]

文件和輸入/輸出

輸入/輸出(I/O)功能使程序可以與外部世界通信。在討論這種通信時,將交互式I/O和文件I/O分開可能有些幫助。交互式IO通常意味着與人或物理設備通信,人或設備都與運行着的程序并行工作,送給程序的輸入可能依賴程序在此之前的輸出。文件通常對應於程序的地址空間之外的存儲器,由操作系統實現。

有些語言提供了內置的File數據類型,另外一些語言將IO工作完全委託給庫程序包,這些程序包導出一個file類型。所以IO也算作是一種數據類型

相等檢測和賦值

對於簡單的基本數據類型,如整數、浮點數和字符,相等檢測和賦值相對來說都是直截了當的操作。其語義和實現也很明確,可以直接按照二進制位方式比較或複製,但是,對於更加複雜或抽象的數據類型,就可能還需要其它的比較方式

  • 相互是別名?
  • 二進制位是否都相等?
  • 包含同樣的字符序列?
  • 如果打印出來,看起來完全一樣?

就許多情況下,當存在引用的情況下,只有兩個表達式引用相同的對象時它們才相等,這種稱為淺比較。而對於引用的對象本身存在相等的含義時,這種比較稱為深比較。對於複雜的數據結構,進行深比較可能要進行遞歸的遍歷。所以相對來說,賦值也有深淺之分。深賦值時是進行完整的拷貝。

大多數的語言都使用淺比較和淺賦值

小結

本文從語言為何需要類型系統出發,解釋了類型系統為語言提供了那些有價值的用途:1是為許多操作提供隱含的上下文,使程序員在許多情況下不必显示的描述這種上下文;2是使得編譯器可以捕捉更廣泛的各種各樣的程序錯誤。 然後介紹了類型系統的三個重要規則:類型等價、類型相容、類型推理。以此3個規則推導出的強類型(絕不允許把任何操作應用到不支持該操作的對象上)、弱類型以及靜態類型化(在編譯階段貫徹實施強類型的性質)、動態類型化的性質以及在對語言的使用方面的影響。以及後續介紹了語言中常見的一些數據類型的用途以及語言在實現這種類型方面所遇到的問題以及其大致的實現方式。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

RNN-LSTM講解-基於tensorflow實現

cnn卷積神經網絡在前面已經有所了解了,目前博主也使用它進行了一個圖像分類問題,基於kaggle裏面的food-101進行的圖像識別,識別率有點感人,基於數據集的關係,大致來說還可行。
下面我就繼續學習rnn神經網絡。

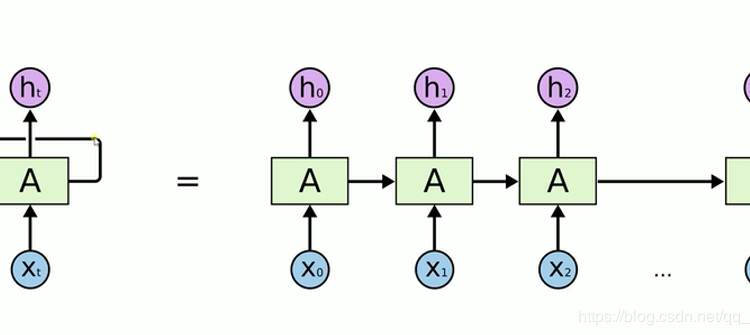
rnn神經網絡(遞歸/循環神經網絡)模式如下:

我們在處理文字等問題的時候,我們的輸入會把上一個時間輸出的數據作為下一個時間的輸入數據進行處理。
例如:我們有一段話,我們將其分詞,得到t個數據,我們分別將每一個詞傳入到x0,x1….xt裏面,當x0傳入后,會得到一個結果h0,同時我們會將處理后的數據傳入到下個時間,到下個時間的時候,我們會再傳入一個數據x1,同時還有上一個時間處理后的數據,將這兩個數據進行整合計算,然後再向下傳輸,一直到結束。
rnn本質來說還是一個bp迴路,不過他只是比bp網絡多一個環節,即它可以反饋上一時間點處理后的數據。

上圖細化如下:

rnn實際上還是存在梯度消失的問題,因此如上圖所示,當我們在第一個時間輸入的數據,可能在很久之後他就已經梯度消失了(影響很小),因此我們使用lstm(long short trem memory)

上圖有三個門:輸入門    忘記門   輸出門
1.輸入門:通過input * g 來判斷是否輸入,如果不輸入就為0,輸入就是0,以此判斷信號是否輸入
2.忘記門:這個信號是否需要衰減多少,可能為50%,衰減是根據信號來判斷。
3.輸入門:通過判斷是否輸出,或者輸出多少,例如輸出50%。
因此上述圖可化為:

可以看出,這三個門,所有得影響都是關於輸入和上一個數據得輸出來進行計算的。

可以看下圖:

我們使用lstm得話,通過三個門決定信號是否向下傳輸,傳輸多少都可以控制,是否傳入信號,輸出信息都進行控制。

下面我們還是用tensorflow實現,數據集還是手寫数字,雖然rnn主要是用在文字和語言上,但是它依舊可以用在圖片上。
下面給出代碼:

```python
import tensorflow as tf
from tensorflow.contrib import rnn
from tensorflow.examples.tutorials.mnist import  input_data
mnist=input_data.read_data_sets("MNNIST_data",one_hot=True)

#輸入圖片為 28*28
n_inputs=28#輸入一行,一行有28個像素
max_time=28#一共28行,所以為28*28
lstm_size=100#100個隱藏單元
batch_size=50
n_classes=10
n_batch=mnist.train.num_examples//batch_size#計算一共多少批次

#這裏none表示第一個維度可以是任意長度
x=tf.placeholder(tf.float32,[None,784])

y=tf.placeholder(tf.float32,[None,10])

#初始化權值
weights=tf.Variable(tf.truncated_normal([lstm_size,n_classes],stddev=0.1))
#初始化偏置值
biases=tf.Variable(tf.constant(0.1,shape=[n_classes]))

##定義Rnn 網絡
def RNN(X,weights,biases):
    inputs=tf.reshape(X,[-1,max_time,n_inputs])
    #定義lstm基本cell
    lstm_cell = rnn.BasicLSTMCell(lstm_size)
    #lstm_cell=tf.contrib.rnn.core_rnn_cell.BasicLSTMCell(lstm_size)
    outputs,final_state=tf.nn.dynamic_rnn(lstm_cell,inputs,dtype=tf.float32)
    results=tf.nn.softmax(tf.matmul(final_state[1],weights)+biases)
    return results
prediction=RNN(x,weights,biases)
#損失函數
cross_entropy=tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(logits=prediction,labels=y))
#優化器
train_step=tf.train.AdamOptimizer(1e-4).minimize(cross_entropy)
#保存結果
correct_prediction=tf.equal(tf.argmax(y,1),tf.argmax(prediction,1))

accuracy=tf.reduce_mean(tf.cast(correct_prediction,tf.float32))

init=tf.global_variables_initializer()

with tf.Session() as sess:
    sess.run(init)
    for epoch in range(6):
        for batch in range(n_batch):
            batch_xs,batch_ys=mnist.train.next_batch(batch_size)
            sess.run(train_step,feed_dict={x:batch_xs,y:batch_ys})

        acc=sess.run(accuracy,feed_dict={x:mnist.test.images,y:mnist.test.labels})
        print("iter:"+str(epoch)+"testing accuracy"+str(acc))


“`
運行結果如下:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

Rust 入門 (二)

我認為學習計算機語言,應該先用後學,這一節,我們來實現一個猜数字的小遊戲。

先簡單介紹一個這個遊戲的內容:遊戲先生成一個1到100之間的任意一個数字,然後我們輸入自己猜測的数字,遊戲會告訴我們輸入的数字太大還是太小,然後我們重新輸入新的数字,直到猜到遊戲生成的数字,然後遊戲結束。

創建項目

製作遊戲的第一步先創建項目,創建方法和上一節一樣,使用 cargo 來創建一個名為 guessing_game 的項目。

cargo new guessing_game && cd guessing_game

項目創建完成,可以運行一下,如果程序打印出 Hello, World! 則證明程序創建完成,運行命令如下:

cargo run 

讀取猜測的数字

正式寫遊戲的第一步,讓遊戲先讀取我們猜測的数字。我們可以先把打印語句換成提示我們輸入数字的提示語句。

use std::io;

fn main() {
    println!("猜測数字遊戲,請輸入您猜測的数字。");

    let mut guess = String::new();

    io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

    println!("您猜測的数字是:{}", guess);
}

這段代碼包含了大量的信息,我們一行一行地過一遍。
1.因為我們需要讀取用戶的輸入,然後把它作為結果打印出來,所以需要把 標準庫(被稱作 std )中的 io 依賴引入當前作用域。
2.在主函數中寫方法體,首先是打印提示語,不說了。
3.然後創建一個用於保存即將輸入的字符串的 String 類型的變量 guess。
4.把控制台輸入的数字讀取到變量 guess 中,如果讀取失敗,則打印 “讀取数字失敗!” 的字符串。
5.把讀取的数字再打印到控制台。

注:這段程序的細節暫時先不深究了,後續文章會一一解釋清楚。

測試一下這段程序:

cargo run                                    
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 1.01s
     Running `target/debug/guessing_game`
猜測数字遊戲,請輸入您猜測的数字。
2
您猜測的数字是:2

生成隨機數

我們的遊戲需要創建一個隨機數,供我們去猜測,這個数字要求每次啟動遊戲時都是不相同的,這樣遊戲才更加有意思。接下來我們在遊戲中生成一個1到100的隨機數。但是 rust 沒有在它的標準庫中提供生成隨機數的方法,不過沒關係,它提供了生成隨機數的名為 rand 的 crate。我們來引入一下生成隨機數的 crate,修改 Cargo.toml 文件:

[dependencies]

rand = "^0.3.14"

只需要在 [dependencies] 下面添加需要的 crate 即可。這次添加的 crate 名字是 rand,版本號 0.3.14, 而 ^ 的意思是兼容 0.3.14 版本的任何版本都可以。然後我們編譯一下程序,就會自動下載引入的依賴:

cargo build                                      
    Updating crates.io index
   Compiling libc v0.2.65
   Compiling rand v0.4.6
   Compiling rand v0.3.23
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 1m 13s

引入了生成隨機數和 crate 后,我們來生成一下需要的 crate,代碼如下:

use std::io;
use rand::Rng;

fn main() {
    let secret_number = rand::thread_rng().gen_range(1, 101);

    println!("生成的隨機数字是:{}", secret_number);

    println!("猜測数字遊戲,請輸入您猜測的数字。");

    let mut guess = String::new();

    io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

    println!("您猜測的数字是:{}", guess);
}

可以看到我們在前面代碼的基礎上添加了三行代碼:
1.第一行是引入生成隨機數的依賴。
2.第二行是生成一個隨機數,隨機數的範圍是 [1, 101),區間是左閉右開,說人話就是1到100。
3.第三行是打印生成的隨機數。
然後我們測試一下添加的隨機數是否生效:

cargo run                                    
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 0.45s
     Running `target/debug/guessing_game`
生成的隨機数字是:79
猜測数字遊戲,請輸入您猜測的数字。
6
您猜測的数字是:6

比較隨機數和猜測數

現在我們可以輸入自己猜測的数字,也可以生成隨機数字了,那麼接下來就是比較二者的大小了。但是在比較之前還有個問題,控制台輸入的数字是 string 類型的,而隨機生成的数字是無符號32位整型(u32),二者不類型不一致,不能作比較,因此,在比較之前,我們應該先把控制台輸入的 string 類型的数字轉成u32類型的,代碼如下:

use std::io;
use std::cmp::Ordering;
use rand::Rng;

fn main() {
    let secret_number = rand::thread_rng().gen_range(1, 101);

    println!("生成的隨機数字是:{}", secret_number);

    println!("猜測数字遊戲,請輸入您猜測的数字。");

    let mut guess = String::new();

    io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

    let guess: u32 = guess.trim().parse().expect("請輸入一個数字!");

    println!("您猜測的数字是:{}", guess);

    match guess.cmp(&secret_number) {
        Ordering::Less => println!("您猜測的数字太小了!"),
        Ordering::Greater => println!("您猜測的数字太大了!"),
        Ordering::Equal => println!("恭喜您,猜對了!"),
    }
}

可見,我們在三個位置添加了代碼:
1.從標準庫中添加了比較的依賴。
2.把輸入的数字類型成u32類型,如果輸入的不是数字,則轉換失敗,打印出錯誤信息。
3.最後一部分就是比較一下二者的大小,並打印出比較的結果。
好了,我們先測試一下吧,這裏我們只測正確的輸入:

cargo run                                     101 ↵
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 0.42s
     Running `target/debug/guessing_game`
生成的隨機数字是:53
猜測数字遊戲,請輸入您猜測的数字。
4
您猜測的数字是:4
您猜測的数字太小了!

添加循環

我們發現,我們只輸入了一次,遊戲就結束了,這顯然不符合我們的預期。我們的預期是,我們可以一直猜一直猜,直到猜中才讓遊戲結束,那應該怎麼修改一下呢?添加一個循環,代碼如下:

use std::io;
use std::cmp::Ordering;
use rand::Rng;

fn main() {
    let secret_number = rand::thread_rng().gen_range(1, 101);

    println!("生成的隨機数字是:{}", secret_number);

    loop {

        println!("猜測数字遊戲,請輸入您猜測的数字。");

        let mut guess = String::new();

        io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

        let guess: u32 = guess.trim().parse().expect("請輸入一個数字!");

        println!("您猜測的数字是:{}", guess);

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("您猜測的数字太小了!"),
            Ordering::Greater => println!("您猜測的数字太大了!"),
            Ordering::Equal => println!("恭喜您,猜對了!"),
        }
    }
}

這裏修改得比較簡單,只需要添加一個名叫 loop 的關鍵字,然後把需要循環的內容放在 {} 中即可,然後我們測試一下:

cargo run                                    
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 0.38s
     Running `target/debug/guessing_game`
生成的隨機数字是:71
猜測数字遊戲,請輸入您猜測的数字。
50
您猜測的数字是:50
您猜測的数字太小了!
猜測数字遊戲,請輸入您猜測的数字。
71
您猜測的数字是:71
恭喜您,猜對了!
猜測数字遊戲,請輸入您猜測的数字。
45
您猜測的数字是:45
您猜測的数字太小了!
猜測数字遊戲,請輸入
t
thread 'main' panicked at '請輸入一個数字!: ParseIntError { kind: InvalidDigit }', src/libcore/result.rs:1165:5
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace.

我們的遊戲可以多次輸入了,但是有沒有發現一些問題呢?
1.遊戲直接告訴我們生成的数字了,那就不用猜了,直接輸入就好了。
2.當我們猜對后,遊戲沒有結束。
3.當我們輸入的內容不是数字的時候,才會結束遊戲,而且不僅打印了我們預期的錯誤信息,還打印了其它信息。
接下來,我們把這些問題依次修改,代碼如下:

use std::io;
use std::cmp::Ordering;
use rand::Rng;

fn main() {
    let secret_number = rand::thread_rng().gen_range(1, 101);

    // println!("生成的隨機数字是:{}", secret_number);

    loop {

        println!("猜測数字遊戲,請輸入您猜測的数字。");

        let mut guess = String::new();

        io::stdin().read_line(&mut guess).expect("讀取数字失敗!");

        let guess: u32 = match guess.trim().parse() {
            Ok(num) => num,
            Err(_) => continue,
        };

        println!("您猜測的数字是:{}", guess);

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("您猜測的数字太小了!"),
            Ordering::Greater => println!("您猜測的数字太大了!"),
            Ordering::Equal => {
                println!("恭喜您,猜對了!");
                break;
            }
        }
    }
}

這三處錯誤的修改方式依次是:
1.把打印隨機數的代碼註釋掉。
2.在做類型轉換時,使用 match 關鍵字作判斷,如果轉化成功,則返迴轉化后的結果,如果轉化失敗,不管因為什麼原因失敗,都直接跳出本次循環。
3.在做二個数字大小判斷時,如果判斷相等,則結束循環。
我們來測試一下修改的結果:

cargo run                                    
   Compiling guessing_game v0.1.0 (/Users/shanpengfei/work/rust-work-space/study/guessing_game)
    Finished dev [unoptimized + debuginfo] target(s) in 0.38s
     Running `target/debug/guessing_game`
猜測数字遊戲,請輸入您猜測的数字。
50
您猜測的数字是:50
您猜測的数字太小了!
猜測数字遊戲,請輸入您猜測的数字。
r
猜測数字遊戲,請輸入您猜測的数字。
75
您猜測的数字是:75
您猜測的数字太小了!
猜測数字遊戲,請輸入您猜測的数字。
87
您猜測的数字是:87
您猜測的数字太大了!
猜測数字遊戲,請輸入您猜測的数字。
81
您猜測的数字是:81
恭喜您,猜對了!

可以看到我們的遊戲製作完成了~~

歡迎閱讀單鵬飛的學習筆記

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

Python 深入淺出支持向量機(SVM)算法

相比於邏輯回歸,在很多情況下,SVM算法能夠對數據計算從而產生更好的精度。而傳統的SVM只能適用於二分類操作,不過卻可以通過核技巧(核函數),使得SVM可以應用於多分類的任務中。

本篇文章只是介紹SVM的原理以及核技巧究竟是怎麼一回事,最後會介紹sklearn svm各個參數作用和一個demo實戰的內容,盡量通俗易懂。至於公式推導方面,網上關於這方面的文章太多了,這裏就不多進行展開了~

1.SVM簡介

支持向量機,能在N維平面中,找到最明顯得對數據進行分類的一個超平面!看下面這幅圖:

如上圖中,在二維平面中,有紅和藍兩類點。要對這兩類點進行分類,可以有很多種分類方法,就如同圖中多條綠線,都可以把數據分成兩部分。

但SVM做的,是找到最好的那條線(二維空間),或者說那個超平面(更高維度的空間),來對數據進行分類。這個最好的標準,就是最大間距。

至於要怎麼找到這個最大間距,要找到這個最大間距,這裏大概簡單說一下,兩個類別的數據,到超平面的距離之和,稱之為間隔。而要做的就是找到最大的間隔。

這最終就變成了一個最大化間隔的優化問題。

2.SVM的核技巧

核技巧,主要是為了解決線性SVM無法進行多分類以及SVM在某些線性不可分的情況下無法分類的情況。

比如下面這樣的數據:

這種時候就可以使用核函數,將數據轉換一下,比如這裏,我們手動定義了一個新的點,然後對所有的數據,計算和這個新的點的歐式距離,這樣我們就得到一個新的數據。而其中,離這個新點距離近的數據,就被歸為一類,否則就是另一類。這就是核函數。

這是最粗淺,也是比較直觀的介紹了。通過上面的介紹,是不是和Sigmoid有點像呢?都是通過將數據用一個函數進行轉換,最終得到結果,其實啊,Sigmoid就是一鍾核函數來着,而上面說的那種方式,是高斯核函數。

這裏補充幾點:

  • 1.上面的圖中只有一個點,實際可以有無限多個點,這就是為什麼說SVM可以將數據映射到多維空間中。計算一個點的距離就是1維,2個點就是二維,3個點就是三維等等。。。
  • 2.上面例子中的紅點是直接手動指定,實際情況中可沒辦法這樣,通常是用隨機產生,再慢慢試出最好的點。
  • 3.上面舉例這種情況屬於高斯核函數,而實際常見的核函數還有多項式核函數,Sigmoid核函數等等。

OK,以上就是關於核技巧(核函數)的初步介紹,更高級的這裏也不展開了,網上的教程已經非常多了。

接下來我們繼續介紹sklearn中SVM的應用方面內容。

3.sklearn中SVM的參數

def SVC(C=1.0, 
             kernel='rbf', 
             degree=3, 
             gamma='auto_deprecated',
             coef0=0.0, 
             shrinking=True, 
             probability=False,
             tol=1e-3, 
             cache_size=200, 
             class_weight=None,
             verbose=False, 
             max_iter=-1, 
             decision_function_shape='ovr',
             random_state=None)
 
- C:類似於Logistic regression中的正則化係數,必須為正的浮點數,默認為 1.0,這個值越小,說明正則化效果越強。換句話說,這個值越小,越訓練的模型更泛化,但也更容易欠擬合。
- kernel:核函數選擇,比較複雜,稍後介紹
- degree:多項式階數,僅在核函數選擇多項式(即“poly”)的時候才生效,int類型,默認為3。
- gamma:核函數係數,僅在核函數為高斯核,多項式核,Sigmoid核(即“rbf“,“poly“ ,“sigmoid“)時生效。float類型,默認為“auto”(即值為 1 / n_features)。
- coef0:核函數的獨立項,僅在核函數為多項式核核Sigmoid核(即“poly“ ,“sigmoid“)時生效。float類型,默認為0.0。獨立項就是常數項。
- shrinking:不斷縮小的啟髮式方法可以加快優化速度。 就像在FAQ中說的那樣,它們有時會有所幫助,有時卻沒有幫助。 我認為這是運行時問題,而不是收斂問題。
- probability:是否使用概率評估,布爾類型,默認為False。開啟的話會評估數據到每個分類的概率,不過這個會使用到較多的計算資源,慎用!!
- tol:停止迭代求解的閾值,單精度類型,默認為1e-3。邏輯回歸也有這樣的一個參數,功能都是一樣的。
- cache_size:指定使用多少內存來運行,浮點型,默認200,單位是MB。
- class_weight:分類權重,也是和邏輯回歸的一樣,我直接就搬當時的內容了:分類權重,可以是一個dict(字典類型),也可以是一個字符串"balanced"字符串。默認是None,也就是不做任何處理,而"balanced"則會去自動計算權重,分類越多的類,權重越低,反之權重越高。也可以自己輸出一個字典,比如一個 0/1 的二元分類,可以傳入{0:0.1,1:0.9},這樣 0 這個分類的權重是0.1,1這個分類的權重是0.9。這樣的目的是因為有些分類問題,樣本極端不平衡,比如網絡攻擊,大部分正常流量,小部分攻擊流量,但攻擊流量非常重要,需要有效識別,這時候就可以設置權重這個參數。
- verbose:輸出詳細過程,int類型,默認為0(不輸出)。當大於等於1時,輸出訓練的詳細過程。僅當"solvers"參數設置為"liblinear"和"lbfgs"時有效。
- max_iter:最大迭代次數,int類型,默認-1(即無限制)。注意前面也有一個tol迭代限制,但這個max_iter的優先級是比它高的,也就如果限制了這個參數,那是不會去管tol這個參數的。
- decision_function_shape:多分類的方案選擇,有“ovo”,“ovr”兩種方案,也可以選則“None”,默認是“ovr”,詳細區別見下面。
- random_state:隨時數種子。

sklearn-SVM參數,kernel特徵選擇

kernel:核函數選擇,字符串類型,可選的有“linear”,“poly”,“rbf”,“sigmoid”,“precomputed”以及自定義的核函數,默認選擇是“rbf”。各個核函數介紹如下:
“linear”:線性核函數,最基礎的核函數,計算速度較快,但無法將數據從低維度演化到高維度
“poly”:多項式核函數,依靠提升維度使得原本線性不可分的數據變得線性可分
“rbf”:高斯核函數,這個可以映射到無限維度,缺點是計算量比較大
“sigmoid”:Sigmoid核函數,對,就是邏輯回歸裏面的那個Sigmoid函數,使用Sigmoid的話,其實就類似使用一個一層的神經網絡
“precomputed”:提供已經計算好的核函數矩陣,sklearn不會再去計算,這個應該不常用
“自定義核函數”:sklearn會使用提供的核函數來進行計算
說這麼多,那麼給個不大嚴謹的推薦吧
樣本多,特徵多,二分類,選擇線性核函數
樣本多,特徵多,多分類,多項式核函數
樣本不多,特徵多,二分類/多分類,高斯核函數
樣本不多,特徵不多,二分類/多分類,高斯核函數

當然,正常情況下,一般都是用交叉驗證來選擇特徵,上面所說只是一個較為粗淺的推薦。

sklearn-SVM參數,多分類方案

其實這個在邏輯回歸裏面已經有說過了,這裏還是多說一下。

原始的SVM是基於二分類的,但有些需求肯定是需要多分類。那麼有沒有辦法讓SVM實現多分類呢?那肯定是有的,還不止一種。

實際上二元分類問題很容易推廣到多元邏輯回歸。比如總是認為某種類型為正值,其餘為0值。

舉個例子,要分類為A,B,C三類,那麼就可以把A當作正向數據,B和C當作負向數據來處理,這樣就可以用二分類的方法解決多分類的問題,這種方法就是最常用的one-vs-rest,簡稱OvR。而且這種方法也可以方便得推廣到其他二分類模型中(當然其他算法可能有更好的多分類辦法)。

另一種多分類的方案是Many-vs-Many(MvM),它會選擇一部分類別的樣本和另一部分類別的樣本來做二分類。

聽起來很不可思議,但其實確實是能辦到的。比如數據有A,B,C三個分類。

我們將A,B作為正向數據,C作為負向數據,訓練出一個分模型。再將A,C作為正向數據,B作為負向數據,訓練出一個分類模型。最後B,C作為正向數據,C作為負向數據,訓練出一個模型。

通過這三個模型就能實現多分類,當然這裏只是舉個例子,實際使用中有其他更好的MVM方法。限於篇幅這裏不展開了。

MVM中最常用的是One-Vs-One(OvO)。OvO是MvM的特例。即每次選擇兩類樣本來做二元邏輯回歸。

對比下兩種多分類方法,通常情況下,Ovr比較簡單,速度也比較快,但模型精度上沒MvM那麼高。MvM則正好相反,精度高,但速度上比不過Ovr。

4.sklearn SVM實戰

我們還是使用鳶尾花數據集,不過這次只使用其中的兩種花來進行分類。首先準備數據:

import matplotlib.pyplot as plt
import numpy as np
from sklearn import svm,datasets
import pandas as pd
tem_X = iris.data[:, :2]
tem_Y = iris.target
new_data = pd.DataFrame(np.column_stack([tem_X,tem_Y]))
#過濾掉其中一種類型的花
new_data = new_data[new_data[2] != 1.0]
#生成X和Y
X = new_data[[0,1]].values
Y = new_data[[2]].values

然後用數據訓練,並生成最終圖形


# 擬合一個SVM模型
clf = svm.SVC(kernel='linear')
clf.fit(X, Y)

# 獲取分割超平面
w = clf.coef_[0]
# 斜率
a = -w[0] / w[1]
# 從-5到5,順序間隔採樣50個樣本,默認是num=50
# xx = np.linspace(-5, 5)  # , num=50)
xx = np.linspace(-2, 10)  # , num=50)
# 二維的直線方程
yy = a * xx - (clf.intercept_[0]) / w[1]
print("yy=", yy)

# plot the parallels to the separating hyperplane that pass through the support vectors
# 通過支持向量繪製分割超平面
print("support_vectors_=", clf.support_vectors_)
b = clf.support_vectors_[0]
yy_down = a * xx + (b[1] - a * b[0])
b = clf.support_vectors_[-1]
yy_up = a * xx + (b[1] - a * b[0])

# plot the line, the points, and the nearest vectors to the plane
plt.plot(xx, yy, 'k-')
plt.plot(xx, yy_down, 'k--')
plt.plot(xx, yy_up, 'k--')

plt.scatter(clf.support_vectors_[:, 0], clf.support_vectors_[:, 1], s=80, facecolors='none')


plt.scatter(X[:, 0].flat, X[:, 1].flat, c='#86c6ec', cmap=plt.cm.Paired)
# import operator
# from functools import reduce
# plt.scatter(X[:, 0].flat, X[:, 1].flat, c=reduce(operator.add, Y), cmap=plt.cm.Paired)

plt.axis('tight')
plt.show()

最終的SVM的分類結果如下:

以上~

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※高價收購3C產品,價格不怕你比較

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

PHP安全之道學習筆記2:編碼安全指南

編碼安全指南

編程本身就應該是一門藝術,而安全編程更是一種在刀尖上舞蹈的藝術,不僅要小心腳下的鋒利寒刃,更要小心來自網絡黑客或攻擊者的狂轟亂炸。
– by code artist

  • 1.hash比較的缺陷
    經過試驗發現,當Hash值以”0e”開頭且後面都為数字,當和数字進行比較的時候總會被判斷和0相等

例如:

var_dump(‘0e1327544’ == 0); // bool(true)

當密碼被md5計算后,可能會以”0e”開頭,下面這個例子可以繞過密碼驗證。
經過我的驗證PHP 7.1.x后沒有這種問題。

<?php
    $password_from_db = "0e23434";
    $password = "2323"; // 隨意的一個密碼。來自$_POST,即表單提交
    if ($password_from_db == md5($password)) {
        echo "login success!";
    } else {
        echo "login fails";
    }

更安全的hash比較:
可以使用內置函數hash_equals()來比較hash值。(PHP版本必須是5.6及其以上)

 if (hash_equals($password_from_db, md5($password)) {
     .....// other logic
 }
  • 2.bool比較的缺陷

json_decode和unserialize函數可能將部分結構解析成bool值,造成一些比較上的缺陷。

先舉例json_decode的案例:

<?php
$str = '{"user":true, "pass": true}';

$data = json_decode($str, true);

if ($data['user'] == 'root' && $data['pass'] == 'pass') {
    echo "login success\r\n";
} else {
    echo "login fails\r\n";
}

執行結果為:login success
這樣利用bool比較的漏洞就繞過了登錄或者授權驗證。

unserialize過程相逆,結果類似,也會出現安全問題。

正確的做法還是使用”===”來進行比較,這不光是php,包括一些其他腳本語言或者靜態語言,都請嚴謹地使用全等於符號進行比較。

  • 3.數值比較

PHP雖然是弱類型語言,但是數據類型也有數值範圍。對於整型而言,最大值為PHP_INT_MAX(即9223372036854775807)
攻擊者可以利用最大值越界,繞過一些驗證,如登錄、賬號充值等等。

舉例:

$a = 9223372036854775807;
$b = 9223372036854775827;
var_dump($a === $b); // bool(true)
var_dump($a % 100); // int(0)

由此,可見全等號(===)也不是萬能的,具體場景下要更小心。經驗證,PHP7.1.x后不會出現該問題,5.x的可能出現。

在實際業務邏輯裏面一定要注意判斷最大值問題,避免越界帶來的問題。

當使用超長浮點數變量的時候,PHP也會出錯。

<?php
$uid = 0.999999999999999999;
if ($uid == "1") {
    echo "search uid is 1 for data\r\n"; // 這裏PHP將$uid約等於1了,進入該判斷條件里的邏輯
}

同理,2.999999999999也會被當成3,這就是超越浮點數精度造成的偏差。

解決辦法有很多,最簡單的就是用is_int()函數進行判斷,如果不是整型,則報錯或做錯誤處理。

  • 4.switch缺陷

當用case判斷数字的時候,switch會把參數轉換成int類型進行計算,代碼如下:

<?php
$num = "1FreePHP";
switch ($num) {
    case 0: echo "nothing";
        break;
    case 1: echo "1 hacker here!";
        break;
    case 2: echo "2 hackers here";
        break;
    default:
        echo "confused";
}

最後輸出:1 hacker here!

所以,請使用is_numeric()函數進行判斷,保證數據類型如預期的一致。

  • 5.數組缺陷。
    in_array()和array_search()函數在沒有使用嚴格模式的情況下會用鬆散比較,可能造成一些錯誤。
    例如:
<?php
$arr = [0, 2, 3, "4"];
var_dump(in_array('freephp', $arr)); // true
var_dump(array_search('freephp', $arr)); // 0: 下標
var_dump(in_array('2freephp', $arr)); // true
var_dump(array_search('3freephp', $arr)); // 2: 下標

總的來說,PHP工程師對於這種弱類型語言的使用上要更加小心,雖然平時寫起業務來“短平快”,但安全編程也不要忘記,能用上hint的高版本PHP就進行標註清楚入參、出參,讓PHP代碼更加健壯。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※平板收購,iphone手機收購,二手筆電回收,二手iphone收購-全台皆可收購

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

HTTP基礎及telnet簡單命令

一、HTTP概況


  20世紀90年代初期,一個主要的新興應用即萬維網(World Wide Web)登上了舞台。Web是一個引起公眾注意的因特網應用。Web的應用層協議是超文本傳輸協議(HTTP),它是Web的核心。HTTP由兩個程序實現:一個客戶程序和一個服務器程序。客戶程序和服務器程序運行在不同的端系統中,通過交換HTTP報文進行會話。HTTP會話定義了這些報文的結構以及客戶和服務器進行報文交換的方式。

  Web頁面(也叫文檔)是由對象組成的。一個對象只是一個文件,諸如一個HTML文件、一個JPEG圖形、一個Java小程序或一個視頻片段這樣的文件,且他們可通過一個URL地址尋址。多數Web頁面含有一個HTML基本文件以及幾個引用對象。例如,如果一個Web頁面包含HTML基本文件和5個JPEG圖形,那麼這個Web頁面6個對象:一個HTML基本文件加5個圖形。HTML基本文件通過對象的URL地址引用頁面中的其他對象。每個URL地址由兩部分組成:存放對象的服務器主機名和對象的路徑名。Web瀏覽器實現了HTTP的客戶端,Web服務器實現了HTTP的服務器端,它用於存儲Web對象,每個對象由URL尋址。

  HTTP定義了Web客戶向Web服務器請求Web頁面的方式,以及服務器向客戶傳送Web頁面的方式,其基本思想就是當用戶請求一個Web頁面(如點擊一個超鏈接)時,瀏覽器向服務器發出對該頁面中所包含對象的HTTP請求報文,服務器接收到請求並用包含這些對象的HTTP響應報文進行響應。

  HTTP使用TCP作為它的支撐運輸協議(而不是在UDP上運行)。HTTP客戶首先發起一個與服務器的TCP連接。一旦連接建立,該瀏覽器和服務器進程就可以通過套接字接口訪問TCP。客戶向它的套接字接口發送HTTP請求報文並從它的套接字接口接收HTTP響應報文。類似的,服務器從它的套接字接口接收HTTP請求報文和向它的套接字接口發送HTTP響應報文。一旦客戶向他的套接字接口發送了一個請求報文,該報文就脫離了客戶控制並進入TCP的控制。TCP為HTTP提供可靠數據傳輸服務。這意味着,一個客戶進程發出的每個HTTP請求報文最終能完整地到達服務器;類似的,服務器進程發出的每個HTTP響應報文最終能完整地到達客戶。

  注意到下列現象很重要:服務器向客戶發送被請求的文件,而不存儲任何關於該客戶的狀態信息。假如某個特定的客戶在短短的幾秒鐘內兩次請求同一個對象,服務器並不會因為剛剛為該客戶提供了該對象就不再做出反應,而是重新發送該對象,就像服務器已經完全忘記不久之前所做過的事一樣。因為HTTP服務器並不保存關於客戶的任何信息,所以我們說HTTP是一個無狀態協議。


二、非持續連接和持續連接


  在許多因特網應用程序中,客戶和服務器在一個相當長的時間範圍內通信,其中客戶發出一系列請求並且服務器對每個請求進行響應。依據應用程序以及該應用程序的使用方式,這一系列請求可以以規則的間隔周期性的或者間斷性的一個接一個發出。當這種客戶-服務器的交互是經TCP進行的,應用程序的研製者就要做一個重要決定,即每個請求/響應對是經一個單獨的TCP連接發送,還是所有的請求及其相應經相同的TCP連接發送呢?採用前一種方法,該應用程序被稱為使用非持續連接;採用后一種方法,該應用程序被稱為使用持續連接。如HTTP既能夠使用非持續連接,也能夠使用持續連接。儘管HTTP在默認方式下使用持續連接,HTTP客戶和服務器也能配置成非持續連接。

1.採用非持續連接的HTTP

  我們看看在非持續連接情況下,從服務器向客戶傳送一個Web頁面的步驟。假設該頁面含有一個HTML基本文件和10個JPEG圖形,並且這11個對象位於同一台服務器上。該HTML文件的URL為:。我們看看發生了什麼情況:

  • HTTP客戶進程在端口號80發起一個到服務器的TCP連接,該端口號是HTTP的默認端口。在客戶和服務器上分別有一個套接字與該連接相關聯。

  • HTTP客戶經它的套接字向該服務器發送一個HTTP請求報文。請求報文中包含了路徑名/someDepartment/home.index。

  • HTTP服務器進程經它的套接字接收該請求報文,從其存儲器(RAM或磁盤)中檢索出對象,在一個HTTP響應報文中封裝對象,並通過其套接字向客戶發送響應報文。

  • HTTP服務器進程通知TCP斷開該TCP連接。(但是直到TCP確認客戶已經完整的收到響應報文為止,它才會實際中斷連接。

  • HTTP客戶接收響應報文,TCP連接關閉。該報文指出封裝的對象是一個HTML文件,客戶從響應報文中提取出該文件,檢查該HTML文件,得到對10個JPEG圖形的引用。

  • 對每個引用的JPEG圖形對象重複前4個步驟。

  上面的步驟舉例說明了非持續連接的使用,其中每個TCP連接在服務器發送一個對象后關閉,即該連接並不為其他的對象而持續下來。值得注意的是每個TCP來接只傳輸一個請求報文和響應報文。

     在上面描述的步驟中,我們有意沒有明確客戶獲得這10個JPEG圖形對象是使用10個串行的TCP連接,還是某些JPEG對象使用了一些并行的TCP連接。事實上,用戶能配置現代瀏覽器以控制并行度。在默認方式下,大部分瀏覽器打開5~10個并行的TCP連接,而每條連接處理一個請求響應事務。如果用戶願意,最大并行連接數可以設置為1,這樣10條連接就會串行建立。

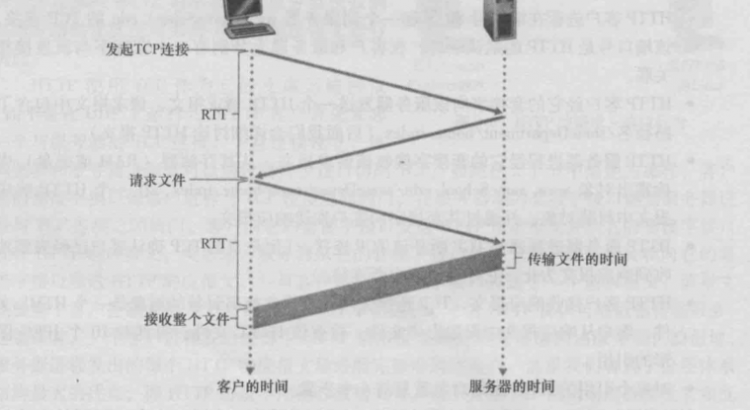
  我們來簡單估算一下從客戶請求HTML基本文件起到該客戶收到整個文件止所花費的時間。為此,我們給出往返時間(Round-Trip Time,RTT)的定義,該時間是指一個短分組從客戶到服務器然後再返回客戶所花費的時間。RTT包括分組傳播時延、分組在中間路由器和交換機上的排隊時延以及分組處理時延。現在考慮當用戶點擊超鏈接時會發生什麼現象。如圖2-7所示,這引起瀏覽器在它和Web服務器之間發起一個TCP連接;這涉及一次“三次握手”過程。即客戶向服務器發送一個小TCP報文段,服務器用一個小TCP報文段做出確認和響應,最後,客戶向服務器返回確認。三次握手中前兩個部分所耗費的時間佔用了一個RTT。完成了三次握手的前兩個部分后,客戶結合三次握手的第三部分(確認)向該TCP連接發送一個HTTP請求報文。一旦該請求報文到達服務器,服務器就在該TCP連接上發送HTML文件。該HTTP請求/響應用去了另一個RTT。因此,粗略地將,總的響應時間就是兩個RTT加上服務器傳輸HTML文件的時間。

2.採用持續連接的HTTP

  非持續連接有一些缺點。首先,必須為每一個請求的對象建立和維護一個全新的連接。對於每個這樣的連接,在客戶和服務器中都要分配TCP的緩衝區和保持TCP變量,這給Web服務器帶來了嚴重的負擔,因為一台Web服務器可能同時服務於數以百計不同的客戶的請求。第二,就像我們剛描述的那樣,每一個對象經受兩倍RTT的交付時延,即一個RTT用於創建TCP,另一個RTT用於請求和接收一個對象。

  在採用持續連接的情況下,服務器在發送響應后保持該TCP連接打開。在相同的客戶與服務器之間的後續請求和響應報文能夠通過相同的連接進行傳送。特別是,一個完整的Web頁面(上例中的HTML基本文件加上10個圖形)可以用單個持續TCP連接進行傳送。更有甚者,位於同一台服務器的多個Web頁面在從該服務器發送給同一個客戶時,可以在單個持續TCP連接上進行。可以一個接一個地發出對對象的這些請求,而不必等待對未決請求(流水線)的回答。一般來說,如果一條連接經過一定的時間間隔(一個可配置的超時間隔)仍未被使用,HTTP服務器就關閉該連接。HTTP的默認模式是使用帶流水線的持續連接。

三、HTTP報文格式

  HTTP報文有兩種:請求報文和響應報文。

1.HTTP請求報文

  下面提供了一個典型的HTTP請求報文:

GET /somedir/page.html HTTP/1.1

Host:

Connection: close

User-agent: Mozilla/5.0

Accept-language: fr

  通過仔細觀察這個簡單的請求報文,我們就能知道很多東西。首先,我們看到該報文是用普通的ASCII文本書寫的,我們看到該報文由5行組成,每行由一個回車和換行符結束。最後一行后再附加一個回車換行符。一個請求報文能夠具有更多的行或者至少為一行。請求行的方法字段可以取幾種不同的值,包括GET、POST、HEAD、PUT和DELETE。當瀏覽器請求一個對象時,使用GET方法,在URL字段帶有請求對象的標識,在本例中,該瀏覽器正在請求對象/somedir/page.html。其版本字段是自解釋的;在本例中,瀏覽器實現的是HTTP/1.1版本。現在我們看看本例的首部行。首部行Host: 指明了對象所在的主機。你也許認為該首部行是不必要的,因為在該主機中已經有一條TCP連接存在了,但是,該首部行提供的信息是Web代理高速緩存所要求的。通過包含Connection: close首部行,該瀏覽器告訴服務器不希望麻煩地使用持續連接,它要求服務器在發送完被請求的對象后就關閉這條連接。User-agent: 首部行用來指明用戶代理,即向服務器發送請求的瀏覽器類型。這裏瀏覽器類型是Mozilla/5.0,即Firefox瀏覽器。這個首部行是有用的,因為服務器可以有效地為不同類型的用戶代理實際發送相同對象的不同版本。(每個版本都由相同的URL尋址。)最後,Accept-language: 首部行表示用戶想得到該對象的法語版本。如果服務器中沒有這樣的對象的話,服務器應當發送它的默認版本。

  接下來看看如圖2-8所示的一個請求報文的通用格式。你可能注意到了在首部行(和附加的回車和換行)後有一個“實體主體”。使用GET方法是實體主體為空,而使用POST方法時才使用該實體主體。當用戶提交表單時,HTTP客戶常常使用POST方法,例如當用戶向搜索引擎提供搜索關鍵詞時。使用POST報文時,用戶仍可以向服務器請求一個Web頁面,但Web頁面的特定內容依賴於用戶在表單字段中輸入的內容。如果方法字段的值為POST時,則實體主體中包含的就是用戶在表單字段中的輸入值。

  當然,如果不提“用表單生成的請求報文不是必須使用POST方法”這一點,那將是失職。HTML表單經常使用GET方法,並在(表單字段中)所請求的URL中包括輸入的數據。例如,一個表單使用GET方法,它有兩個字段,分別填寫的是“monkeys”和“bananas”,這樣,該URL結構為? monkeys&bananas。

  HEAD方法類似GET方法。當服務器收到使用HEAD方法的請求時,將會用一個HTTP報文進行響應,但是並不返回請求對象。應用程序開發者常用HEAD方法進行調試跟蹤。PUT方法常與Web發行工具聯合使用,它允許用戶上傳對象到指定的Web服務器上指定的路徑(目錄)。PUT也被那些需要向Web服務器上傳對象的應用程序使用。DELETE方法允許用戶或者應用程序刪除Web服務器上的對象。

2.HTTP響應報文

  下面我們提供了一條典型的HTTP響應報文。該響應報文可以是對剛剛討論的例子中請求報文的響應。

HTTP/1.1 200 OK

Connection: close

Date: Tue, 09 Aug 2011 15:44:04 GMT

Server: Apache/2.2.3 (CentOS)

Last-Modified: Tue, 09 Aug 2011 15:11:03 GMT

Content-Length: 6821

Content-Type: text/html

(data data data data data …)

  我們仔細看這個響應報文。實體主體部分是報文的主要部分,即它包含了所請求的對象本身(表示為data data data data data …)。我們現在來看看首部行。服務器用Connection:close首部行告訴客戶,發送完報文後將關閉該TCP連接。Date:首部行指示服務器產生併發送該響應報文的日期和時間。值得一提的是,這個時間不是指對象創建或者最後修改的時間;而是服務器從它的文件系統中檢索到該對象,插入到響應報文,併發送響應報文的時間。Server:首部行指示該報文是由一台Apache Web服務器產生的,它類似於HTTP請求報文中的User-agent:首部行,Last-Modified:首部行指示了對象創建或者最後修改的日期和時間。Last-Modified:首部行對極可能在本地客戶也可能在網絡緩存服務器(代理服務器)上的對象緩存來說非常重要。Content-Length:首部行知識了被發送對象中的字節數。Content-Type:首部行指示了實體主體中的對象是HTML文本。(該對象類型應該正式地由Content-Type:首部行而不是用文件擴展名來指示。)

  看過一個例子后,我們再來查看響應報文的通用格式(如圖2-9所示)。我們補充說明一下狀態碼和它們對應的短語。狀態碼及其相應的短語指示了請求的結果。一些常見的狀態碼和相關的短語包括:

  • 200 OK:請求成功,信息在返回的響應報文中。

  • 301 Moved Permanently:請求的對象已經被永久轉移了,新的URL定義在響應報文的Location:首部行中。**客戶軟件將自動獲取新的URL。

  • 400 Bad Request:一個通用差錯代碼,指示該請求不能被服務器理解。

  • 404 Not Found:被請求的文檔不在服務器上。

  • 505 HTTP Version Not Supported:服務器不支持請求報文使用的HTTP協議版本。

  你想看一下真正的HTTP響應報文嗎?很容易做到。首先用Telnet登錄到你喜歡的Web服務器上,接下來輸入一個只有一行的請求報文去請求放在該服務器上的某些對象。

  在linux終端輸入完telnet 80后,會是下面這種情況:

  然後按下ctrl + ]呼出telnet命令行出現下面這種情況:

  先按下回車鍵,再輸入HTTP請求,最終得到HTTP響應如下:

  在telnet命令行上輸入quit退出telnet,如下圖:


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

設計模式之美學習(九):業務開發常用的基於貧血模型的MVC架構違背OOP嗎?

我們都知道,很多業務系統都是基於 MVC 三層架構來開發的。實際上,更確切點講,這是一種基於貧血模型的 MVC 三層架構開發模式。

雖然這種開發模式已經成為標準的 Web 項目的開發模式,但它卻違反了面向對象編程風格,是一種徹徹底底的面向過程的編程風格,因此而被有些人稱為反模式(anti-pattern)。特別是領域驅動設計(Domain Driven Design,簡稱 DDD)盛行之後,這種基於貧血模型的傳統的開發模式就更加被人詬病。而基於充血模型的 DDD 開發模式越來越被人提倡。

基於上面的描述,我們先搞清楚下面幾個問題:

  • 什麼是貧血模型?什麼是充血模型?
  • 為什麼說基於貧血模型的傳統開發模式違反 OOP?
  • 基於貧血模型的傳統開發模式既然違反 OOP,那又為什麼如此流行?
  • 什麼情況下我們應該考慮使用基於充血模型的 DDD 開發模式?

什麼是基於貧血模型的傳統開發模式?

對於大部分的後端開發工程師來說,MVC 三層架構都不會陌生。

MVC 三層架構中的 M 表示 Model,V 表示 View,C 表示 Controller。它將整個項目分為三層:展示層、邏輯層、數據層。MVC 三層開發架構是一個比較籠統的分層方式,落實到具體的開發層面,很多項目也並不會 100% 遵從 MVC 固定的分層方式,而是會根據具體的項目需求,做適當的調整。

比如,現在很多 Web 或者 App 項目都是前後端分離的,後端負責暴露接口給前端調用。這種情況下,我們一般就將後端項目分為 Repository 層、Service 層、Controller 層。其中,Repository 層負責數據訪問,Service 層負責業務邏輯,Controller 層負責暴露接口。當然,這隻是其中一種分層和命名方式。不同的項目、不同的團隊,可能會對此有所調整。不過,萬變不離其宗,只要是依賴數據庫開發的 Web 項目,基本的分層思路都大差不差。

再來看一下,什麼是貧血模型?

目前幾乎所有的業務後端系統,都是基於貧血模型的。舉一個簡單的例子來解釋一下。

////////// Controller+VO(View Object) //////////
public class UserController {
  private UserService userService; //通過構造函數或者IOC框架注入
  
  public UserVo getUserById(Long userId) {
    UserBo userBo = userService.getUser(userId);
    UserVo userVo = [...convert userBo to userVo...];
    return userVo;
  }
}

public class UserVo {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

////////// Service+BO(Business Object) //////////
public class UserService {
  private UserRepository userRepository; //通過構造函數或者IOC框架注入
  
  public UserBo getUserById(Long userId) {
    UserEntity userEntity = userRepository.getUserById(userId);
    UserBo userBo = [...convert userEntity to userBo...];
    return userBo;
  }
}

public class UserBo {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

////////// Repository+Entity //////////
public class UserRepository {
  public UserEntity getUserById(Long userId) { //... }
}

public class UserEntity {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

平時開發 Web 後端項目的時候,基本上都是這麼組織代碼的。其中,UserEntity 和 UserRepository 組成了數據訪問層,UserBo 和 UserService 組成了業務邏輯層,UserVo 和 UserController 在這裏屬於接口層。

從代碼中可以發現,UserBo 是一個純粹的數據結構,只包含數據,不包含任何業務邏輯。業務邏輯集中在 UserService 中。我們通過 UserService 來操作 UserBo。換句話說,Service 層的數據和業務邏輯,被分割為 BO 和 Service 兩個類中。像 UserBo 這樣,只包含數據,不包含業務邏輯的類,就叫作貧血模型(Anemic Domain Model)。同理,UserEntity、UserVo 都是基於貧血模型設計的。這種貧血模型將數據與操作分離,破壞了面向對象的封裝特性,是一種典型的面向過程的編程風格。

什麼是基於充血模型的 DDD 開發模式?

首先,我們先來看一下,什麼是充血模型?

在貧血模型中,數據和業務邏輯被分割到不同的類中。充血模型(Rich Domain Model)正好相反,數據和對應的業務邏輯被封裝到同一個類中。因此,這種充血模型滿足面向對象的封裝特性,是典型的面向對象編程風格。

接下來,再來看一下,什麼是領域驅動設計?

領域驅動設計,即 DDD,主要是用來指導如何解耦業務系統,劃分業務模塊,定義業務領域模型及其交互。領域驅動設計這個概念並不新穎,早在 2004 年就被提出了,到現在已經有十幾年的歷史了。不過,它被大眾熟知,還是基於另一個概念的興起,那就是微服務。

除了監控、調用鏈追蹤、API 網關等服務治理系統的開發之外,微服務還有另外一個更加重要的工作,那就是針對公司的業務,合理地做微服務拆分。而領域驅動設計恰好就是用來指導劃分服務的。所以,微服務加速了領域驅動設計的盛行。

領域驅動設計有點兒類似敏捷開發、SOA、PAAS 等概念,聽起來很高大上,但實際上只值“五分錢”。即便你沒有聽說過領域驅動設計,對這個概念一無所知,只要你是在開發業務系統,也或多或少都在使用它。做好領域驅動設計的關鍵是,看你對自己所做業務的熟悉程度,而並不是對領域驅動設計這個概念本身的掌握程度。即便你對領域驅動搞得再清楚,但是對業務不熟悉,也並不一定能做出合理的領域設計。所以,不要把領域驅動設計當銀彈,不要花太多的時間去過度地研究它。

實際上,基於充血模型的 DDD 開發模式實現的代碼,也是按照 MVC 三層架構分層的。Controller 層還是負責暴露接口,Repository 層還是負責數據存取,Service 層負責核心業務邏輯。它跟基於貧血模型的傳統開發模式的區別主要在 Service 層。

在基於貧血模型的傳統開發模式中,Service 層包含 Service 類和 BO 類兩部分,BO 是貧血模型,只包含數據,不包含具體的業務邏輯。業務邏輯集中在 Service 類中。在基於充血模型的 DDD 開發模式中,Service 層包含 Service 類和 Domain 類兩部分。Domain 就相當於貧血模型中的 BO。不過,Domain 與 BO 的區別在於它是基於充血模型開發的,既包含數據,也包含業務邏輯。而 Service 類變得非常單薄。總結一下的話就是,基於貧血模型的傳統的開發模式,重 Service 輕 BO;基於充血模型的 DDD 開發模式,輕 Service 重 Domain。

為什麼基於貧血模型的傳統開發模式如此受歡迎?

基於貧血模型的傳統開發模式,將數據與業務邏輯分離,違反了 OOP 的封裝特性,實際上是一種面向過程的編程風格。但是,現在幾乎所有的 Web 項目,都是基於這種貧血模型的開發模式,甚至連 Java Spring 框架的官方 demo,都是按照這種開發模式來編寫的。

面向過程編程風格有種種弊端,比如,數據和操作分離之後,數據本身的操作就不受限制了。任何代碼都可以隨意修改數據。既然基於貧血模型的這種傳統開發模式是面向過程編程風格的,那它又為什麼會被廣大程序員所接受呢?

第一點原因是,大部分情況下,我們開發的系統業務可能都比較簡單,簡單到就是基於 SQL 的 CRUD 操作,所以,我們根本不需要動腦子精心設計充血模型,貧血模型就足以應付這種簡單業務的開發工作。除此之外,因為業務比較簡單,即便我們使用充血模型,那模型本身包含的業務邏輯也並不會很多,設計出來的領域模型也會比較單薄,跟貧血模型差不多,沒有太大意義。

第二點原因是,充血模型的設計要比貧血模型更加有難度。因為充血模型是一種面向對象的編程風格。我們從一開始就要設計好針對數據要暴露哪些操作,定義哪些業務邏輯。而不是像貧血模型那樣,我們只需要定義數據,之後有什麼功能開發需求,我們就在 Service 層定義什麼操作,不需要事先做太多設計。

第三點原因是,思維已固化,轉型有成本。基於貧血模型的傳統開發模式經歷了這麼多年,已經深得人心、習以為常。你隨便問一個旁邊的大齡同事,基本上他過往參与的所有 Web 項目應該都是基於這個開發模式的,而且也沒有出過啥大問題。如果轉向用充血模型、領域驅動設計,那勢必有一定的學習成本、轉型成本。很多人在沒有遇到開發痛點的情況下,是不願意做這件事情的。

什麼項目應該考慮使用基於充血模型的 DDD 開發模式?

基於貧血模型的傳統的開發模式,比較適合業務比較簡單的系統開發。相對應的,基於充血模型的 DDD 開發模式,更適合業務複雜的系統開發。比如,包含各種利息計算模型、還款模型等複雜業務的金融系統。

這兩種開發模式,落實到代碼層面,區別不就是一個將業務邏輯放到 Service 類中,一個將業務邏輯放到 Domain 領域模型中嗎?為什麼基於貧血模型的傳統開發模式,就不能應對複雜業務系統的開發?而基於充血模型的 DDD 開發模式就可以呢?

實際上,除了我們能看到的代碼層面的區別之外(一個業務邏輯放到 Service 層,一個放到領域模型中),還有一個非常重要的區別,那就是兩種不同的開發模式會導致不同的開發流程。基於充血模型的 DDD 開發模式的開發流程,在應對複雜業務系統的開發的時候更加有優勢。為什麼這麼說呢?先來回憶一下,我們平時基於貧血模型的傳統的開發模式,都是怎麼實現一個功能需求的。

不誇張地講,我們平時的開發,大部分都是 SQL 驅動(SQL-Driven)的開發模式。我們接到一個後端接口的開發需求的時候,就去看接口需要的數據對應到數據庫中,需要哪張表或者哪幾張表,然後思考如何編寫 SQL 語句來獲取數據。之後就是定義 Entity、BO、VO,然後模板式地往對應的 Repository、Service、Controller 類中添加代碼。

業務邏輯包裹在一個大的 SQL 語句中,而 Service 層可以做的事情很少。SQL 都是針對特定的業務功能編寫的,復用性差。當我要開發另一個業務功能的時候,只能重新寫個滿足新需求的 SQL 語句,這就可能導致各種長得差不多、區別很小的 SQL 語句滿天飛。

所以,在這個過程中,很少有人會應用領域模型、OOP 的概念,也很少有代碼復用意識。對於簡單業務系統來說,這種開發方式問題不大。但對於複雜業務系統的開發來說,這樣的開發方式會讓代碼越來越混亂,最終導致無法維護。

如果我們在項目中,應用基於充血模型的 DDD 的開發模式,那對應的開發流程就完全不一樣了。在這種開發模式下,我們需要事先理清楚所有的業務,定義領域模型所包含的屬性和方法。領域模型相當於可復用的業務中間層。新功能需求的開發,都基於之前定義好的這些領域模型來完成。

越複雜的系統,對代碼的復用性、易維護性要求就越高,我們就越應該花更多的時間和精力在前期設計上。而基於充血模型的 DDD 開發模式,正好需要我們前期做大量的業務調研、領域模型設計,所以它更加適合這種複雜系統的開發。

重點回顧

平時做 Web 項目的業務開發,大部分都是基於貧血模型的 MVC 三層架構,這裏把它稱為傳統的開發模式。之所以稱之為“傳統”,是相對於新興的基於充血模型的 DDD 開發模式來說的。基於貧血模型的傳統開發模式,是典型的面向過程的編程風格。相反,基於充血模型的 DDD 開發模式,是典型的面向對象的編程風格。

不過,DDD 也並非銀彈。對於業務不複雜的系統開發來說,基於貧血模型的傳統開發模式簡單夠用,基於充血模型的 DDD 開發模式有點大材小用,無法發揮作用。相反,對於業務複雜的系統開發來說,基於充血模型的 DDD 開發模式,因為前期需要在設計上投入更多時間和精力,來提高代碼的復用性和可維護性,所以相比基於貧血模型的開發模式,更加有優勢。

思考

  • 對於舉的例子中,UserEntity、UserBo、UserVo 包含的字段都差不多,是否可以合併為一個類呢?

參考:

本文由博客一文多發平台 發布!
更多內容請點擊我的博客

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

Python中lambda的使用,與它的三個好基友介紹!

匿名函數lambda

除了def語句,python還提供了一種生成函數對象的表達式形式。由於它與LISP語言中的一個工具類似,所以稱為lambda。

就像def一樣,這個表達式創建了一個之後能夠調用的函數,但是它返回一個函數而不是將這個函數賦值給一個變量。這些就是lambda叫做匿名函數的原因。實際上,他常常以一種行內進行函數定義的方式使用,或者用作推遲執行一些代碼。

lambda的一般形式是關鍵字lambda之後跟着一個或多個參數(與一個def頭部內用括號括起來的參數列表類似),緊跟着是一個冒號,之後是表達式

lambda arg1,arg2,argn:expression using arguments

由lambda表達式所返回的函數對象與由def創建並複製后的函數對象工作起來是完全一致的,但lambda有一些不同之處,讓其扮演特定的角色時更有用:

lambda是一個表達式,而不是一個語句

因為這一點,lambda可以出現在python語法不允許def出現的地方。
此外,作為一個表達式,lambda返回一個值(一個新的函數),可以選擇性的賦值給一個變量
相反,def語句總是得在頭部將一個新的函數賦值給一個變量,而不是將這個函數作為結果返回。

lambda的主題是單個表達式,而不是一個代碼塊

這個lambda的主題簡單的就好像放在def主體return語句中的代碼一樣。
簡單的將結果寫成一個順暢的表達式,而不是明確的返回。
但由於它僅限於表達式,故lambda通常要比def功能少…你僅能夠在lambda主體中封裝有限的邏輯進去,因為他是一個為編寫簡單函數而設計的。
除了上述這些差別,def和lambda都能過做同樣種類的工作

def與lambda的相同用法

x = lambda x, y, z: x + y + z
x(2, 3, 4)
>>> 9

y = (lambda a='hello', b='world': a + b)
y(b='Python')
>>> 'hellopython'

為什麼使用lambda

看過上面的兩個小例子,很多人會說這個和def沒什麼差別,我們又為什麼要使用lambda呢?

通常來說,lambda起到一種函數的速寫作用,允許在使用的代碼內嵌一個函數的定義,他完全是可選的(是可以使用def代替他們),但是在你僅需要切入一段可執行代碼的情況下,它會帶來一個更簡潔的書寫效果。

lambda通常用來編寫跳轉表,也就是行為的列表或者字典,能夠按照需求執行操作,比如:

l = [lambda x: x ** 2, lambda x: x ** 3, lambda x: x ** 4]
for f in l:
    print(f(2))
>>> 4
>>> 8
>>> 16
print(l[0](3))
>>> 9

當需要把小段的可執行代碼編寫進def語句從語法上不能實現的地方是,lambda表達式作為def的一種速寫來說,是最為有用的,如果上面的代碼用def編寫,則變為:

def f1(x):
    return x ** 2
 
def f2(x):
    return x ** 3
 
def f3(x):
    return x ** 4
 
l = [f1, f2, f3]

for f in l:
    print(f(2))
print(l[0](3))

實際上,我們可以用python中的字典或者其他的數據結構來構建更多種類的行為表,從而做同樣的事情。

lambda中實現if-else

Python中具備的單行表達式:if a:b else c語法在lambda中同樣適用:

lower = lambda x,y:x if x<y else y
lower(4,5)
>>> 4

看了半天,大家可能也並未覺得lambda在python中到底比def優越與便利在哪裡,那麼說到lambda,就必須要提及三個函數map、filter、reduce,當你接觸了這三個函數,那麼你才能感受到lambda真實的方便之處

map 函數

程序對列表或者其他序列常常要做的一件事就是對每個元素進行一個操作,並把其結果集合起來。
python提供了一個工具map,它會對一個序列對象中的每一個元素應用該的函數,並返回一個包含了所有函數調用結果的列表。

舉個栗子,我們有一個列表,需要將列表的每一個字段+10,我們該如何操作?

list_show = [1, 2, 3, 4]
# 方式1
new_list_show = []
for i in list_show:
    new_list_show.append(i + 10)

print(new_list_show)

# 方式2
def adds(x):
    return x + 10

print(list(map(adds, list_show)))

# 更優雅的方式3:
print(list(map(lambda x: x + 10, list_show)))

看看上面三個實現方式,你覺得那種更加Pythonic?

eg:需要注意一點,map在python3中是一個可迭代對象,引入需要使用列表調用來使它生成所有的結果用於显示,python2不必如此。

當然map的闡述函數,不僅僅支持自己編寫的,同樣也支持python自帶的多種函數,比如:

list_show = [1, -2, 3, -4, 5, -6]
print(list(map(abs, list_show)))
>>> [1, 2, 3, 4, 5, 6]

filter函數

filter通過字面意思,大家就知道它的用處了,用於數據的過濾操作,它也是lambda的一個好基友,舉個栗子。
我們需要過濾0-9中,能被2整除的数字組成一個列表,我們該如何操作?只需要一行代碼:

print(list(filter(lambda x: x % 2 == 0, range(10))))
>>> [0, 2, 4, 6, 8]

沒錯,filter就是這麼的簡單實用….

reduce的妙用

reduce在python2中是一個簡單的函數,但在python3中它責備收錄與functools中。
它接收一個迭代器來處理並返回一個單個的結果。

list_show = [1, 2, 3, 4]
print(reduce(lambda x, y: x + y, list_show))
>>> 10
print(reduce(lambda x, y: x * y, list_show))
>>> 24

lambda的實用與它的好基友就介紹到這裏,希望對大家有所幫助。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

WPF 修改屏幕DPI,會觸發控件重新加載Unload/Load

修改屏幕DPI,會觸發控件的Unloaded/Loaded

現象/重現案例

這裏簡單介紹下,修改屏幕DPI,觸發Unloaded/Loaded的神奇案例

1. 我們新建一個窗口,添加一個UserControl1,然後在UserControl1中添加UserControl2

 1 <Window x:Class="WPFUnloadedTriggerTest.MainWindow"
 2         xmlns="http://schemas.microsoft.com/winfx/2006/xaml/presentation"
 3         xmlns:x="http://schemas.microsoft.com/winfx/2006/xaml"
 4         xmlns:d="http://schemas.microsoft.com/expression/blend/2008"
 5         xmlns:mc="http://schemas.openxmlformats.org/markup-compatibility/2006"
 6         xmlns:local="clr-namespace:WPFUnloadedTriggerTest"
 7         mc:Ignorable="d"
 8         Title="MainWindow" Height="450" Width="800">
 9     <local:UserControl1></local:UserControl1>
10 </Window>
11 ------------------------------我是分隔線-----------------------------------
12 <UserControl x:Class="WPFUnloadedTriggerTest.UserControl1"
13              xmlns="http://schemas.microsoft.com/winfx/2006/xaml/presentation"
14              xmlns:x="http://schemas.microsoft.com/winfx/2006/xaml"
15              xmlns:mc="http://schemas.openxmlformats.org/markup-compatibility/2006" 
16              xmlns:d="http://schemas.microsoft.com/expression/blend/2008" 
17              xmlns:local="clr-namespace:WPFUnloadedTriggerTest"
18              mc:Ignorable="d" 
19              d:DesignHeight="450" d:DesignWidth="800">
20     <local:UserControl2></local:UserControl2>
21 </UserControl>

View Code

2. 显示窗口后,修改DPI比例

3. 設置完后,會觸發Unloaded/Loaded重新加載

Unloaded的觸發順序是UserControl1–>UserControl2,Window並不會觸發Unloaded事件!

是不是詭異?我們繼續。。。

 4. Window我們添加一個ControlTemplate模塊

1     <Window.Template>
2         <ControlTemplate TargetType="Window">
3             <Border>
4                 <AdornerDecorator>
5                     <ContentPresenter />
6                 </AdornerDecorator>
7             </Border>
8         </ControlTemplate>
9     </Window.Template>

 再重複2、3步驟,Unloaded的觸發順序變了:

觸發UserControl2的Unloaded,Window、UserControl1並不會觸發Unloaded事件!

問題分析

第2步驟中修改DPI后,Unloaded事件不一定觸發。如何必現呢?

將窗口靠近到任務欄上方,再修改文本比例。

 我們查看調用堆棧,貌似是系統給窗口發送消息然後調用BroadcastUnloadedEvent事件,觸發Unload

 所以應該是修改DPI,窗口寬高超出了當前屏幕尺寸範圍,系統對UserControl的視覺樹進行重新加載布局。

至於窗口沒有觸發Unloaded、以及在窗口添加以上模塊後下一級子控件也沒有觸發Unloaded事件的原因,暫不了解

而對WPF-Unloaded/Loaded的已知情況如下:

  • FrameworkElement, 第一次加載显示時,會觸發Loaded。元素被釋放時,會觸發Unloaded。窗口Show/Close時,視覺樹變化都會觸發加載事件
  • MenuItem, 在FrameworkElement基礎上,每次和隱藏MenuItem時,會額外觸發Load/Unloaded
  • TabControl,當你選中一個tabItem時會觸發Loaded,當你取消選中一個tabItem時會觸發Unloaded,所以切換Tab時必定有一個Loaded一個Unloaded。
  • Expander,每次被Expanded擴展時會引發Loaded,但當隱藏時不會引發Unloaded。

 以上問題的解決方案?暫時沒有解決方案,只有規避措施,不要過於依賴於Unload/Loaded,而且使用了Unload/Loaded時也要添加註銷機制,防止重入

我在github提了個issue:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享