ASP.NET Core gRPC 使用 Consul 服務註冊發現

一. 前言

gRPC 在當前最常見的應用就是在微服務場景中,所以不可避免的會有服務註冊與發現問題,我們使用gRPC實現的服務可以使用 Consul 或者 etcd 作為服務註冊與發現中心,本文主要介紹Consul。

二. Consul 介紹

Consul是一種服務網絡解決方案,可跨任何運行平台以及公共或私有雲來連接和保護服務。它可以讓你發現服務並保護網絡流量。它可以在Kubernetes中使用,實現服務發現和服務網格功能(k8s默認etcd)。 提供安全服務通訊,保護和觀察服務之間的通信,而無需修改其代碼。 提供動態負載平衡, 使用Consul和HAProxy,Nginx或F5自動執行負載均衡器配置。 Consul 可以用於服務發現和服務網格。

翻譯自官網

三. Consul 安裝配置

安裝

Consul 下載地址:

根據自己的系統來選擇,我這裏選擇的是 Windows 版本的,直接解壓即可運行。

啟動

consul agent -dev -ui

本文不詳細介紹Consul使用,如需請自行查看相關資料

四. .NET Core Consul 客戶端的選擇

Consul 提供了 HTTP API 的方式來進行通訊,我們可以直接調用API或者是使用第三方封裝好的客戶端組件,通過Nuget搜索可以發現許多。

這裏面我沒有一一測試,但是目前使用量最多的 Consul 組件是不支持設置 GRPC 健康檢查的,而且 github 也停止了更新。

所以我 Fork 了這個倉庫,然後添加了 GRPC 的健康檢查支持,本文也將使用這個庫,歡迎大家使用:

因為原倉庫已經 Archived 了,所以我才 Fork 了自己改一下,改動很小,不影響原來的穩定性。

Nuget:

Github:

求個star

關於支持 GPRC 健康檢查的好處:

偷個懶,不翻譯了,摘自GRPC官方文檔

五. 註冊GRPC服務與健康檢查

基於前文()的Demo

1.為服務端項目安裝 NConsul.AspNetCore ( )

這裏面對 AspNetCore 做了適配,使用簡單。

2.在 Startup 的 ConfigureServices方法內進行配置

public void ConfigureServices(IServiceCollection services)
{
    services.AddGrpc();

    services.AddConsul("http://localhost:8500")
        .AddGRPCHealthCheck("localhost:5000")
        .RegisterService("grpctest","localhost",5000,new []{"xc/grpc/test"});
}

AddConsul 添加 Consul Server 地址。

AddGRPCHealthCheck 添加 GRPC 健康檢查,即健康檢查走的是 GRPC 協議,該值為 GRPC 服務的地址,不需要path,不需要提供 http/https

RegisterService 註冊服務

到這步,還不能啟動運行,如果運行健康檢查是會失敗的。

3.編寫 Health Check 服務 **

對於 GRPC 的健康檢查,官方有標準的定義,新建一個 proto 文件,命名為 HealthCheck.proto

syntax = "proto3";

package grpc.health.v1;

message HealthCheckRequest {
    string service = 1;
}

message HealthCheckResponse {
    enum ServingStatus {
        UNKNOWN = 0;
        SERVING = 1;
        NOT_SERVING = 2;
    }
    ServingStatus status = 1;
}

service Health {
    rpc Check(HealthCheckRequest) returns (HealthCheckResponse);

    rpc Watch(HealthCheckRequest) returns (stream HealthCheckResponse);
}

這裏面的內容不得更改,是官方標準,資料見後文

這裏編譯一下項目,以便自動生成代碼。

然後,添加一個服務的實現類 HealthCheckService

public class HealthCheckService:Health.HealthBase
{
    public override Task<HealthCheckResponse> Check(HealthCheckRequest request, ServerCallContext context)
    {
        //TODO:檢查邏輯
        return Task.FromResult(new HealthCheckResponse(){Status = HealthCheckResponse.Types.ServingStatus.Serving});
    }

    public override async Task Watch(HealthCheckRequest request, IServerStreamWriter<HealthCheckResponse> responseStream, ServerCallContext context)
    {
        //TODO:檢查邏輯
        await responseStream.WriteAsync(new HealthCheckResponse()
            {Status = HealthCheckResponse.Types.ServingStatus.Serving});
    }
}

示例代碼直接返回了檢查結果,實際使用中應該在這裏編寫檢查邏輯,然後根據情況返回相應的檢查結果。檢查結果有3種情況:

結果類型 說明
Unknown 未知狀態
Serving 正常
NotServing 異常,不能提供服務

最後別忘了註冊服務:

4.測試運行

啟動 GRPC 服務

然後訪問 http://localhost:8500/ui 訪問 Consul 控制台

可以看到服務成功註冊,並且健康檢查也是通過了的。通過控制台日誌,還可以看到健康檢查的請求:

六. 客戶端使用服務發現

客戶端項目安裝 Consul 組件,然後改造下代碼:

static async Task Main(string[] args)
{
    var serviceName = "grpctest";
    var consulClient = new ConsulClient(c => c.Address = new Uri("http://localhost:8500"));
    var services = await consulClient.Catalog.Service(serviceName);
    if (services.Response.Length == 0)
    {
        throw new Exception($"未發現服務 {serviceName}");
    }

    var service = services.Response[0];
    var address = $"http://{service.ServiceAddress}:{service.ServicePort}";

    Console.WriteLine($"獲取服務地址成功:{address}");

    //啟用通過http使用http2.0
    AppContext.SetSwitch(
        "System.Net.Http.SocketsHttpHandler.Http2UnencryptedSupport", true);
    var channel = GrpcChannel.ForAddress(address);
    var catClient = new LuCat.LuCatClient(channel);
    var catReply = await catClient.SuckingCatAsync(new Empty());
    Console.WriteLine("調用擼貓服務:"+ catReply.Message);
    Console.ReadKey();
}

通過服務名稱獲取服務地址,然後來進行訪問。

運行測試:

可以看到,成功的從Consul獲取了我們的服務地址,然後調用。

六. 參考資料

  • gRPC in Asp.Net Core :

  • GPRC Health Check Doc:

  • 本文 Demo:

  • 本系列文章目錄:

  • NConsul:

  • by Edison Zhou

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

MySQL權限管理

目錄

設置用戶與權限

一個MySQL系統可能有許多用戶。為了安全起見,root用戶通常只用管理目的。對於每個需要使用該系統的用戶,應該為他們創建一個賬號和密碼。這些用戶名和密碼不必與MySQL之外的用戶名稱和密碼(例如,Linux或NT用戶名和密碼)相同。同樣的原則也適合於root用戶。對於系統用戶和MySQL用戶最好使用不同的密碼,這一點對root用戶尤其應該這樣。
為用戶設置密碼不是必須的,但是強烈建議為所有創建的用戶設定密碼。要建立一個Web數據庫,最好為每個網站應用程序建立一個用戶。你可能會問,“為什麼要這麼做呢?”—-答案在於權限。

用戶管理

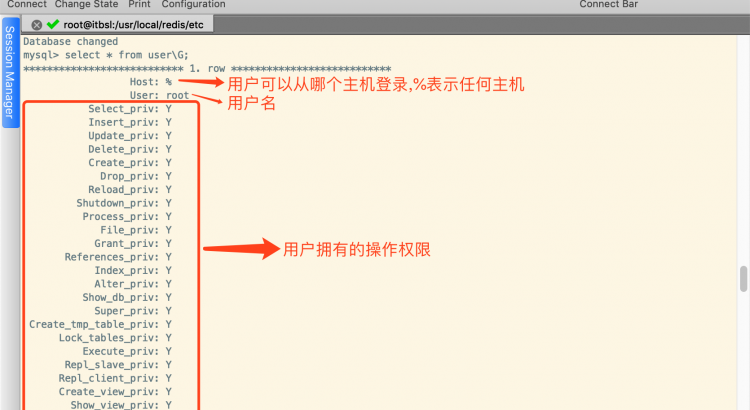
我們的MySQL的用戶,都被記錄在了mysql數據庫的user表中,如下圖:

在MySQL數據庫中,一個完整的用戶賬號應該包含用戶名和登錄主機,也就是說 用戶名@主機名才是一個完整的用戶賬號。

創建用戶基本語法:

CREATE USER 用戶名@主機名 IDENTIFIED BY '密碼';

刪除用戶基本語法:

DROP USER 用戶名@主機名;

修改用戶密碼:

- 修改自己的密碼
set password = password('新密碼');
- 修改別人的密碼(需要有該權限)
set password for 用戶名@主機名 = password('新密碼');

MySQL權限系統介紹

MySQL的最好特性之一是支持複雜的權限系統。權限是對特定對象執行特定操作的權力,它與特定用戶相關。其概念非常類似於文件的權限。擋在MySQL中創建一個用戶時,就賦予了該用戶一定的權限,這些權限指定了用戶在本系統中可以做什麼和不可以做什麼。

最少權限原則

最少權限原則可以用來提高任何計算機系統的安全性。它是一個基本的、但又是非常重要的而且容易為我們忽略的原則。該原則包含如下內容:

一個用戶(或一個進程)應該擁有能夠執行分配給他的任務的最低級別的權限。

該原則同樣適用於MySQL,就像它應用於其他地方一樣。例如,要在網站上運行查詢,用戶並不需要root用戶所擁有的所有權限。因此,我們應該創建另一個用戶,這個用戶只有訪問我們剛剛建立的數據庫的必要權限。

創建用戶:GRANT命令

GRANT和REVOKE命令分別用來授予和取消MySQL用戶的權限,這些權限分4個級別。它們分別是:

  • 全局
  • 數據庫
  • 表
  • 列

GRANT命令用來創建用戶並賦予他們權限。GRANT命令的常見形式是:

GRANT privileges [columns]
ON item
TO user_name [IDENTIFIED BY 'password']
[REQUIRE ssl_options]
[WITH [GRANT OPTION | limit_options]]

普通寫法可以簡略如下:

GRANT 權限列表 ON 數據庫.表 TO 用戶名@主機名 [IDENTIFIED BY '密碼'];

identified by可以省略,也可以寫出
(1)如果寫了,用戶存在,就是修改用戶的密碼
(2)如果寫了,該用戶不存在,就是創建用戶,同時指定密碼

方括號內的子句是可選的。在本語法中,出現了許多佔位符。第一個佔位符是 privileges,應該是由逗號分開的一組權限。MySQL已經有一組已定義的權限。它們在下一節詳細介紹。
佔位符 columns是可選的。可以用它對每一個列指定權限。也可以使用單列的名稱或者逗號分開的一組列的名稱。

佔位符 item是新權限的所應用於的數據庫或表。可以將項目指定為“.”,而將權限應用於所有數據庫。這叫做賦予全局權限。如果沒有使用在特定的數據庫,也可以通過只指定*完成賦予全局權限。更常見的是,以dbname.*的形式指定數據庫中所有的表,以dbname.tablename的形式指定單個表,或者通過指定tablename來指定特定的列。這些分別表示其他3個可以利用的權限:數據庫、表、列。如果在輸入命令的時候正在使用一個數據庫,tablename本身將被解釋成當前數據庫中的一個表。

user_name應該是用戶登錄MySQL所使用的用戶名。請注意,它不必與登錄系統時所使用的用戶名相同。MySQL中的user_name也可以包含一個主機名。可以用它來區分如itbsl(解釋成itbsl@localhost)和itbsl@somewhere.com。這是非常有用的一項能力,因為來自不同域的用戶經常可能使用同一個名字。這也提高了安全性能,因為可以指定用戶從什麼地方連接到本機,甚至可以指定它們在特定的地方可以訪問那些表和數據庫。

password應該是用戶登錄時使用的密碼。常見的密碼選擇規則在這裏都適用。我們後面將更詳細地講述安全問題,但是密碼應該不容易被猜出來。這意味着,密碼不應該是一個字段單詞或與用戶名相同。理想的密碼應該是大、小寫字母和非字母的組合。

REQUIRE子句允許指定用戶是否必須通過加密套接字連接,或者指定其它的SSL選項,關於SSL到MySQL連接的更多信息,請參閱MySQL手冊。

WITH GRANT OPTION選項,如果指定,表示允許指定的用戶向別人授予自己所擁有的權限。
我們也可以指定如下所示的WITH子句:
MAX_QUERIES_PER_HOUR n
或者
MAX_UPDATES_PER_HOUR n
或者
MAX_CONNECTIONS_PER_HOUR n
這些子句可以指定每個用戶每小時執行的查詢、更新和鏈接的數量。在共享的系統上限制單個用戶的負載時,這些子句是非常有用的。
權限存儲在名為mysql的數據庫中的5個系統中。這些表分別是mysql.user、mysql.db、mysql.host、mysql.tables_priv和mysql.columns_priv。作為GRANT命令的替代,可以直接修改這些表。

權限的類型和級別

MySQL中存在3個基本類型的權限:適用於賦予一般用戶的權限、適用於賦予管理員的權限和幾個特定的權限。任何用戶都可以被賦予這3類權限,但是根據最少權限原則,最好嚴格限定只將管理員類型的權限賦予管理員。

我們應該只賦予用戶訪問他們必須使用的數據庫和表的權限。而不應該將訪問mysql的權限賦予不是管理員的人。mysql數據庫是所有用戶名、密碼等信息存儲的地方。

常規用戶的權限直接與特定的SQL命令類型以及用戶是否被允許運行它們相關。下錶所示的是基本用戶權限。“應用於”列下面的對象給出了該類型權限可以授予的對象。

用戶的權限

權限 應用於 描述
SELECT 表、列 允許用戶從表中查詢行(記錄)
INSERT 表、列 允許用戶在表中插入新行
UPDATE 表、列 允許用戶修改現存表裡行中的值
DELETE 表 允許用戶刪除現存表的行
INDEX 表 允許用戶創建和拖動特定表索引
ALTER 表 允許用戶改變現存表的結構,例如,可添加列、重命名列或表、修改列的數據類型
CREATE 數據庫、表 允許用戶創建新數據庫或表。如果在GRANT中指定了一個特定的數據庫或表,它們只能夠創建該數據庫或表,即它們必須首先刪除(drop)它
DROP 數據庫、表 允許用戶拖動(刪除)數據庫或表

從系統的安全性方面考慮,適於常規用戶的權限大多數是相對無害的。ALTER權限通過重命名表可能會影響權限系統,但是大多數用戶需要它。安全性常常是可用性與保險性的折中。遇到ALTER的時候,應當做出自己的選擇,但是通常還是會將這個權限授予用戶。

下面的表給出了適用於管理員用戶使用的權限。
可以將這些權限授予非管理員用戶,這樣做的時候要非常小心。
FILE權限有些不同,它對普通用戶非常有用,因為它可以將數據從文件載入數據庫,從而可以節省許多時間,否則,每次將數據輸入數據庫都需要重新輸入,這很浪費時間。
然而,文件載入可以用來載入MySQL可識別的任何文件,包括屬於其他用戶的數據庫和潛在的密碼文件。授予該權限的時候需要小心,或者自己為用戶載入數據。

管理員權限

權限 描述
CREATE TEMPORARY TABLES 允許管理員在CREATE TABLE語句中使用TEMPORARY關鍵字
FILE 允許將數據從文件讀入表,或從表讀入文件
LOCK TABLES 允許使用LOCK TABLES語句
PROCESS 允許管理員查看屬於所有用戶的服務器進程
RELOAD 允許管理員重新載入授權表、清空授權、主機、日誌和表
REPLICATION CLIENT 允許管理員重新載入授權表、和從機(Slave)上使用SHOW STATUS
REPLICATION SLAVE 允許複製從服務器連接到主服務器
SHOW DATABASES 允許使用SHOW DATABASES語句查看所有數據庫列表。沒有這個權限,用戶只能看到他們能夠看到的數據庫
SHUTDOWN 允許管理員關閉MySQL服務器
SUPER 允許管理員關閉屬於任何用戶的的線程

特別的權限

權限 描述
ALL 授予上面兩個表列表的所有權限。也可以將ALL寫成ALL PRIVILEGES
USAGE 不授予權限。這創建一個用戶並允許他登錄,但是不允許進行任何操作。通常會在以後授予該用戶更多的權限

REVOKE命令

與GRANT相反的命令是REVOKE。它用來從一個用戶收回權限。在語法上與GRANT非常相似:

REVOKE privileges [(columns)]
ON item
FROM user_name

中文翻譯:

REVOKE 權限列表 ON 數據庫.對象 FROM 用戶名@主機名;

如果已經給出了WITH GRANT OPTION子句,可以按如下方式撤銷它(以及所有其他權限):

REVOKE ALL PRIVILEGES, GRANT
FROM user_name

權限立即生效

當我們修改用戶權限之後,如果想不重啟立即生效,需要執行以下flush privileges,這樣能快速刷新權限

FULSH PRIVILEGES;

使用GRANT和REVOKE的例子

要創建一個管理員,可以輸入如下所示的命令:

grant all on * to fred identified by 'mnb123' with grant option;

以上命令授予了用戶名為fred、密碼為mnb123的用戶使用所有數據庫的所有權限,並允許他向其他人授予這些權限。

如果不希望用戶在系統中存在,可以按如下方式撤銷:

revoke all privileges, grant from red;

現在,我們可以按如下方式創建一個沒有任何權限的常規用戶:

grant usage on books.* to sally identified by 'magic123';

在與sally交談后,我們對她需要進行的操作有了一定的了解,因此按如下方式可以授予她適當的權限:

grant select, insert, update, delete, index, alter, create, drop on books.* to sally;

請注意,要完成這些,並不需要指定sally密碼。

如果我們認為sally權限過高,可能會決定按如下方式減少一些權限:

revoke alter, create, drop on books.* from sally;

後來,當她不再需要使用數據庫時,可以按如下方式撤銷所有的權限:

revoke all on books.* from sally;

參考資料:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※平板收購,iphone手機收購,二手筆電回收,二手iphone收購-全台皆可收購

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益
Spring Boot (一) 校驗表單重複提交

一、前言

在某些情況下,由於網速慢,用戶操作有誤(連續點擊兩下提交按鈕),頁面卡頓等原因,可能會出現表單數據重複提交造成數據庫保存多條重複數據。

存在如上問題可以交給前端解決,判斷多長時間內不能再次點擊保存按鈕,當然,如果存在聰明的用戶能夠繞過前端驗證,後端更應該去進行攔截處理,下面小編將基於SpringBoot 2.1.8.RELEASE環境通過AOP切面+ 自定義校驗註解+ Redis緩存來解決這一問題。

二、Spring Boot 校驗表單重複提交操作

1、pom.xml中引入所需依賴

<!-- ==================  校驗表單重複提交所需依賴 ===================== -->
<!-- AOP依賴 -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-aop</artifactId>
</dependency>
<!-- Redis -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-redis</artifactId>
</dependency>

2、application.yml中引入Redis配置

spring:
  redis:
    # Redis數據庫索引(默認為0)
    database: 0
    # Redis服務器地址
    host: 127.0.0.1
    # Redis服務器連接端口
    port: 6379
    timeout: 6000
    # Redis服務器連接密碼(默認為空)
    #      password:
    jedis:
      pool:
        max-active: 1000  # 連接池最大連接數(使用負值表示沒有限制)
        max-wait: -1      # 連接池最大阻塞等待時間(使用負值表示沒有限制)
        max-idle: 10      # 連接池中的最大空閑連接
        min-idle: 5       # 連接池中的最小空閑連接

3、自定義註解 @NoRepeatSubmit

// 作用到方法上
@Target(ElementType.METHOD)
// 運行時有效
@Retention(RetentionPolicy.RUNTIME)
public @interface NoRepeatSubmit {
    /**
     * 默認時間3秒
     */
    int time() default 3 * 1000;
}

4、AOP 攔截處理

注:這裏redis存儲的key值可由個人具體業務靈活發揮,這裏只是示例
ex:單用戶登錄情況下可以組合token + url請求路徑,多個用戶可以同時登錄的話,可以再加上ip地址

@Slf4j
@Aspect
@Component
public class NoRepeatSubmitAop {

    @Autowired
    RedisUtil redisUtil;

    /**
     * <p> 【環繞通知】 用於攔截指定方法,判斷用戶表單保存操作是否屬於重複提交 <p>
     *
     *      定義切入點表達式: execution(public * (…))
     *      表達式解釋: execution:主體    public:可省略   *:標識方法的任意返回值  任意包+類+方法(…) 任意參數
     *
     *      com.zhengqing.demo.modules.*.api : 標識AOP所切服務的包名,即需要進行橫切的業務類
     *      .*Controller : 標識類名,*即所有類
     *      .*(..) : 標識任何方法名,括號表示參數,兩個點表示任何參數類型
     *
     * @param pjp:切入點對象
     * @param noRepeatSubmit:自定義的註解對象
     * @return: java.lang.Object
     */
    @Around("execution(* com.zhengqing.demo.modules.*.api.*Controller.*(..)) && @annotation(noRepeatSubmit)")
    public Object doAround(ProceedingJoinPoint pjp, NoRepeatSubmit noRepeatSubmit) {
        try {
            HttpServletRequest request = ((ServletRequestAttributes) Objects.requireNonNull(RequestContextHolder.getRequestAttributes())).getRequest();

            // 拿到ip地址、請求路徑、token
            String ip = IpUtils.getIpAdrress(request);
            String url = request.getRequestURL().toString();
            String token = request.getHeader(Constants.REQUEST_HEADERS_TOKEN);

            // 現在時間
            long now = System.currentTimeMillis();

            // 自定義key值方式
            String key = "REQUEST_FORM_" + ip;
            if (redisUtil.hasKey(key)) {
                // 上次表單提交時間
                long lastTime = Long.parseLong(redisUtil.get(key));
                // 如果現在距離上次提交時間小於設置的默認時間 則 判斷為重複提交  否則 正常提交 -> 進入業務處理
                if ((now - lastTime) > noRepeatSubmit.time()) {
                    // 非重複提交操作 - 重新記錄操作時間
                    redisUtil.set(key, String.valueOf(now));
                    // 進入處理業務
                    ApiResult result = (ApiResult) pjp.proceed();
                    return result;
                } else {
                    return ApiResult.fail("請勿重複提交!");
                }
            } else {
                // 這裡是第一次操作
                redisUtil.set(key, String.valueOf(now));
                ApiResult result = (ApiResult) pjp.proceed();
                return result;
            }
        } catch (Throwable e) {
            log.error("校驗表單重複提交時異常: {}", e.getMessage());
            return ApiResult.fail("校驗表單重複提交時異常!");
        }

    }

}

5、其中用到的Redis工具類

由於太多,這裏就不直接貼出來了,可參考文末給出的案例demo源碼

三、測試

在需要校驗的方法上加上自定義的校驗註解@NoRepeatSubmit即可

@RestController
public class IndexController extends BaseController {

    @NoRepeatSubmit
    @GetMapping(value = "/index", produces = "application/json;charset=utf-8")
    public ApiResult index() {
        return ApiResult.ok("Hello World ~ ");
    }

}

這裏重複訪問此indexapi請求以模擬提交表單測試

第一次訪問

多次刷新此請求,則提示請勿重複提交!

四、總結

實現思路
  1. 首先利用AOP切面在進入方法前攔截進行表單重複提交校驗邏輯處理
  2. 通過Redis的key-value鍵值對存儲需要的邏輯判斷數據【ex:key存儲用戶提交表單的api請求路徑,value存儲提交時間】
  3. 邏輯處理:
    第一次提交時存入相應數據到redis中
    當再次提交保存時從redis緩存中取出上次提交的時間與當前操作時間做判斷,
    如果當前操作時間距離上次操作時間在我們設置的’判斷為重複提交的時間(3秒內)’則為重複提交直接返回重複提交提示語句或其它處理,
    否則為正常提交,進入業務方法處理…
補充

如果api遵從的是嚴格的Restful風格即@PostMapping用於表單提交操作,則可不用自定義註解方式去判斷需要校驗重複提交的路徑,直接在aop切面攔截該請求路徑後,通過反射拿到該方法上的註解是否存在@PostMapping如果存在則是提交表單的api,即進行校驗處理,如果不存在即是其它的@GetMapping、@PutMapping、@DeleteMapping操作…

本文案例demo源碼

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

【控制系統数字仿真與CAD】實驗三:離散相似法数字仿真

一、實驗目的
  1. 了解離散相似法的基本原理
  2. 掌握離散相似法仿真的基本過程
  3. 應用離散相似法仿真非線性系統
  4. MATLAB實現離散相似法的非線性系統仿真
  5. 掌握SIMULINK仿真方法,應用於非線性系統的仿真,並對實驗結果進行分析比較

二、實驗原理

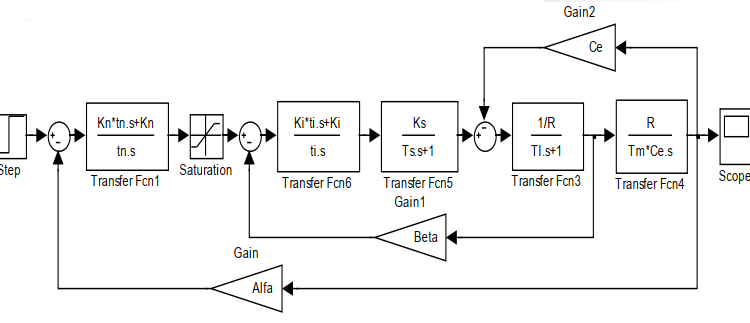
  在ASR的輸出增加限幅裝置(飽和非線性,飽和界為c=8 )。 Ce=0.031,其它參數不變。輸入為單位階躍,用離散相似法求系統各環節的輸出。

  要求:採用零階保持器和一階保持器離散化系統,分別完成本實驗。

  1、各環節的參數:

  由5個典型環節組成:

  A=[0 0 1 1 0];

  B=[tn ti Ts Tl Tm*Ce];
  C=[Kn Ki Ks 1/R R];
  D=[Kn*tn Ki*ti 0 0 0];

  還有一飽和非線性環節:c=8;

  2、各環節的離散化係數矩陣

 3、各環節的輸入作用


    (1)、u(n)可通過聯接矩陣直接求得: 


      u(n)=[u1(n), u2(n),…,un(n)]為各環節的輸入量, n為環節數。 Y(n)=[Y1(n), Y2(n),…,Yn(n)]為各環節的輸出量, r為外中參考輸入量。

    (2)、U(n)由近似表達式求得:
      

    (3)、u(n+1)用折線法近似求得:


  4、狀態和輸出計算

    (1)、一階保持器
      X=FI’.*X+FIM’.*Uk+FIJ’.*Udot;
      Y=FIC’.*X+FID’.*Uf;
    (2)、零階保持器
      X=FI’.*X+FIM’.*Uk;
      Y=FIC’.*X+FID’.*Uf;

  5、飽和非線性環節

  看作環節1(ASR)的一部分。建立satur.m文件:

function [uo]=satur(ui,c)
    if (abs(ui)<=c)
        uo=ui;
    elseif ( ui > c )
        uo = c;
    else
        uo=-c;
    end
end

 三、實驗過程

  1、新建腳本文件,命名為satur.m

function [uo]=satur(ui,c)
    if (abs(ui)<=c)
        uo=ui;
    elseif ( ui > c )
        uo = c;
    else
        uo=-c;
    end
end

  2、新建腳本文件,命名為test3.m

  完整代碼:

clc;
clear;
% ******  各環節參數  ****** %
Kn=26.7;
tn=0.03;
Ki=0.269;
ti=0.067;
Ks=76;
Ts=0.00167;
R=6.58;
T1=0.018;
Tm=0.25;
Ce=0.031;
Alpha=0.00337;
Beta=0.4;
A=[0 0 1 1 0];
B=[tn ti Ts T1 Tm*Ce];
C=[Kn Ki Ks 1/R R];
D=[Kn*tn Ki*ti 0 0 0];
c=8;
r=1;
W=[0 0 0 0 -Alpha;
    1 0 0 -Beta 0;
    0 1 0 0 0;
    0 0 1 0 -Ce;
    0 0 0 1 0];
W0=[1 0 0 0 0]';
h=0.001;
t_end=0.5;
t=0:h:t_end;
n=length(t);
% ******  各環節離散化係數  ****** %
block_num=5;
for k=1:block_num
    if(A(k)==0)
        FI(k)=1;
        FIM(k)=h*C(k)/B(k);
        FIJ(k)=h*h*C(k)/B(k)/2;
        FIC(k)=1;
        FID(k)=0;
        if(D(k)~=0)
            FID(k)=D(k)/B(k);
        end
    else
        FI(k)=exp(-h*A(k)/B(k));
        FIM(k)=(1-FI(k))*C(k)/A(k);
        FIJ(k)=h*C(k)/A(k)-FIM(k)*B(k)/A(k);
        FIC(k)=1;
        FID(k)=0;
        if(D(k)~=0)
            FIC(k)=C(k)/D(k)-A(k)/B(k);
            FID(k)=D(k)/B(k);
        end
    end
end

Y0=[0 0 0 0 0]';
Y=Y0;
X=zeros(block_num,1);
result1=Y;
Uk=zeros(block_num,1);
Ub=Uk;

for m=1:(n-1)
    Ub=Uk;
    Uk=W*Y+W0*r;
    Uf=2*Uk-Ub;
    Udot=(Uk-Ub)/h;
    
    %******  零階保持器  ******%
    X=FI'.*X+FIM'.*Uk;
    Y=FIC'.*X+FID'.*Uf;
    
    Y(1)=satur(Y(1),c);
    result1=[result1,Y];
end

Y0=[0 0 0 0 0]';
Y=Y0;
X=zeros(block_num,1);
result2=Y;
Uk=zeros(block_num,1);
Ub=Uk;
for m=1:(n-1)
    Ub=Uk;
    Uk=W*Y+W0*r;
    Uf=2*Uk-Ub;
    Udot=(Uk-Ub)/h;
    
    %******  一階保持器  ******%
    X=FI'.*X+FIM'.*Uk + FIJ'.*Udot;
    Y=FIC'.*X + FID'.*Uf;
    
    Y(1)=satur(Y(1),c);
    result2=[result2,Y];
end

plot(t,result1(5,:),’-.’,t,result2(5,:),’–‘,t,ScopeData.signals.values,’k’);
legend(‘零階保持器’,’一階保持器’,’Simulink’);

  3、在Simulink中繪製仿真圖


 注意:Simulink中的變量名和工作區變量關聯方法請點擊:https://www.cnblogs.com/KaifengGuan/p/11942615.html

四、實驗結果


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

Spring中常見的設計模式——工廠模式

一、簡單工廠模式

  簡單工廠模式(Simple Factory Pattern)由一個工廠對象決定創建哪一種產品類的實例,簡單工廠模式適用於工廠類負責創建對象較少的情況,且客戶端只需要傳入工廠類的參數,對於如何創建對像不關心。

public  interface IBlog {
     // 寫隨筆
    public  void write();
}
public  class JavaBlog implements IBlog {
    @Override
    public  void write() {
        System.out.println( "寫java隨筆" );
    }
}
public  class WriteBlog {
     public  static  void main(String[] args) {
        IBlog blog = new JavaBlog();
        blog.write();
    }
}

  上述代碼中,父類 IBlog 指向子類JavaBlog 的引用,應用層需要依賴JavaBlog,如果增加PythonBlog等等更多的課程,客戶端就會越來越臃腫。因此要把依賴減弱,把創建細節隱藏。現在我們用簡單工廠優化:

public class BlogFactory {
    public IBlog create(Class<? extends IBlog> clazz) {
        if (null != clazz) {
            try {
                return clazz.newInstance();
            } catch (Exception e) {
                e.printStackTrace();
            }
        }
        return null;
    }
}

客戶端改變:

  public static void main(String[] args) {
        BlogFactory blogFactory = new BlogFactory();
        IBlog blog = blogFactory.create(JavaBlog. class );
        blog.write();
    }

  簡單工廠模式在JDK中很常見,如Calender類(感興趣去看源碼),還有logback,LoggerFactory中有很多重載的方法getLogger()。但是簡單工廠也有缺點:工廠類的職責相對過重,不易於擴展過於複雜的產品結構。

二、工廠方法模式

   工廠方法模式(Factory Method Pattern)是指定義一個創建對象的接口,但讓實現這個接口的類來決定實例化哪個類,工廠方法模式讓類的實例化推遲到子類中進行。在工廠方法模式中,用戶只需要關心所需產品對應工廠,無須關心創建的細節,而且加入新產品時符合開閉原則。

  工廠方法模式主要解決產品擴展問題。在簡單工廠模式中,隨著產品的增多,如果不同語言書寫隨筆的邏輯各不相同,工廠職責越來越多,那工廠裏面就會亂搞一氣,狗屁不通。根據單一職責原則,我們將只能進行拆分,不同工廠做不同事,Java隨筆由Java工廠創建,Python隨筆由Python工廠創建,對工廠本身進行抽象。

先創建工廠類:

public  interface IBlogFactory {
    IBlog create();
}

再創建對應工廠:

public  class JavaBlogFactory implements IBlogFactory {
    @Override
    public IBlog create() {
        return new JavaBlog();
    }
}

public class PythonBlogFactory implements IBlogFactory {
    @Override
    public IBlog create() {
        return new PythonBlog();
    }
}

客戶端:

public class CreateBlog {
    public static void main(String[] args) {
        IBlogFactory factory = new PythonBlogFactory();
        IBlog blog = factory.create();
        blog.write();

        factory = new JavaBlogFactory();
        blog = factory.create();
        blog.write();
    }
}

總結來說就是:不同工廠抽像出一個工廠頭子,不同的工廠創建不同的實例。

工廠方法模式適用於以下場景:

1.創建對象需要大量重複代碼。

2.客戶端(應用層)不依賴於產品類實例如何被創建、如何被實現等細節。

3.一個類通過其子類來指定創建哪個對象。

缺點:

1.類的個數容易過多,增加複雜度。

2.增加了系統的抽象性和理解難度。

三、抽象工廠

  抽象工廠(Abstract Factory Pattern)提供一個黃健一系列相關或相互依賴對象的接口,無需指定具體類。客戶端(應用層)不依賴於產品類實例如何被創建、如何被實現等細節,強調的是一系列相關得產品對象(屬於同一產品族)一起使用創建對象需要大量重複代碼。需要提供一個產品類的庫,所有產品以同樣接口出現,從而是客戶端不依賴於具體實現。

產品族:同一家的不同產品,比如小米,華為,蘋果;

產品等級:不同種類的產品,比如手機,電視,電腦。

工廠要做的就是生產我們牌子的所有產品。以博客為例,java分類的博客有隨筆、文章、日記等。

首先創建文章和日記的抽象接口:

public  interface IDocument {
     void write();
}

public  interface INote {
     void make();
}

再創建抽象工廠:

public  interface BlogFactory {
    INote createNote();

    IDocument createDocument();
}

實現Java文章和日記:

public  class JavaDocument implements IDocument {
    @Override
    public  void write() {
        System.out.println( "寫Java文章" );
    }
}

public  class JavaNote implements INote {
    @Override
    public  void make() {
        System.out.println( "寫Java筆記" );
    }
}

實現Java產品族具體工廠:

public  class JavaBlogFactory implements BlogFactory {
    @Override
    public INote createNote() {
         return  new JavaNote();
    }

    @Override
    public IDocument createDocument() {
         return  new JavaDocument();
    }
}

實現Python文章和日記、實現Python具體工廠參考Java的。

客戶端調用:

public  class BlogTest {
     public  static  void main(String[] args) {
        JavaBlogFactory factory = new JavaBlogFactory();
        factory.createDocument().write();
        factory.createNote().make();
    }
}

  上述代碼描述了兩個產品族的工廠,如果想要擴展產品等級(就是再加點評啥的),要調整抽象工廠、具體工廠。由此可見抽象工廠模式的缺點:

1.規定所有可能被創建的產品集合,產品族(Java系列)中擴展新產品很困難,需要修改抽象工廠及實現;

2.增加系統抽象性和理解難度;

  我們可以利用工廠模式創建好數據源連接池並放到容器中,業務需要時再取出。就避免了用一次創建一次的尷尬。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

微服務中的Kafka與Micronaut

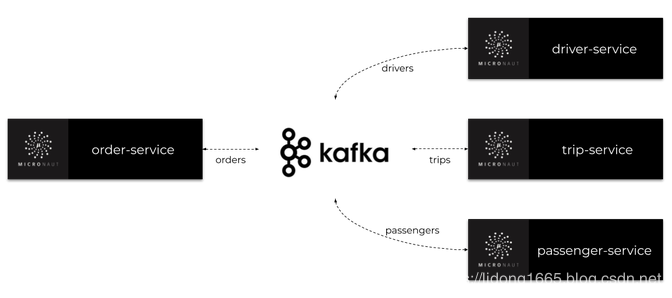
今天,我們將通過Apache Kafka主題構建一些彼此異步通信的微服務。我們使用Micronaut框架,它為與Kafka集成提供專門的庫。讓我們簡要介紹一下示例係統的體繫結構。我們有四個微型服務:訂單服務,行程服務,司機服務和乘客服務。這些應用程序的實現非常簡單。它們都有內存存儲,並連接到同一個Kafka實例。

我們系統的主要目標是為客戶安排行程。訂單服務應用程序還充當網關。它接收來自客戶的請求,保存歷史記錄並將事件發送到orders主題。所有其他微服務都在監聽orders這個主題,並處理order-service發送的訂單。每個微服務都有自己的專用主題,其中發送包含更改信息的事件。此類事件由其他一些微服務接收。架構如下圖所示。

在閱讀本文之前,有必要熟悉一下Micronaut框架。您可以閱讀之前的一篇文章,該文章描述了通過REST API構建微服務通信的過程:。

1 運行Kafka

要在本地機器上運行Apache Kafka,我們可以使用它的Docker映像。最新的鏡像是由共享的。在啟動Kafka容器之前,我們必須啟動kafka所用使用的ZooKeeper服務器。如果在Windows上運行Docker,其虛擬機的默認地址是192.168.99.100。它還必須設置為Kafka容器的環境。

Zookeeper和Kafka容器都將在同一個網絡中啟動。在docker中運行Zookeeper以zookeeper的名稱提供服務,並在暴露2181端口。Kafka容器需要在環境變量使用KAFKA_ZOOKEEPER_CONNECT的地址。

$ docker network create kafka
$ docker run -d --name zookeeper --network kafka -p 2181:2181 wurstmeister/zookeeper
$ docker run -d --name kafka -p 9092:9092 --network kafka --env KAFKA_ADVERTISED_HOST_NAME=192.168.99.100 --env KAFKA_ZOOKEEPER_CONNECT=zookeeper:2181 wurstmeister/kafka

2 添加micronaut-kafka依賴

使用Kafka構建的microaut應用程序可以在HTTP服務器存在的情況下啟動,也可以在不存在HTTP服務器的情況下啟動。要啟用Micronaut Kafka,需要添加micronaut-kafka庫到依賴項。如果您想暴露HTTP API,您還應該添加micronaut-http-server-netty:

<dependency>
    <groupId>io.micronaut.configuration</groupId>
    <artifactId>micronaut-kafka</artifactId>
</dependency>
<dependency>
    <groupId>io.micronaut</groupId>
    <artifactId>micronaut-http-server-netty</artifactId>
</dependency>

3 構建訂單微服務

訂單微服務是唯一一個啟動嵌入式HTTP服務器並暴露REST API的應用程序。這就是為什麼我們可以為Kafka提供內置Micronaut健康檢查。要做到這一點,我們首先應該添加micronaut-management依賴:

<dependency>
    <groupId>io.micronaut</groupId>
    <artifactId>micronaut-management</artifactId>
</dependency>

為了方便起見,我們將通過在application.yml中定義以下配置來啟用所有管理端點並禁用它們的HTTP身份驗證。

endpoints:
  all:
    enabled: true
    sensitive: false

現在,可以在地址欄下使用health check。我們的示例應用程序還將暴露添加新訂單和列出所有以前創建的訂單的簡單REST API。下面是暴露這些端點的Micronaut控制器實現:

@Controller("orders")
public class OrderController {

    @Inject
    OrderInMemoryRepository repository;
    @Inject
    OrderClient client;

    @Post
    public Order add(@Body Order order) {
        order = repository.add(order);
        client.send(order);
        return order;
    }

    @Get
    public Set<Order> findAll() {
        return repository.findAll();
    }

}

每個微服務都使用內存存儲庫實現。以下是訂單微服務(Order-Service)中的存儲庫實現:

@Singleton
public class OrderInMemoryRepository {

    private Set<Order> orders = new HashSet<>();

    public Order add(Order order) {
        order.setId((long) (orders.size() + 1));
        orders.add(order);
        return order;
    }

    public void update(Order order) {
        orders.remove(order);
        orders.add(order);
    }

    public Optional<Order> findByTripIdAndType(Long tripId, OrderType type) {
        return orders.stream().filter(order -> order.getTripId().equals(tripId) && order.getType() == type).findAny();
    }

    public Optional<Order> findNewestByUserIdAndType(Long userId, OrderType type) {
        return orders.stream().filter(order -> order.getUserId().equals(userId) && order.getType() == type)
                .max(Comparator.comparing(Order::getId));
    }

    public Set<Order> findAll() {
        return orders;
    }

}

內存存儲庫存儲Order對象實例。Order對象還被發送到名為orders的Kafka主題。下面是Order類的實現:

public class Order {

    private Long id;
    private LocalDateTime createdAt;
    private OrderType type;
    private Long userId;
    private Long tripId;
    private float currentLocationX;
    private float currentLocationY;
    private OrderStatus status;
    
    // ... GETTERS AND SETTERS
}

4 使用Kafka異步通信

現在,讓我們想一個可以通過示例係統實現的用例—— 添加新的行程。

我們創建了OrderType.NEW_TRIP類型的新訂單。在此之後,(1) 訂單服務創建一個訂單並將其發送到orders主題。訂單由三個微服務接收: 司機服務、乘客服務和行程服務。
(2)所有這些應用程序都處理這個新訂單。乘客服務應用程序檢查乘客帳戶上是否有足夠的資金。如果沒有,它就取消了行程,否則它什麼也做不了。司機服務正在尋找最近可用的司機,(3) 行程服務創建和存儲新的行程。司機服務和行程服務都將事件發送到它們的主題( drivers, trips),其中包含相關更改的信息。

每一個事件可以被其他microservices訪問,例如,(4) 行程服務偵聽來自司機服務的事件,以便為行程分配一個新的司機

下圖說明了在添加新的行程時,我們的微服務之間的通信過程。

現在,讓我們繼續討論實現細節。

4.1 發送訂單

首先,我們需要創建Kafka客戶端,負責向主題發送消息。我們創建的一個接口,命名為OrderClient,為它添加@KafkaClient並聲明用於發送消息的一個或多個方法。每個方法都應該通過@Topic註解設置目標主題名稱。對於方法參數,我們可以使用三個註解@KafkaKey、@Body或@Header。@KafkaKey用於分區,這是我們的示例應用程序所需要的。在下面可用的客戶端實現中,我們只使用@Body註解。

@KafkaClient
public interface OrderClient {

    @Topic("orders")
    void send(@Body Order order);

}

4.2 接收訂單

一旦客戶端發送了一個訂單,它就會被監聽orders主題的所有其他微服務接收。下面是司機服務中的監聽器實現。監聽器類OrderListener應該添加@KafkaListener註解。我們可以聲明groupId作為一個註解參數,以防止單個應用程序的多個實例接收相同的消息。然後,我們聲明用於處理傳入消息的方法。與客戶端方法相同,應該通過@Topic註解設置目標主題名稱,因為我們正在監聽Order對象,所以應該使用@Body註解——與對應的客戶端方法相同。

@KafkaListener(groupId = "driver")
public class OrderListener {

    private static final Logger LOGGER = LoggerFactory.getLogger(OrderListener.class);

    private DriverService service;

    public OrderListener(DriverService service) {
        this.service = service;
    }

    @Topic("orders")
    public void receive(@Body Order order) {
        LOGGER.info("Received: {}", order);
        switch (order.getType()) {
            case NEW_TRIP -> service.processNewTripOrder(order);
        }
    }

}

4.3 發送到其他主題

現在,讓我們看一下司機服務中的processNewTripOrder方法。DriverService注入兩個不同的Kafka Client
bean: OrderClient和DriverClient。當處理新訂單時,它將試圖尋找與發送訂單的乘客最近的司機。找到他之後,將該司機的狀態更改為UNAVAILABLE,並將帶有Driver對象的事件發送到drivers主題。

@Singleton
public class DriverService {

    private static final Logger LOGGER = LoggerFactory.getLogger(DriverService.class);

    private DriverClient client;
    private OrderClient orderClient;
    private DriverInMemoryRepository repository;

    public DriverService(DriverClient client, OrderClient orderClient, DriverInMemoryRepository repository) {
        this.client = client;
        this.orderClient = orderClient;
        this.repository = repository;
    }

    public void processNewTripOrder(Order order) {
        LOGGER.info("Processing: {}", order);
        Optional<Driver> driver = repository.findNearestDriver(order.getCurrentLocationX(), order.getCurrentLocationY());
        driver.ifPresent(driverLocal -> {
            driverLocal.setStatus(DriverStatus.UNAVAILABLE);
            repository.updateDriver(driverLocal);
            client.send(driverLocal, String.valueOf(order.getId()));
            LOGGER.info("Message sent: {}", driverLocal);
        });
    }
    
    // ...
}

這是Kafka Client在司機服務中的實現,用於向driver主題發送消息。因為我們需要將Driver與Order關聯起來,所以我們使用@Header註解的orderId參數。沒有必要把它包括到Driver類中,將其分配給監聽器端的正確行程。

@KafkaClient
public interface DriverClient {

    @Topic("drivers")
    void send(@Body Driver driver, @Header("Order-Id") String orderId);

}

4.4 服務間通信

由DriverListener收到@KafkaListener在行程服務中聲明。它監聽傳入到trip主題。接收方法的參數和客戶端發送方法的類似,如下所示:

@KafkaListener(groupId = "trip")
public class DriverListener {

    private static final Logger LOGGER = LoggerFactory.getLogger(OrderListener.class);

    private TripService service;

    public DriverListener(TripService service) {
        this.service = service;
    }

    @Topic("drivers")
    public void receive(@Body Driver driver, @Header("Order-Id") String orderId) {
        LOGGER.info("Received: driver->{}, header->{}", driver, orderId);
        service.processNewDriver(driver);
    }

}

最後一步,將orderId查詢到的行程Trip與driverId關聯,這樣整個流程就結束。

@Singleton
public class TripService {

    private static final Logger LOGGER = LoggerFactory.getLogger(TripService.class);

    private TripInMemoryRepository repository;
    private TripClient client;

    public TripService(TripInMemoryRepository repository, TripClient client) {
        this.repository = repository;
        this.client = client;
    }


    public void processNewDriver(Driver driver, String orderId) {
        LOGGER.info("Processing: {}", driver);
        Optional<Trip> trip = repository.findByOrderId(Long.valueOf(orderId));
        trip.ifPresent(tripLocal -> {
            tripLocal.setDriverId(driver.getId());
            repository.update(tripLocal);
        });
    }
    
    // ... OTHER METHODS

}

5 跟蹤

我們可以使用Micronaut Kafka輕鬆地啟用分佈式跟蹤。首先,我們需要啟用和配置Micronaut跟蹤。要做到這一點,首先應該添加一些依賴項:

<dependency>
    <groupId>io.micronaut</groupId>
    <artifactId>micronaut-tracing</artifactId>
</dependency>
<dependency>
    <groupId>io.zipkin.brave</groupId>
    <artifactId>brave-instrumentation-http</artifactId>
    <scope>runtime</scope>
</dependency>
<dependency>
    <groupId>io.zipkin.reporter2</groupId>
    <artifactId>zipkin-reporter</artifactId>
    <scope>runtime</scope>
</dependency>
<dependency>
    <groupId>io.opentracing.brave</groupId>
    <artifactId>brave-opentracing</artifactId>
</dependency>
<dependency>
    <groupId>io.opentracing.contrib</groupId>
    <artifactId>opentracing-kafka-client</artifactId>
    <version>0.0.16</version>
    <scope>runtime</scope>
</dependency>

我們還需要在application.yml配置文件中,配置Zipkin的追蹤的地址等

tracing:
  zipkin:
    enabled: true
    http:
      url: http://192.168.99.100:9411
    sampler:
      probability: 1

在啟動應用程序之前,我們必須運行Zipkin容器:

$ docker run -d --name zipkin -p 9411:9411 openzipkin/zipkin

6 總結

在本文中,您將了解通過Apache Kafka使用異步通信構建微服務架構的過程。我已經向大家展示了Microaut Kafka庫最重要的特性,它允許您輕鬆地聲明Kafka主題的生產者和消費者,為您的微服務啟用健康檢查和分佈式跟蹤。我已經為我們的系統描述了一個簡單的場景的實現,包括根據客戶的請求添加一個新的行程。本示例係統的整體實現,請查看GitHub上的

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

18個awk的經典實戰案例

介紹

這些案例是我收集起來的,大多都是我自己遇到過的,有些比較經典,有些比較具有代表性。

這些awk案例我也錄了相關視頻的講解,歡迎大家去瞅瞅。

插入幾個新字段

在”abc d”的b後面插入3個字段e f g。

echo a b c d|awk '{$3="e f g "$3}1'

格式化空白

移除每行的前綴、後綴空白,並將各部分左對齊。

      aaaa        bbb     ccc                 
   bbb     aaa ccc
ddd       fff             eee gg hh ii jj
awk 'BEGIN{OFS="\t"}{$1=$1;print}' a.txt

執行結果:

aaaa    bbb     ccc
bbb     aaa     ccc
ddd     fff     eee     gg      hh      ii      jj

篩選IPv4地址

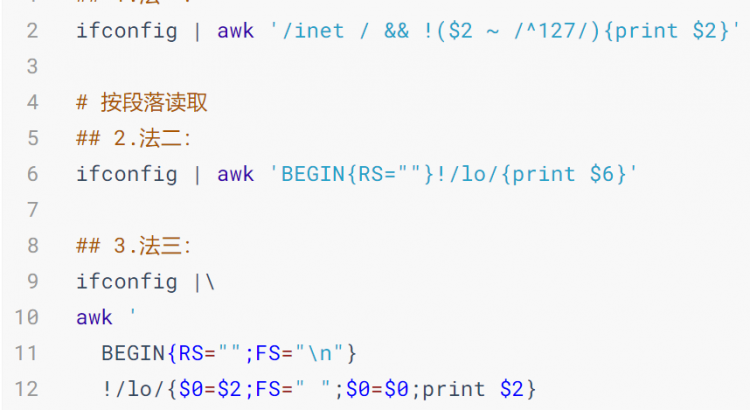
從ifconfig命令的結果中篩選出除了lo網卡外的所有IPv4地址。

讀取.ini配置文件中的某段

[base]
name=os_repo
baseurl=https://xxx/centos/$releasever/os/$basearch
gpgcheck=0

enable=1

[mysql]
name=mysql_repo
baseurl=https://xxx/mysql-repo/yum/mysql-5.7-community/el/$releasever/$basearch

gpgcheck=0
enable=1

[epel]
name=epel_repo
baseurl=https://xxx/epel/$releasever/$basearch
gpgcheck=0
enable=1
[percona]
name=percona_repo
baseurl = https://xxx/percona/release/$releasever/RPMS/$basearch
enabled = 1
gpgcheck = 0

根據某字段去重

去掉uid=xxx重複的行。

2019-01-13_12:00_index?uid=123
2019-01-13_13:00_index?uid=123
2019-01-13_14:00_index?uid=333
2019-01-13_15:00_index?uid=9710
2019-01-14_12:00_index?uid=123
2019-01-14_13:00_index?uid=123
2019-01-15_14:00_index?uid=333
2019-01-16_15:00_index?uid=9710
awk -F"?" '!arr[$2]++{print}' a.txt

結果:

2019-01-13_12:00_index?uid=123
2019-01-13_14:00_index?uid=333
2019-01-13_15:00_index?uid=9710

次數統計

portmapper
portmapper
portmapper
portmapper
portmapper
portmapper
status
status
mountd
mountd
mountd
mountd
mountd
mountd
nfs
nfs
nfs_acl
nfs
nfs
nfs_acl
nlockmgr
nlockmgr
nlockmgr
nlockmgr
nlockmgr
awk '{arr[$1]++}END{OFS="\t";for(idx in arr){printf arr[idx],idx}}' a.txt

統計TCP連接狀態數量

$ netstat -tnap
Proto Recv-Q Send-Q Local Address   Foreign Address  State       PID/Program name
tcp        0      0 0.0.0.0:22      0.0.0.0:*        LISTEN      1139/sshd
tcp        0      0 127.0.0.1:25    0.0.0.0:*        LISTEN      2285/master
tcp        0     96 192.168.2.17:22 192.168.2.1:2468 ESTABLISHED 87463/sshd: root@pt
tcp        0      0 192.168.2017:22 192.168.201:5821 ESTABLISHED 89359/sshd: root@no
tcp6       0      0 :::3306         :::*             LISTEN      2289/mysqld
tcp6       0      0 :::22           :::*             LISTEN      1139/sshd
tcp6       0      0 ::1:25          :::*             LISTEN      2285/master

統計得到的結果:

5: LISTEN
2: ESTABLISHED

一行式:

netstat -tna | awk '/^tcp/{arr[$6]++}END{for(state in arr){print arr[state] ": " state}}'
netstat -tna | /usr/bin/grep 'tcp' | awk '{print $6}' | sort | uniq -c

統計日誌中各IP訪問非200狀態碼的次數

日誌示例數據:

111.202.100.141 - - [2019-11-07T03:11:02+08:00] "GET /robots.txt HTTP/1.1" 301 169 

統計非200狀態碼的IP,並取次數最多的前10個IP。

# 法一
awk '$8!=200{arr[$1]++}END{for(i in arr){print arr[i],i}}' access.log | sort -k1nr | head -n 10

# 法二:
awk '
    $8!=200{arr[$1]++}
    END{
        PROCINFO["sorted_in"]="@val_num_desc";
        for(i in arr){
            if(cnt++==10){exit}
            print arr[i],i
        }
}' access.log

統計獨立IP

​ url 訪問IP 訪問時間訪問人

a.com.cn|202.109.134.23|2015-11-20 20:34:43|guest
b.com.cn|202.109.134.23|2015-11-20 20:34:48|guest
c.com.cn|202.109.134.24|2015-11-20 20:34:48|guest
a.com.cn|202.109.134.23|2015-11-20 20:34:43|guest
a.com.cn|202.109.134.24|2015-11-20 20:34:43|guest
b.com.cn|202.109.134.25|2015-11-20 20:34:48|guest

需求:統計每個URL的獨立訪問IP有多少個(去重),並且要為每個URL保存一個對應的文件,得到的結果類似:

a.com.cn  2
b.com.cn  2
c.com.cn  1

並且有三個對應的文件:

a.com.cn.txt
b.com.cn.txt
c.com.cn.txt

代碼:

處理字段缺失的數據

ID  name    gender  age  email          phone
1   Bob     male    28   abc@qq.com     18023394012
2   Alice   female  24   def@gmail.com  18084925203
3   Tony    male    21                  17048792503
4   Kevin   male    21   bbb@189.com    17023929033
5   Alex    male    18   ccc@xyz.com    18185904230
6   Andy    female       ddd@139.com    18923902352
7   Jerry   female  25   exdsa@189.com  18785234906
8   Peter   male    20   bax@qq.com     17729348758
9   Steven          23   bc@sohu.com    15947893212
10  Bruce   female  27   bcbd@139.com   13942943905

當字段缺失時,直接使用FS劃分字段來處理會非常棘手。gawk為了解決這種特殊需求,提供了FIELDWIDTHS變量。

FIELDWIDTH可以按照字符數量劃分字段。

awk '{print $4}' FIELDWIDTHS="2 2:6 2:6 2:3 2:13 2:11" a.txt

處理字段中包含了字段分隔符的數據

下面是CSV文件中的一行,該CSV文件以逗號分隔各個字段。

Robbins,Arnold,"1234 A Pretty Street, NE",MyTown,MyState,12345-6789,USA

需求:取得第三個字段”1234 A Pretty Street, NE”。

當字段中包含了字段分隔符時,直接使用FS劃分字段來處理會非常棘手。gawk為了解決這種特殊需求,提供了FPAT變量。

FPAT可以收集正則匹配的結果,並將它們保存在各個字段中。(就像grep匹配成功的部分會加顏色顯示,而使用FPAT劃分字段,則是將匹配成功的部分保存在字段$1 $2 $3...中)。

echo 'Robbins,Arnold,"1234 A Pretty Street, NE",MyTown,MyState,12345-6789,USA' |\
awk 'BEGIN{FPAT="[^,]+|\".*\""}{print $1,$3}'

取字段中指定字符數量

16  001agdcdafasd
16  002agdcxxxxxx
23  001adfadfahoh
23  001fsdadggggg

得到:

16  001
16  002
23  001
23  002
awk '{print $1,substr($2,1,3)}'
awk 'BEGIN{FIELDWIDTH="2 2:3"}{print $1,$2}' a.txt

行列轉換

name age
alice 21
ryan 30

轉換得到:

name alice ryan
age 21 30
awk '
    {
      for(i=1;i<=NF;i++){
        if(!(i in arr)){
          arr[i]=$i
        } else {
            arr[i]=arr[i]" "$i
        }
      }
    }
    END{
        for(i=1;i<=NF;i++){
            print arr[i]
        }
    }
' a.txt

行列轉換2

文件內容:

74683 1001
74683 1002
74683 1011
74684 1000
74684 1001
74684 1002
74685 1001
74685 1011
74686 1000
....
100085 1000
100085 1001

文件就兩列,希望處理成

74683 1001 1002 1011
74684 1000 1001 1002
...

就是只要第一列數字相同, 就把他們的第二列放一行上,中間空格分開

{
  if($1 in arr){
    arr[$1] = arr[$1]" "$2
  } else {
    arr[$1] = $2
  }
  
}

END{
  for(i in arr){
    printf "%s %s\n",i,arr[i]
  }
}

篩選給定時間範圍內的日誌

grep/sed/awk用正則去篩選日誌時,如果要精確到小時、分鐘、秒,則非常難以實現。

但是awk提供了mktime()函數,它可以將時間轉換成epoch時間值。

# 2019-11-10 03:42:40轉換成epoch
$ awk 'BEGIN{print mktime("2019 11 10 03 42 40")}'
1573328560

藉此,可以取得日誌中的時間字符串部分,再將它們的年、月、日、時、分、秒都取出來,然後放入mktime()構建成對應的epoch值。因為epoch值是數值,所以可以比較大小,從而決定時間的大小。

下面strptime1()實現的是將2019-11-10T03:42:40+08:00格式的字符串轉換成epoch值,然後和which_time比較大小即可篩選出精確到秒的日誌。

下面strptime2()實現的是將10/Nov/2019:23:53:44+08:00格式的字符串轉換成epoch值,然後和which_time比較大小即可篩選出精確到秒的日誌。

BEGIN{
  # 要篩選什麼時間的日誌,將其時間構建成epoch值
  which_time = mktime("2019 11 10 03 42 40")
}

{
  # 取出日誌中的日期時間字符串部分
  match($0,"^.*\\[(.*)\\].*",arr)
  
  # 將日期時間字符串轉換為epoch值
  tmp_time = strptime2(arr[1])
  
  # 通過比較epoch值來比較時間大小
  if(tmp_time > which_time){
    print 
  }
}

# 構建的時間字符串格式為:"10/Nov/2019:23:53:44+08:00"
function strptime2(str   ,dt_str,arr,Y,M,D,H,m,S) {
  dt_str = gensub("[/:+]"," ","g",str)
  # dt_sr = "10 Nov 2019 23 53 44 08 00"
  split(dt_str,arr," ")
  Y=arr[3]
  M=mon_map(arr[2])
  D=arr[1]
  H=arr[4]
  m=arr[5]
  S=arr[6]
  return mktime(sprintf("%s %s %s %s %s %s",Y,M,D,H,m,S))
}

function mon_map(str   ,mons){
  mons["Jan"]=1
  mons["Feb"]=2
  mons["Mar"]=3
  mons["Apr"]=4
  mons["May"]=5
  mons["Jun"]=6
  mons["Jul"]=7
  mons["Aug"]=8
  mons["Sep"]=9
  mons["Oct"]=10
  mons["Nov"]=11
  mons["Dec"]=12
  return mons[str]
}

去掉/**/中間的註釋

示例數據:

/*AAAAAAAAAA*/
1111
222

/*aaaaaaaaa*/
32323
12341234
12134 /*bbbbbbbbbb*/ 132412

14534122
/*
    cccccccccc
*/
xxxxxx /*ddddddddddd
    cccccccccc
    eeeeeee
*/ yyyyyyyy
5642341

前後段落關係判斷

從如下類型的文件中,找出false段的前一段為i-order的段,同時輸出這兩段。

2019-09-12 07:16:27 [-][
  'data' => [
    'http://192.168.100.20:2800/api/payment/i-order',
  ],
]
2019-09-12 07:16:27 [-][
  'data' => [
    false,
  ],
]
2019-09-21 07:16:27 [-][
  'data' => [
    'http://192.168.100.20:2800/api/payment/i-order',
  ],
]
2019-09-21 07:16:27 [-][
  'data' => [
    'http://192.168.100.20:2800/api/payment/i-user',
  ],
]
2019-09-17 18:34:37 [-][
  'data' => [
    false,
  ],
]
BEGIN{
  RS="]\n"
  ORS=RS
}
{
  if(/false/ && prev ~ /i-order/){
    print tmp
    print
  }
  tmp=$0
}

兩個文件的處理

有兩個文件file1和file2,這兩個文件格式都是一樣的。

需求:先把文件2的第五列刪除,然後用文件2的第一列減去文件一的第一列,把所得結果對應的貼到原來第五列的位置,請問這個腳本該怎麼編寫?

file1:
50.481  64.634  40.573  1.00  0.00
51.877  65.004  40.226  1.00  0.00
52.258  64.681  39.113  1.00  0.00
52.418  65.846  40.925  1.00  0.00
49.515  65.641  40.554  1.00  0.00
49.802  66.666  40.358  1.00  0.00
48.176  65.344  40.766  1.00  0.00
47.428  66.127  40.732  1.00  0.00
51.087  62.165  40.940  1.00  0.00
52.289  62.334  40.897  1.00  0.00
file2:
48.420  62.001  41.252  1.00  0.00
45.555  61.598  41.361  1.00  0.00
45.815  61.402  40.325  1.00  0.00
44.873  60.641  42.111  1.00  0.00
44.617  59.688  41.648  1.00  0.00
44.500  60.911  43.433  1.00  0.00
43.691  59.887  44.228  1.00  0.00
43.980  58.629  43.859  1.00  0.00
42.372  60.069  44.032  1.00  0.00
43.914  59.977  45.551  1.00  0.00

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

二、從零開始搭建自己的靜態博客 — 主題篇

我們已經成功地在本地搭建了一個博客網站,它使用的是pelican默認的notmyidea主題;

如果你不太記得了,可以再看看這篇文章:;

其實,pelican擁有眾多的開源主題庫,我們可以在上選擇一個自己喜歡的主題應用到項目中;

網站提供在線預覽主題的功能;

我選擇的是主題,它的在線Demo是:;

下面,我們來一步一步的將其應用到我們的項目中;

1. 下載主題

我粗略的瀏覽了一下pelican-alchemy的文檔和issue列表,考慮到後續有可能會做一些修改,所以我決定先將其fork到自己的倉庫;

然後,我在項目根目錄新建一個目錄themes/用於存放所有下載的主題,然後將fork後的pelican-alchemy作為一個獨立的子倉庫克隆到目錄下:

λ mkdir themes
λ git submodule add git@github.com:luizyao/pelican-alchemy.git themes/pelican-alchemy

注意:

git submodule add <url> <path>命令是將一個倉庫添加到指定的目錄下作為獨立的子倉庫;

如果你仔細觀察,會發現我們的根目錄下多了一個文件:.gitmodules,它記錄了子倉庫的信息;

例如:我們項目中這個文件的內容是:

[submodule "themes/pelican-alchemy"]
    path = themes/pelican-alchemy
    url = git@github.com:luizyao/pelican-alchemy.git

常用的和子倉庫的相關的操作有下面幾個:

  • 克隆父倉庫時,連同子倉庫一起克隆:

    git clone --recurse-submodules <URL> <directory>
  • 查看父倉庫中所有子倉庫的狀態:

    λ git submodule status
    3381c5031bf30d3b1212619b662898f178d695f1 themes/pelican-alchemy (v2.1-43-g3381c50)

    3381c5031bf30d3b1212619b662898f178d695f1是對當前Commit Id的SHA-1加密字串;

  • 刪除子倉庫:

    git rm <submodule path> && git commit

    再手動刪除.git/modules/<name>/目錄

如果你想了解更多關於git submodule的內容,可以通過git submodule --help閱讀它的官方文檔;

2. 使用主題

2.1. 基本配置

# pelicanconf.py

# 主題所在的相對目錄
THEME = 'themes/pelican-alchemy/alchemy'

# 副標題
SITESUBTITLE = '戒驕戒躁 砥礪前行'

# 頭像
SITEIMAGE = '/images/profile.png width=200 height=200'

# 友鏈
LINKS = (
    ('pytest-chinese-doc', 'https://luizyao.github.io/pytest-chinese-doc/'),
)

# 代碼高亮的樣式
PYGMENTS_STYLE = 'friendly'

# 使用 Bootswatch 樣式:https://bootswatch.com/
BOOTSTRAP_CSS = 'https://cdn.bootcss.com/bootswatch/4.3.1/lux/bootstrap.min.css'

# 生成 sitemap.xml 文件,它是一個對爬蟲友好的文件,方便搜索引擎抓取網站頁面
DIRECT_TEMPLATES = ['index', 'tags', 'categories', 'authors', 'archives', 'sitemap']
SITEMAP_SAVE_AS = 'sitemap.xml'

# 構建后的 html 文件路徑和 URL 標識
ARTICLE_URL = 'posts/{date:%Y}/{date:%m}/{slug}.html'
ARTICLE_SAVE_AS = ARTICLE_URL
DRAFTS_URL = 'drafts/{date:%Y}/{date:%m}/{slug}.html'
DRAFTS_SAVE_AS = ARTICLE_URL
PAGE_URL = 'pages/{slug}.html'
PAGE_SAVE_AS = PAGE_URL

# RSS 訂閱
FEED_ALL_RSS = 'feeds/all.rss.xml'

具體細節可以參考:

2.2. 高級配置

2.2.1. 配置網站圖標

通過在線工具可以生成適配各種平台和瀏覽器的favicon文件:

下載上面生成的favicon包,並解壓到項目content/extras目錄下:

λ ls content/extras/
android-chrome-192x192.png  favicon.ico         safari-pinned-tab.svg
android-chrome-384x384.png  favicon-16x16.png   site.webmanifest
apple-touch-icon.png        favicon-32x32.png
browserconfig.xml           mstile-150x150.png

修改模版中的base.html文件:

<!-- themes/pelican-alchemy/alchemy/templates/base.html --> 

{% if RFG_FAVICONS %}
  <link rel="apple-touch-icon" href="{{ SITEURL }}/apple-touch-icon.png" sizes="180x180">
  <link rel="icon" type="image/png" href="{{ SITEURL }}/favicon-32x32.png" sizes="32x32">
  <link rel="icon" type="image/png" href="{{ SITEURL }}/favicon-16x16.png" sizes="16x16">
  <link rel="manifest" href="{{ SITEURL }}/manifest.json">
  <meta name="theme-color" content="#333333">
{% endif %}

<!-- 改成 --> 

{% if RFG_FAVICONS %}
  <link rel="apple-touch-icon" href="{{ SITEURL }}/apple-touch-icon.png" sizes="180x180">
  <link rel="icon" type="image/png" href="{{ SITEURL }}/favicon-32x32.png" sizes="32x32">
  <link rel="icon" type="image/png" href="{{ SITEURL }}/favicon-16x16.png" sizes="16x16">
  <link rel="manifest" href="{{ SITEURL }}/site.webmanifest">
  <link rel="mask-icon" href="{{ SITEURL }}/safari-pinned-tab.svg" color="#5bbad5">
  <meta name="msapplication-TileColor" content="#da532c">
  <meta name="theme-color" content="#ffffff">
{% endif %}

修改pelicanconf.py配置文件:

# pelicanconf.py

# 在構建中,它們會無損的拷貝到 output 的同名目錄下
STATIC_PATHS = ['extras', 'images', 'css']

# 構建時,extras/android-chrome-192x192.png文件,拷貝到output/android-chrome-192x192.png,不再是output/extras/android-chrome-192x192.png
EXTRA_PATH_METADATA = {
    'extras/android-chrome-192x192.png': {'path': 'android-chrome-192x192.png'},
    'extras/android-chrome-512x512.png': {'path': 'android-chrome-512x512.png'},
    'extras/apple-touch-icon.png': {'path': 'apple-touch-icon.png'},
    'extras/browserconfig.xml': {'path': 'browserconfig.xml'},
    'extras/favicon-16x16.png': {'path': 'favicon-16x16.png'},
    'extras/favicon-32x32.png': {'path': 'favicon-32x32.png'},
    'extras/favicon.ico': {'path': 'favicon.ico'},
    'extras/manifest.json': {'path': 'manifest.json'},
    'extras/mstile-150x150.png': {'path': 'mstile-150x150.png'},
    'extras/safari-pinned-tab.svg': {'path': 'safari-pinned-tab.svg'},
    # 自定義樣式
    'css/custom.css': {'path': 'theme/css/custom.css'},
}

# 自定義樣式的URL目錄
THEME_CSS_OVERRIDES = ('theme/css/custom.css',)

RFG_FAVICONS = True

2.2.2.更新Font Awesome的版本

pelican-alchemy使用Font Awesome 4.7.0版本,並且使用的是靜態資源的相對引用;

我們將其修改為最新的5.11.2版本的CDN引入,修改主題模版中的base.html文件:

<!-- themes/pelican-alchemy/alchemy/templates/base.html --> 

<link rel="stylesheet" href="{{ SITEURL }}/theme/css/font-awesome.min.css">

<!-- 改成 --> 

<link href="https://cdn.bootcss.com/font-awesome/5.11.2/css/fontawesome.min.css" rel="stylesheet">
<link href="https://cdn.bootcss.com/font-awesome/5.11.2/css/solid.css" rel="stylesheet">
<link href="https://cdn.bootcss.com/font-awesome/5.11.2/css/brands.css" rel="stylesheet">

除了上面的步驟,我們還有一個額外的工作要做:因為5.x的版本已經不使用fa前綴,取而代之的是fas()和fab();

所以,對於主題中那些類似class="fa fa-github"的樣式,應該修改為class="fab fa-github",主要涉及article.html、index.html和header.html這些文件;

最後,修改pelicanconf.py文件中關於ICONS配置的格式,需要額外指定樣式類別:

# pelicanconf.py

# 社交屬性,請到<https://fontawesome.com/icons>網站確定圖標樣式的類別
ICONS = [
    ('fab', 'github', 'https://github.com/luizyao'),
    ('fas', 'blog', 'https://www.cnblogs.com/luizyao/'),
    ('fas', 'rss', 'feeds/all.rss.xml')
]

pelican-alchemy有一個open的issue:是關於Font Awesome版本的,後續可能會更新到5.x版本,目前issue處於接收反饋的狀態;

至於為什麼不使用CDN,貌似還和偉大的防火牆有關呢。。。

I’m sure you’ve heard of the Great Firewall of China; India, Russia, some African countries are doing similar things. You never know which URL or IP might become inaccessible

2.2.3.使用Bootstrap的樣式

我們可以為特定類型的元素添加Bootstrap的官方樣式;例如:為每個img元素添加class = "img-fluid"的樣式;

首先,安裝依賴包:

# beautifulsoup4為插件所依賴的第三方包
λ pipenv install beautifulsoup4

然後,下載插件:

λ mkdir plugins
λ git submodule add git@github.com:ingwinlu/pelican-bootstrapify.git plugins/pelican-bootstrapify

最後,修改pelicanconf.py配置文件:

# 到哪裡尋找插件
PLUGIN_PATHS = ['plugins']

# 想要使用的插件名
PLUGINS = ['pelican-bootstrapify']

# 想要添加的 Bootstrap 樣式
BOOTSTRAPIFY = {
    'table': ['table', 'table-striped', 'table-hover'],
    'img': ['img-fluid'],
}

2.3. 定製主題

下面我們為pelican-alchemy做一些定製化的操作,添加一些新的功能;

2.3.1. 添加返回頂部鏈接

修改base.html文件,在<head>中添加如下部分:

<!-- themes/pelican-alchemy/alchemy/templates/base.html --> 

<script src="https://cdn.bootcss.com/jquery/3.4.1/jquery.min.js"></script>
<script src="https://cdn.bootcss.com/scrollup/2.4.1/jquery.scrollUp.min.js"></script>

<script>
  $(function () {
    $.scrollUp({
      scrollText: '<i class="fas fa-2x fa-chevron-circle-up"></i>'
    });
  });
</script>

2.3.2. 支持目錄

我自己寫了一個的插件,用於替代pelican默認的MarkdownReader,它有以下功能:

  • 使用增強的markdown解析

    • 代替markdown.extensions.extra;
    • 代替markdown.extensions.codehilite;
  • 支持以下方式生成文章目錄:

    1. 在markdown文本內的[TOC]標記處生成目錄;

    2. 通過元數據toc自定義目錄樣式;例如:

      {% if article.toc %}
        <aside class="col-md-4">
          <div class="widget widget-content">
            <h3 class="widget-title">文章目錄</h3>
            <div class="toc">
              <ul>
                {{ article.toc | safe }}
              </ul>
            </div>
          </div>
        </aside>
      {% endif %}
  • 如果沒配summary或者summary為空,支持自動截取開頭部分字符作為摘要;

使用方法:

  1. 作為一個子倉庫下載

    # 項目根目錄創建目錄
    λ mkdir plugins
    # 下載
    λ git submodule add git@github.com:luizyao/pelican-md-reader.git plugins/pelican-md-reader
  2. 修改pelicanconf.py配置文件

    # pelicanconf.py
    
    # 到哪裡尋找插件
    PLUGIN_PATHS = ['plugins']
    
    # 想要使用的插件名
    PLUGINS = ['pelican-md-reader']

更多細節可以參考:

2.3.3. 漢化

主要關鍵字漢化;

3.完整的pelicanconf.py文件

#!/usr/bin/env python
# -*- coding: utf-8 -*- #
from __future__ import unicode_literals

AUTHOR = 'luizyao'
SITENAME = "luizyao's blog"
SITEURL = ''

PATH = 'content'

DEFAULT_LANG = 'en'

# Feed generation is usually not desired when developing
FEED_ALL_ATOM = None
CATEGORY_FEED_ATOM = None
TRANSLATION_FEED_ATOM = None
AUTHOR_FEED_ATOM = None
AUTHOR_FEED_RSS = None

DEFAULT_PAGINATION = 10

# Uncomment following line if you want document-relative URLs when developing
# RELATIVE_URLS = True

# 修改時區
TIMEZONE = 'Asia/Shanghai'

# 修改默認的時間格式('%a %d %B %Y')
DEFAULT_DATE_FORMAT = "%Y-%m-%d %H:%M"

# 為元數據定義默認值
DEFAULT_METADATA = {
    # 默認發布的文章都是草稿,除非在文章元數據中明確指定:Status: published
    'status': 'draft',
}

# pelican-alchemy 原有的配置

# 主題所在的相對目錄
THEME = 'themes/pelican-alchemy/alchemy'

# 副標題
SITESUBTITLE = '戒驕戒躁 砥礪前行'

# 頭像
SITEIMAGE = '/images/profile.png width=200 height=200'

# 友鏈
LINKS = (
    ('pytest-chinese-doc', 'https://luizyao.github.io/pytest-chinese-doc/'),
)

# 代碼高亮的樣式
PYGMENTS_STYLE = 'friendly'

# 使用 Bootswatch 樣式:https://bootswatch.com/
BOOTSTRAP_CSS = 'https://cdn.bootcss.com/bootswatch/4.3.1/lux/bootstrap.min.css'

# 生成 sitemap.xml 文件
DIRECT_TEMPLATES = ['index', 'tags', 'categories', 'authors', 'archives', 'sitemap']
SITEMAP_SAVE_AS = 'sitemap.xml'

# 構建后的 html 文件路徑和 URL 標識
ARTICLE_URL = 'posts/{date:%Y}/{date:%m}/{slug}.html'
ARTICLE_SAVE_AS = ARTICLE_URL
DRAFTS_URL = 'drafts/{date:%Y}/{date:%m}/{slug}.html'
DRAFTS_SAVE_AS = ARTICLE_URL
PAGE_URL = 'pages/{slug}.html'
PAGE_SAVE_AS = PAGE_URL

# RSS 訂閱
FEED_ALL_RSS = 'feeds/all.rss.xml'

# 在構建中,它們會無損的拷貝到 output 的同名目錄下
STATIC_PATHS = ['extras', 'images', 'css']

# 構建時,extras/android-chrome-192x192.png文件,拷貝到output/android-chrome-192x192.png,不再是output/extras/android-chrome-192x192.png
EXTRA_PATH_METADATA = {
    'extras/android-chrome-192x192.png': {'path': 'android-chrome-192x192.png'},
    'extras/android-chrome-512x512.png': {'path': 'android-chrome-512x512.png'},
    'extras/apple-touch-icon.png': {'path': 'apple-touch-icon.png'},
    'extras/browserconfig.xml': {'path': 'browserconfig.xml'},
    'extras/favicon-16x16.png': {'path': 'favicon-16x16.png'},
    'extras/favicon-32x32.png': {'path': 'favicon-32x32.png'},
    'extras/favicon.ico': {'path': 'favicon.ico'},
    'extras/manifest.json': {'path': 'manifest.json'},
    'extras/mstile-150x150.png': {'path': 'mstile-150x150.png'},
    'extras/safari-pinned-tab.svg': {'path': 'safari-pinned-tab.svg'},
    # 自定義樣式
    'css/custom.css': {'path': 'theme/css/custom.css'},
}

# 自定義樣式的URL目錄
THEME_CSS_OVERRIDES = ('theme/css/custom.css',)

RFG_FAVICONS = True

# 到哪裡尋找插件
PLUGIN_PATHS = ['plugins']

# 想要使用的插件名
PLUGINS = ['pelican-bootstrapify', 'pelican-md-reader']

# 想要添加的 Bootstrap 樣式
BOOTSTRAPIFY = {
    'table': ['table', 'table-striped', 'table-hover'],
    'img': ['img-fluid'],
}

# 社交屬性,請到<https://fontawesome.com/icons>網站確定圖標樣式的類別
ICONS = [
    ('fab', 'github', 'https://github.com/luizyao'),
    ('fas', 'blog', 'https://www.cnblogs.com/luizyao/'),
    ('fas', 'rss', 'feeds/all.rss.xml')
]

4. 預覽

Github:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※高價收購3C產品,價格不怕你比較

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

dom4j的測試例子和源碼詳解(重點對比和DOM、SAX的區別)

目錄

簡介

dom4j用於創建和解析XML文件,不是純粹的DOM或SAX,而是兩者的結合和改進,另外,dom4j支持Xpath來獲取節點。目前,由於其出色的性能和易用性,目前dom4j已經得到廣泛使用,例如Spring、Hibernate就是使用dom4j來解析xml配置。

注意,dom4j使用Xpath需要額外引入jaxen的包。

DOM、SAX、JAXP和DOM4J

其實,JDK已經帶有可以解析xml的api,如DOM、SAX、JAXP,但為什麼dom4j會更受歡迎呢?它們有什麼區別呢?在學習dom4j之前,需要先理解下DOM、SAX等概念,因為dom4j就是在此基礎上改進而來。

xerces解釋器

先介紹下xerces解釋器,下面介紹的SAX、DOM和JAXP都只是接口,而xerces解釋器就是它們的具體實現,在com.sun.org.apache.xerces.internal包。xerces被稱為性能最好的解釋器,除了xerces外,還有其他的第三方解釋器,如crimson。

SAX

JDK針對解析xml提供的接口,不是具體實現,在org.xml.sax包。SAX是基於事件處理,解析過程中根據當前的XML元素類型,調用用戶自己實現的回調方法,如:startDocument();,startElement()。下面以例子說明,通過SAX解析xml並打印節點名:

    /*這裏解釋下四個的接口:
    EntityResolver:需要實現resolveEntity方法。當解析xml需要引入外部數據源時觸發,通過這個方法可以重定向到本地數據源或進行其他操作。
    DTDHandler:需要實現notationDecl和unparsedEntityDecl方法。當解析到"NOTATION", "ENTITY"或 "ENTITIES"時觸發。
    ContentHandler:最常用的一個接口,需要實現startDocument、endDocument、startElement、endElement等方法。當解析到指定元素類型時觸發。
    ErrorHandler:需要實現warning、error或fatalError方法。當解析出現異常時會觸發。
    */
    @Test
    public void test04() throws Exception {
        //DefaultHandler實現了EntityResolver, DTDHandler, ContentHandler, ErrorHandler四個接口     
        DefaultHandler handler = new DefaultHandler() {
            @Override
            //當解析到Element時,觸發打印該節點名
            public void startElement(String uri, String localName, String qName, Attributes attributes) throws SAXException {
                System.out.println(qName);
            }
        };
        //獲取解析器實例
        XMLReader xr = XMLReaderFactory.createXMLReader();
        //設置處理類
        xr.setContentHandler(handler);
        /*
         * xr.setErrorHandler(handler); 
         * xr.setDTDHandler(handler); 
         * xr.setEntityResolver(handler);
         */
        xr.parse(new InputSource("members.xml"));
    }

因為SAX是基於事件處理的,不需要等到整個xml文件都解析完才執行我們的操作,所以效率較高。但SAX存在一個較大缺點,就是不能隨機訪問節點,因為SAX不會主動地去保存處理過的元素(優點就是內存佔用小、效率高),如果想要保存讀取的元素,開發人員先構建出一個xml樹形結構,再手動往裡面放入元素,非常麻煩(其實dom4j就是通過SAX來構建xml樹)。

DOM

JDK針對解析xml提供的接口,不是具體實現,在org.w3c.dom包。DOM採用了解析方式是一次性加載整個XML文檔,在內存中形成一個樹形的數據結構,開發人員可以隨機地操作元素。見以下例子:

    @SuppressWarnings("restriction")
    @Test
    public void test05() throws Exception {
        //獲得DOMParser對象
        com.sun.org.apache.xerces.internal.parsers.DOMParser domParser = new com.sun.org.apache.xerces.internal.parsers.DOMParser();
        //解析文件
        domParser.parse(new InputSource("members.xml"));
        //獲得Document對象
        Document document=domParser.getDocument();
        // 遍歷節點
        printNodeList(document.getChildNodes());        
    }

通過DOM解析,我們可以獲取任意節點進行操作。但是,DOM有兩個缺點:

  1. 由於一次性加載整個XML文件到內存,當處理較大文件時,容易出現內存溢出。
  2. 節點的操作還是比較繁瑣。

以上兩點,dom4j都進行了相應優化。

JAXP

封裝了SAX、DOM兩種接口,它並沒有為JAVA解析XML提供任何新功能,只是對外提供更解耦、簡便操作的API。如下:

DOM解析器

    @Test
    public void test02() throws Exception {
        // 獲得DocumentBuilder對象
        DocumentBuilderFactory factory = DocumentBuilderFactory.newInstance();
        DocumentBuilder builder = factory.newDocumentBuilder();
        // 解析xml文件,獲得Document對象
        Document document = builder.parse("members.xml");
        // 遍歷節點
        printNodeList(document.getChildNodes());
    }

獲取SAX解析器

    @Test
    public void test03() throws Exception {
        SAXParserFactory factory = SAXParserFactory.newInstance();
        SAXParser saxParser = factory.newSAXParser();
        saxParser.parse("members.xml", new DefaultHandler() {
            @Override
            public void startElement(String uri, String localName, String qName, Attributes attributes) throws SAXException {
                System.out.println(qName);
            }
        });
    }

其實,JAXP並沒有很大程度提高DOM和SAX的易用性,更多地體現在獲取解析器時實現解耦。完全沒有解決SAX和DOM的缺點。

DOM4j

對比過dom4j和JAXP就會發現,JAXP本質上還是將SAX和DOM當成兩套API來看待,而dom4j就不是,它將SAX和DOM結合在一起使用,取長補短,並對原有的api進行了改造,在使用簡便性、性能、面向接口編程等方面都要優於JDK自帶的SAX和DOM。

以下通過使用例子和源碼分析將作出說明。

項目環境

工程環境

JDK:1.8

maven:3.6.1

IDE:sts4

dom4j:2.1.1

創建項目

項目類型Maven Project,打包方式jar。

引入依賴

注意:dom4j使用XPath,必須引入jaxen的jar包。

<!-- junit -->
<dependency>
    <groupId>junit</groupId>
    <artifactId>junit</artifactId>
    <version>4.12</version>
    <scope>test</scope>
</dependency>
<!-- dom4j的jar包 -->
<dependency>
    <groupId>org.dom4j</groupId>
    <artifactId>dom4j</artifactId>
    <version>2.1.1</version>
</dependency>
<!-- dom4j使用XPath需要的jar包 -->
<dependency>
    <groupId>jaxen</groupId>
    <artifactId>jaxen</artifactId>
    <version>1.1.6</version>
</dependency>
<!-- 配置BeanUtils的包,這個我自定義工具類用的,如果只是簡單使用dom4j可以不引入 -->
<dependency>
    <groupId>commons-beanutils</groupId>
    <artifactId>commons-beanutils</artifactId>
    <version>1.9.3</version>
</dependency>

使用例子–生成xml文件

本例子將分別使用dom4j和JDK的DOM接口生成xml文件(使用JDK的DOM接口時會使用JAXP的API)。

需求

構建xml樹,添加節點,並生成xml文件。格式如下:

<?xml version="1.0" encoding="UTF-8"?>
<members>
  <students>
    <student name="張三" location="河南" age="18"/>
    <student name="李四" location="新疆" age="26"/>
    <student name="王五" location="北京" age="20"/>
  </students>
  <teachers>
    <teacher name="zzs" location="河南" age="18"/>
    <teacher name="zzf" location="新疆" age="26"/>
    <teacher name="lt" location="北京" age="20"/>
  </teachers>
</members>

生成xml文件–使用w3c的DOM接口

主要步驟

  1. 通過JAXP的API獲得Document對象,這個對象可以看成xml的樹;

  2. 將對象轉化為節點,並添加在Document這棵樹上;

  3. 通過Transformer對象將樹輸出到文件中。

編寫測試類

路徑:test目錄下的cn.zzs.dom4j。

注意:因為使用的是w3c的DOM接口,所以節點對象導的是org.w3c.dom包,而不是org.dom4j包。

    @Test
    public void test02() throws Exception {
        // 創建工廠對象
        DocumentBuilderFactory documentBuilderFactory = DocumentBuilderFactory.newInstance();
        // 創建DocumentBuilder對象
        DocumentBuilder documentBuilder = documentBuilderFactory.newDocumentBuilder();
        // 創建Document對象
        Document document = documentBuilder.newDocument();

        // 創建根節點
        Element root = document.createElement("members");
        document.appendChild(root);

        // 添加一級節點
        Element studentsElement = (Element)root.appendChild(document.createElement("students"));
        Element teachersElement = (Element)root.appendChild(document.createElement("teachers"));

        // 添加二級節點並設置屬性
        Element studentElement1 = (Element)studentsElement.appendChild(document.createElement("student"));
        studentElement1.setAttribute("name", "張三");
        studentElement1.setAttribute("age", "18");
        studentElement1.setAttribute("location", "河南");
        Element studentElement2 = (Element)studentsElement.appendChild(document.createElement("student"));
        studentElement2.setAttribute("name", "李四");
        studentElement2.setAttribute("age", "26");
        studentElement2.setAttribute("location", "新疆"); 
        Element studentElement3 = (Element)studentsElement.appendChild(document.createElement("student"));
        studentElement3.setAttribute("name", "王五");
        studentElement3.setAttribute("age", "20");
        studentElement3.setAttribute("location", "北京");     
        Element teacherElement1 = (Element)teachersElement.appendChild(document.createElement("teacher"));
        teacherElement1.setAttribute("name", "zzs");
        teacherElement1.setAttribute("age", "18");
        teacherElement1.setAttribute("location", "河南"); 
        Element teacherElement2 = (Element)teachersElement.appendChild(document.createElement("teacher"));
        teacherElement2.setAttribute("name", "zzf");
        teacherElement2.setAttribute("age", "26");
        teacherElement2.setAttribute("location", "新疆");     
        Element teacherElement3 = (Element)teachersElement.appendChild(document.createElement("teacher"));
        teacherElement3.setAttribute("name", "lt");
        teacherElement3.setAttribute("age", "20");
        teacherElement3.setAttribute("location", "北京"); 
            
        // 獲取文件對象
        File file = new File("members.xml");
        if(!file.exists()) {
            file.createNewFile();
        }
        // 獲取Transformer對象
        TransformerFactory transformerFactory = TransformerFactory.newInstance();
        Transformer transformer = transformerFactory.newTransformer();
        // 設置編碼、美化格式
        transformer.setOutputProperty(OutputKeys.ENCODING, "UTF-8");
        transformer.setOutputProperty(OutputKeys.INDENT, "yes");
        // 創建DOMSource對象
        DOMSource domSource = new DOMSource(document);
        // 將document寫出
        transformer.transform(domSource, new StreamResult(new PrintWriter(new FileOutputStream(file))));    
    }   

測試結果

此時,在項目路徑下會生成members.xml,文件內容如下,可以看到,使用w3c的DOM接口輸出的內容沒有縮進格式。

<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<members>
<students>
<student age="18" location="河南" name="張三"/>
<student age="26" location="新疆" name="李四"/>
<student age="20" location="北京" name="王五"/>
</students>
<teachers>
<teacher age="18" location="河南" name="zzs"/>
<teacher age="26" location="新疆" name="zzf"/>
<teacher age="20" location="北京" name="lt"/>
</teachers>
</members>

生成xml文件–使用dom4j的DOM接口

主要步驟

  1. 通過DocumentHelper獲得Document對象,這個對象可以看成xml的樹;

  2. 將對象轉化為節點,並添加在Document這棵樹上;

  3. 通過XMLWriter對象將樹輸出到文件中。

編寫測試類

路徑:test目錄下的cn.zzs.dom4j。通過對比,可以看出,dom4j的API相比JDK的還是要方便很多。

注意:因為使用的是dom4j的DOM接口,所以節點對象導的是org.dom4j包,而不是org.w3c.dom包(dom4j一個很大的特點就是改造了w3c的DOM接口,極大地簡化了我們對節點的操作)。

    @Test
    public void test02() throws Exception {
        // 創建Document對象
        Document document = DocumentHelper.createDocument();

        // 添加根節點
        Element root = document.addElement("members");

        // 添加一級節點
        Element studentsElement = root.addElement("students");
        Element teachersElement = root.addElement("teachers");

        // 添加二級節點並設置屬性,dom4j改造了w3c的DOM接口,極大地簡化了我們對節點的操作
        studentsElement.addElement("student").addAttribute("name", "張三").addAttribute("age", "18").addAttribute("location", "河南");
        studentsElement.addElement("student").addAttribute("name", "李四").addAttribute("age", "26").addAttribute("location", "新疆");
        studentsElement.addElement("student").addAttribute("name", "王五").addAttribute("age", "20").addAttribute("location", "北京");
        teachersElement.addElement("teacher").addAttribute("name", "zzs").addAttribute("age", "18").addAttribute("location", "河南");
        teachersElement.addElement("teacher").addAttribute("name", "zzf").addAttribute("age", "26").addAttribute("location", "新疆");
        teachersElement.addElement("teacher").addAttribute("name", "lt").addAttribute("age", "20").addAttribute("location", "北京");

        // 獲取文件對象
        File file = new File("members.xml");
        if(!file.exists()) {
            file.createNewFile();
        }
        // 創建輸出格式,不設置的話不會有縮進效果
        OutputFormat format = OutputFormat.createPrettyPrint();
        format.setEncoding("UTF-8");
        // 獲得XMLWriter
        XMLWriter writer = new XMLWriter(new FileWriter(file), format);
        // 打印Document
        writer.write(document);
        // 釋放資源
        writer.close();
    }

測試結果

此時,在項目路徑下會生成members.xml,文件內容如下,可以看出dom4j輸出文件會進行縮進處理,而JDK的不會:

<?xml version="1.0" encoding="UTF-8"?>

<members>
  <students>
    <student name="張三" age="18" location="河南"/>
    <student name="李四" age="26" location="新疆"/>
    <student name="王五" age="20" location="北京"/>
  </students>
  <teachers>
    <teacher name="zzs" age="18" location="河南"/>
    <teacher name="zzf" age="26" location="新疆"/>
    <teacher name="lt" age="20" location="北京"/>
  </teachers>
</members>

使用例子–解析xml文件

需求

  1. 解析xml:解析上面生成的xml文件,將學生和老師節點按以下格式遍歷打印出來(當然也可以再封裝成對象返回給調用者,這裏就不擴展了)。
student:name=張三,location=河南,age=18
student:name=李四,location=新疆,age=26
student:name=王五,location=北京,age=20
teacher:name=zzs,location=河南,age=18
teacher:name=zzf,location=新疆,age=26
teacher:name=lt,location=北京,age=20
  1. dom4j結合XPath查找指定節點

主要步驟

  1. 通過SAXReader對象讀取和解析xml文件,獲得Document對象,即xml樹;

  2. 調用Node的方法遍歷打印xml樹的節點;

  3. 使用XPath查詢指定節點。

測試遍歷節點

考慮篇幅,這裏僅給出一種節點遍歷方式,項目源碼中還給出了其他的幾種。

    /**
     *  測試解析xml
     */
    @Test
    public void test03() throws Exception {
        // 創建指定文件的File對象
        File file = new File("members.xml");
        // 創建SAXReader
        SAXReader saxReader = new SAXReader();
        // 將xml文件讀入成document
        Document document = saxReader.read(file);
        // 獲得根元素
        Element root = document.getRootElement();
        // 遞歸遍歷節點
        list1(root);
    }

    /**
     * 遞歸遍歷節點
     */
    private void list1(Element parent) {
        if(parent == null) {
            return;
        }
        // 遍歷當前節點屬性並輸出
        printAttr(parent);
        // 遞歸打印子節點
        Iterator<Element> iterator2 = parent.elementIterator();
        while(iterator2.hasNext()) {
            Element son = (Element)iterator2.next();
            list1(son);
        }
    }

測試結果如下:

-------第一種遍歷方式:Iterator+遞歸--------
student:name=張三,location=河南,age=18
student:name=李四,location=新疆,age=26
student:name=王五,location=北京,age=20
teacher:name=zzs,location=河南,age=18
teacher:name=zzf,location=新疆,age=26
teacher:name=lt,location=北京,age=20

測試XPath獲取指定節點

    @Test
    public void test04() throws Exception {
        // 創建指定文件的File對象
        File file = new File("members.xml");
        // 創建SAXReader
        SAXReader saxReader = new SAXReader();
        // 將xml文件讀入成document
        Document document = saxReader.read(file);
        // 使用xpath隨機獲取節點
        List<Node> list = document.selectNodes("//members//students/student");
        // List<Node> list = xmlParser.getDocument().selectSingleNode("students");
        // 遍歷節點
        Iterator<Node> iterator = list.iterator();
        while(iterator.hasNext()) {
            Element element = (Element)iterator.next();
            printAttr(element);
        }
    }

測試結果如下:

student:age=18,location=河南,name=張三
student:age=26,location=新疆,name=李四
student:age=20,location=北京,name=王五

XPath語法

利用XPath獲取指定節點,平時用的比較多,這裏列舉下基本語法。

表達式 結果
/members 選取根節點下的所有members子節點
//members 選取根節點下的所有members節點
//students/student[1] 選取students下第一個student子節點
//students/student[last()] 選取students下的最後一個student子節點
//students/student[position()<3] 選取students下前兩個student子節點
//student[@age] 選取所有具有age屬性的student節點
//student[@age=’18’] 選取所有age屬性為18的student節點
//students/* 選取students下的所有節點
//* 選取文檔中所有節點
//student[@*] 選取所有具有屬性的節點
//members/students\ //members/teachers

源碼分析

本文會先介紹dom4j如何將xml元素抽象成具體的對象,再去分析dom4j解析xml文件的過程(注意,閱讀以下內容前需要了解和使用過JDK自帶的DOM和SAX)。

dom4j節點的類結構

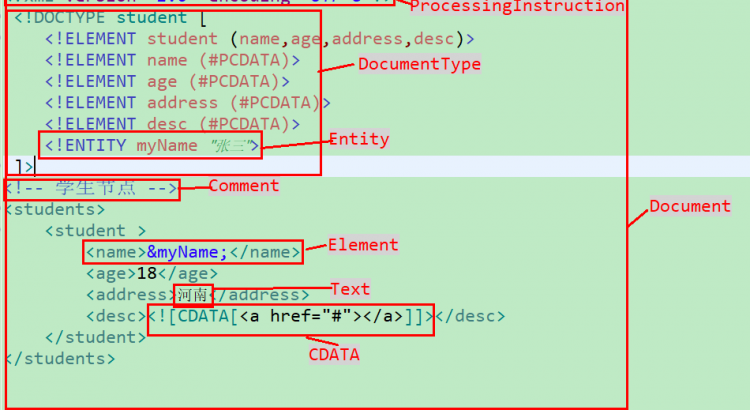
先來看下一個完整xml的元素組成,可以看出,一個xml文件包含了Document、Element、Comment、Attribute、DocumentType、Text等等。

DOM的思想就是將xml元素解析為具體對象,並構建樹形數據結構。基於此,w3c提供了xml元素的接口規範,dom4j基本借用了這套規範(如下圖),只是改造了接口的方法,使得我們操作時更加簡便。

SAXReader.read(File file)

通過使用例子可知,我們解析xml文件的入口是SAXReader對象的read方法,入參可以是文件路徑、url、字節流、字符流等,這裏以傳入文件路徑為例。

注意:考慮篇幅和可讀性,以下代碼經過刪減,僅保留所需部分。

    public Document read(File file) throws DocumentException {
        //不管是URI,path,character stream還是byte stream,都會包裝成InputSource對象
        InputSource source = new InputSource(new FileInputStream(file));
        if (this.encoding != null) {
            source.setEncoding(this.encoding);
        }
        
        //下面這段代碼是為了設置systemId,當傳入URI且沒有指定字符流和字節流時,可以通過systemId去連接URL並解析
        //如果一開始傳入了字符流或字節流,這個systemId就是可選的
        String path = file.getAbsolutePath();
        if (path != null) {
            StringBuffer sb = new StringBuffer("file://");
            if (!path.startsWith(File.separator)) {
                sb.append("/");
            }
            path = path.replace('\\', '/');
            sb.append(path);
            source.setSystemId(sb.toString());
        }

        //這裏調用重載方法解析InputSource對象
        return read(source);
    }

SAXReader.read(InputSource in)

看到這個方法的代碼時,使用過JDK的SAX的朋友應該很熟悉,沒錯,dom4j也是採用事件處理的機制來解析xml。其實,只是這裏設置的SAXContentHandler已經實現好了相關的方法,這些方法共同完成一件事情:構建xml樹。明白這一點,應該就能理解dom4j是如何解決SAX和DOM的缺點了。

注意:考慮篇幅和可讀性,以下代碼經過刪減,僅保留所需部分。

    public Document read(InputSource in) throws DocumentException {
        // 這裡會調用JAXP接口獲取XMLReader實現類對象
        XMLReader reader = getXMLReader();
        reader = installXMLFilter(reader);
        
        // 下面這些操作,是不是和使用JDK的SAX差不多,dom4j也是使用了事件處理機制。

        // EntityResolver:通過實現resolveEntity方法,當解析xml需要引入外部數據源時觸發,可以重定向到本地數據源或進行其他操作。
        EntityResolver thatEntityResolver = this.entityResolver;
        if (thatEntityResolver == null) {
            thatEntityResolver = createDefaultEntityResolver(in
                    .getSystemId());
            this.entityResolver = thatEntityResolver;
        }
        reader.setEntityResolver(thatEntityResolver);
        
        // 下面的SAXContentHandler繼承了DefaultHandler,即實現了EntityResolver, DTDHandler, ContentHandler, ErrorHandler等接口
        // 其中最重要的是ContentHandler接口,通過實現startDocument、endDocument、startElement、endElement等方法,當dom4j解析xml文件到指定元素類型時,可以觸發我們自定義的方法。
        // 當然,dom4j已經實現了ContentHandler的方法。具體實現的方法內容為:在解析xml時構建xml樹
        SAXContentHandler contentHandler = createContentHandler(reader);
        contentHandler.setEntityResolver(thatEntityResolver);
        contentHandler.setInputSource(in);
        boolean internal = isIncludeInternalDTDDeclarations();
        boolean external = isIncludeExternalDTDDeclarations();
        contentHandler.setIncludeInternalDTDDeclarations(internal);
        contentHandler.setIncludeExternalDTDDeclarations(external);
        contentHandler.setMergeAdjacentText(isMergeAdjacentText());
        contentHandler.setStripWhitespaceText(isStripWhitespaceText());
        contentHandler.setIgnoreComments(isIgnoreComments());
        reader.setContentHandler(contentHandler);

        configureReader(reader, contentHandler);
        
        // 使用事件處理機制解析xml,處理過程會構建xml樹
        reader.parse(in);
        // 返回構建好的xml樹
        return contentHandler.getDocument();
    }

SAXContentHandler

通過上面的分析,可知SAXContentHandler是dom4j構建xml樹的關鍵。這裏看下它的幾個重要方法和屬性。

startDocument()

    // xml樹
    private Document document;

    // 節點棧,棧頂存放當前解析節點(節點解析結束)、或當前解析節點的父節點(節點解析開始)
    private ElementStack elementStack;

    // 節點處理器,可以看成節點開始解析或結束解析的標誌
    private ElementHandler elementHandler;
    
    // 當前解析節點(節點解析結束)、或當前解析節點的父節點(節點解析開始)
    private Element currentElement;
    public void startDocument() throws SAXException {
        document = null;
        currentElement = null;
        
        // 清空節點棧
        elementStack.clear();
        // 初始化節點處理器
        if ((elementHandler != null)
                && (elementHandler instanceof DispatchHandler)) {
            elementStack.setDispatchHandler((DispatchHandler) elementHandler);
        }

        namespaceStack.clear();
        declaredNamespaceIndex = 0;

        if (mergeAdjacentText && (textBuffer == null)) {
            textBuffer = new StringBuffer();
        }

        textInTextBuffer = false;
    }

startElement(String,String,String,Attributes)

    public void startElement(String namespaceURI, String localName,
            String qualifiedName, Attributes attributes) throws SAXException {
        if (mergeAdjacentText && textInTextBuffer) {
            completeCurrentTextNode();
        }

        QName qName = namespaceStack.getQName(namespaceURI, localName,
                qualifiedName);
        // 獲取當前解析節點的父節點
        Branch branch = currentElement;

        if (branch == null) {
            branch = getDocument();
        }
        // 創建當前解析節點
        Element element = branch.addElement(qName);
        addDeclaredNamespaces(element);

        // 添加節點屬性
        addAttributes(element, attributes);
        
        //將當前節點壓入節點棧
        elementStack.pushElement(element);
        currentElement = element;
        entity = null; // fixes bug527062

        //標記節點解析開始
        if (elementHandler != null) {
            elementHandler.onStart(elementStack);
        }
    }

endElement(String, String, String)

    public void endElement(String namespaceURI, String localName, String qName)
            throws SAXException {
        if (mergeAdjacentText && textInTextBuffer) {
            completeCurrentTextNode();
        }
        // 標記節點解析結束
        if ((elementHandler != null) && (currentElement != null)) {
            elementHandler.onEnd(elementStack);
        }
        // 當前解析節點從節點棧中彈出
        elementStack.popElement();
        // 指定為棧頂節點
        currentElement = elementStack.peekElement();
    }

endDocument()

    public void endDocument() throws SAXException {
        namespaceStack.clear();
        // 清空節點棧
        elementStack.clear();
        currentElement = null;
        textBuffer = null;
    }

以上,dom4j的源碼分析基本已經分析完,其他具體細節後續再做補充。

參考以下資料:

本文為原創文章,轉載請附上原文出處鏈接:https://github.com/ZhangZiSheng001/dom4j-demo

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※平板收購,iphone手機收購,二手筆電回收,二手iphone收購-全台皆可收購

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益
SpringMvc demo示例及源碼詳細分析

三層架構介紹

  我們的開發架構一般都是基於兩種形式,一種C/S架構,也就是客戶端/服務器,另一種是B/S架構,也就是瀏覽器/服務器。在JavaEE開發中,幾乎全部都是基於B/S架構的開發。那麼在B/S架構中,系統標準的三層架構包括:表現層、業務層、持久層。三層架構在我們的實際開發中使用的非常多。

三層職責

表現層

  也就是我們長說的web層。它負責接收客戶端請求,向客戶端響應結果,通常客戶端使用http協議請求web層,web需要接收http請求,完成http響應。

  表現層包括展示層和控制層:控制層負責接收請求,展示層負責結果的展示。

  表現層依賴業務層,接收到客戶端請求一般會調用業務層進行業務處理,並將處理結果響應給客戶端。

  表現層的設計一般都是使用mvc模型。(mvc是表現層的設計模型,和其他層沒有關係)

業務層

  也就是我們常說的 service層。它負責業務邏輯處理,和我們開發項目的需求息息相關。web層依賴業務層,但是業務層不依賴web層。

  業務層在業務處理時可能會依賴持久層,如果要對數據持久化需要保證事務一致性。(也就是我們說的,事務應該放到業務層來控制)

持久層

  也就是我們常說的dao層。負責數據持久化,包括數據層即數據庫和數據訪問層,數據庫是對數據進行持久化的載體,數據訪問層是業務層和持久層交互的接口,業務層需要通過數據訪問層將數據持久化到數據庫中。

  通俗的講,持久層就是和數據交互,對數據庫表進行增刪改查的。

mvc設計模式介紹

  mvc全名是Model View Controller,模型(Model)-視圖(View)-控制器(Controller)的縮寫,是一種用於設計創建web應用程序表現層的模式。mvc中每個部分各司其職:

Model(模型)

  模型包含業務模型和數據模型,數據模型用於封裝數據,業務模型用於處理業務。

View(視圖)

  通常指的就是我們的jsp或者html。作用一般就是展示數據的。

  通過視圖是依據模型數據創建的。

Controller(控制器)

  是應用程序中處理用戶交互的部分。作用一般就是處理程序邏輯的。

SpringMVC介紹

Spring MVC是什麼?

  SpringMVC是一種基於Java的實現MVC設計模型的請求驅動類型的輕量級Web框架,屬於SpringFrameWork的後續產品,已經融合在Spring Web Flow裏面。Spring框架提供了構建Web應用程序的全功能MVC模塊。使用Spring可插入的MVC架構,從而在使用Spring進行Web開發時,可以選擇使用Spring的Spring MVC框架或集成其他MVC開發框架,如Struts1(現在一般不用),Struts2等。

  SpringMVC已經成為目前最主流的MVC框架之一,並隨着Spring3.0的發布,全面超越Struts2,成為最優秀的MVC框架。

  它通過一套註解,讓一個簡單的Java類稱為處理請求的控制器,而無需實現任何接口。同時它還支持RESTful編程風格的請求。

總結

  Spring MVC和Struts2一樣,都是為了解決表現層問題的web框架,他們都是基於MCC設計模式的。而這些表現層框架的主要職責就是處理前端HTTP請求。

 Spring MVC由來?

 Spring MVC全名叫Spring Web MVC,它是Spring家族Web模塊的一個重要成員。這一點,我們可以從Spring的整體結構中看的出來:


 為什麼學習SpringMVC?

   也許你會問,為什麼要學習Spring MVC呢?struts2不才是主流嘛?看SSH的概念有多火?

  其實很多初學者混淆了一個概念,SSH實際上指的是Struts1.x+Spring+Hibernate。這個概念已經有十幾年的歷史了。在Struts1.x時代,它是當之無愧的霸主,但是在新的MVC框架湧現的時代,形式已經不是這樣了,Struts2.x藉助了Struts1.x的好名聲,讓國內開發人員認為Struts2.x是霸主繼任者(其實兩者在技術上無任何關係),導致國內程序員大多數學習基於Struts2.x的框架,又一個貌似很多的概念出來了S2SH(Struts2+Spring+Hibernate)整合開發。

 SpringMVC如何處理請求?

   SpringMVC是基於MVC設計模型的,MVC模式指的就是Model(業務模型)、View(視圖)、Controller(控制器)。SpringMVC處理請求就是通過MVC這三個角色來實現的。

注:不要把MVC設計模式和工程的三層架構混淆,三層結構指的是表現層、業務層、數據持久層。而MVC只針對表現層進行設計。

  下面讓我們看看處理流程吧


 第一個MVC程序

達到效果

  1. 學會如果配置前端控制器
  2. 如何開發處理器

任務需求

  訪問/queryItem,返回商品列表頁面,商品數據暫時使用靜態數據(不從數據庫查詢並返回)。

 實現

pom.xml

<project xmlns="http://maven.apache.org/POM/4.0.0"
    xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
    xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <groupId>com.cyb</groupId>
    <artifactId>springmvc-demo01</artifactId>
    <version>0.0.1-SNAPSHOT</version>
    <packaging>war</packaging>
    <dependencies>
        <!-- spring ioc組件需要的依賴包 -->
        <dependency>
            <groupId>org.springframework</groupId>
            <artifactId>spring-beans</artifactId>
            <version>5.2.1.RELEASE</version>
        </dependency>
        <dependency>
            <groupId>org.springframework</groupId>
            <artifactId>spring-core</artifactId>
            <version>5.2.1.RELEASE</version>
        </dependency>
        <dependency>
            <groupId>org.springframework</groupId>
            <artifactId>spring-context</artifactId>
            <version>5.2.1.RELEASE</version>
        </dependency>
        <dependency>
            <groupId>org.springframework</groupId>
            <artifactId>spring-expression</artifactId>
            <version>5.2.1.RELEASE</version>
        </dependency>

        <!-- 基於AspectJ的aop依賴 -->
        <dependency>
            <groupId>org.springframework</groupId>
            <artifactId>spring-aspects</artifactId>
            <version>5.2.1.RELEASE</version>
        </dependency>
        <dependency>
            <groupId>aopalliance</groupId>
            <artifactId>aopalliance</artifactId>
            <version>1.0</version>
        </dependency>

        <!-- spring MVC依賴包 -->
        <dependency>
            <groupId>org.springframework</groupId>
            <artifactId>spring-webmvc</artifactId>
            <version>5.2.1.RELEASE</version>
        </dependency>
        <dependency>
            <groupId>org.springframework</groupId>
            <artifactId>spring-web</artifactId>
            <version>5.2.1.RELEASE</version>
        </dependency>

        <!-- jstl -->
        <dependency>
            <groupId>javax.servlet</groupId>
            <artifactId>jstl</artifactId>
            <version>1.2</version>
        </dependency>
        
        <!-- servlet -->
        <dependency>
            <groupId>javax.servlet</groupId>
            <artifactId>servlet-api</artifactId>
            <version>2.5</version>
            <scope>provided</scope>
        </dependency>
    </dependencies>
    <build>
        <plugins>
            <!-- 配置Maven的JDK編譯級別 -->
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <version>3.2</version>
                <configuration>
                    <source>1.8</source>
                    <target>1.8</target>
                    <encoding>UTF-8</encoding>
                </configuration>
            </plugin>
            <plugin>
                <groupId>org.apache.tomcat.maven</groupId>
                <artifactId>tomcat7-maven-plugin</artifactId>
                <version>2.2</version>
                <configuration>
                    <port>8080</port>
                </configuration>
            </plugin>
            <!-- tomcat依賴包 -->
            <plugin>
                <groupId>org.apache.tomcat.maven</groupId>
                <artifactId>tomcat7-maven-plugin</artifactId>
                <version>2.2</version>
            </plugin>
        </plugins>
    </build>
</project>

注:

1、依賴添加完之後,項目上右鍵->maven->Update Maven Project

2、項目上右鍵->Java EE Tools->Generate Deployment Descriptor Stub

 web.xml

路徑:src/main/webapp/WEB-INF/web.xml

<?xml version="1.0" encoding="UTF-8"?>
<web-app xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
    xmlns="http://java.sun.com/xml/ns/javaee"
    xsi:schemaLocation="http://java.sun.com/xml/ns/javaee http://java.sun.com/xml/ns/javaee/web-app_2_5.xsd"
    version="2.5">
    <!-- 學習前置條件 -->
    <!-- 問題1:web.xml中servelet、filter、listener、context-param加載順序 -->
    <!-- 問題2:load-on-startup標籤的作用,影響了Servlet對象創建的時機 -->
    <!-- 問題3:url-pattern:標籤的配置方式有四種:/dispatcherServlet、/servlet/*、*.do、/ 以上四種配置-->
    <!-- 問題4:url-pattern標籤的配置為什麼配置/就不攔截jsp請求,而配置/*,就會攔截jsp請求 -->
    <!-- 問題4原因:標籤配置為/*報錯,因為它攔截了jsp請求,但是又不能處理jsp請求。 -->
    <!-- 問題5:配置了springmvc去讀取spring配置文件之後,就產生了spring父子容器的問題 -->
    
    <!-- 配置前端控制器 -->
    <servlet>
        <servlet-name>springmvc</servlet-name>
        <servlet-class>org.springframework.web.servlet.DispatcherServlet</servlet-class>
        <!-- 設置spring配置文件路徑 -->
        <!-- 如果不設置初始化參數,那麼DispatcherServlet會讀取默認路徑下的配置文件 -->
        <!-- 默認配置文件路徑:/WEB-INF/springmvc-servlet.xml -->
        <init-param>
            <param-name>contextConfigLocation</param-name>
            <param-value>classpath:springmvc.xml</param-value>
        </init-param>
        <!-- 指定初始化時機,設置為2,表示Tomcat啟動時,它會跟隨着啟動,DispatcherServlet會跟隨着初始化 -->
        <!-- 如果沒有指定初始化時機,DispatcherServlet就會在第一次被請求的時候,才會初始化,而且只會被初始化一次(單例模式) -->
        <load-on-startup>2</load-on-startup>
    </servlet>
    <servlet-mapping>
        <servlet-name>springmvc</servlet-name>
        <!-- url-pattern的設置 -->
        <!-- 不要配置為/*,否則報錯 -->
        <!-- 通俗解釋:會攔截整個項目中的資源訪問,包含JSP和靜態資源的訪問,對於JS的訪問,springmvc提供了默認Handler處理器 -->
        <!-- 但是對於JSP來講,springmvc沒有提供默認的處理器,我們也沒有手動編寫對應的處理器,此時按照springmvc的處理流程分析得知,它down了 -->
        <url-pattern>/</url-pattern>
    </servlet-mapping>
</web-app>

springmvc.xml

路徑:src/main/resources/springmvc.xml

<?xml version="1.0" encoding="UTF-8"?>
<beans xmlns="http://www.springframework.org/schema/beans"
    xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
    xmlns:aop="http://www.springframework.org/schema/aop"
    xmlns:mvc="http://www.springframework.org/schema/mvc"
    xmlns:tx="http://www.springframework.org/schema/tx"
    xmlns:context="http://www.springframework.org/schema/context"
    xsi:schemaLocation="http://www.springframework.org/schema/beans
        http://www.springframework.org/schema/beans/spring-beans.xsd
        http://www.springframework.org/schema/context
        http://www.springframework.org/schema/context/spring-context.xsd
        http://www.springframework.org/schema/tx
        http://www.springframework.org/schema/tx/spring-tx.xsd
        http://www.springframework.org/schema/mvc
        http://www.springframework.org/schema/mvc/spring-mvc.xsd
        http://www.springframework.org/schema/aop
        http://www.springframework.org/schema/aop/spring-aop.xsd">
    <!-- 處理器類的掃描 -->
    <context:component-scan
        base-package="com.cyb.springmvc.controller"></context:component-scan>
    <!-- 註解映射器 @Controller和@RequestMapping組合這種方式的註解映射的解析 -->
    <!-- <bean class="org.springframework.web.servlet.mvc.method.annotation.RequestMappingHandlerMapping"></bean> -->
    <!-- 註解適配器 -->
    <!-- <bean class="org.springframework.web.servlet.mvc.method.annotation.RequestMappingHandlerAdapter"></bean> -->
    <!-- 配置註釋的適配器和映射器,同時還注入其他很多的bean -->
    <!-- <mvc:annotation-driven></mvc:annotation-driven> -->
    <!-- 显示配置視圖解析器 -->
    <bean
        class="org.springframework.web.servlet.view.InternalResourceViewResolver">
        <property name="prefix" value="/WEB-INF/jsp/"></property>
        <property name="suffix" value=".jsp"></property>
    </bean>
</beans>

ItemController.java

路徑:/src/main/java/com/cyb/springmvc/controller/ItemController.java

package com.cyb.springmvc.controller;

import java.util.ArrayList;
import java.util.List;

import org.springframework.stereotype.Controller;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.servlet.ModelAndView;

import com.cyb.springmvc.po.item;

/**
 * 處理器的開發方式有多種,比如實現HttpRequestHandler接口、Controller接口的方式、還有註解的方式 企業中使用的一般都是註解的方式
 * 註解的注意事項
 *  1、類上加上@Controller註解(必須是Controller,可以通過源碼找到答案)
 *  2、類上或者方法上面要加上@RequestMapping(必須)
 * 
 * @author apple
 *
 */
@Controller
public class ItemController {
    //@RequestMapping此時填寫的是url
    //ModelAndView:Model標識的是數據類型,View就是最終要展示給用戶的視圖
    @RequestMapping("queryItem")
    public ModelAndView queryItem() {
        //用靜態數據模型
        List<item> itemList=new ArrayList<item>();
        
        item item_1=new item();
        item_1.setName("蘋果手機");
        item_1.setPrice(5000);
        item_1.setDetail("iphoneX蘋果手機!");
        itemList.add(item_1);
        
        item item_2=new item();
        item_2.setName("華為手機");
        item_2.setPrice(6000);
        item_2.setDetail("華為5G網速就是快!");
        itemList.add(item_2);
        ModelAndView mvAndView=new ModelAndView();
        //設置數據模型,相當於request的setAttribute方法,實質上,底層確實也是轉成了request()
        //先將k/v數據放入map中,最終根據視圖對象不同,再進行後續處理
        mvAndView.addObject("itemList",itemList);
        //設置view視圖
        mvAndView.setViewName("/WEB-INF/jsp/item/item-list.jsp");
        return mvAndView;
    }
}

item.java

路徑:src/main/java/com/cyb/springmvc/po/item.java

package com.cyb.springmvc.po;

public class item {
    private String name;
    private double price;
    private String detail;

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public double getPrice() {
        return price;
    }

    public void setPrice(double price) {
        this.price = price;
    }

    public String getDetail() {
        return detail;
    }

    public void setDetail(String detail) {
        this.detail = detail;
    }
}

item-list.jsp

 路徑:src/webapp/WEB-INF/jsp/item/item-list.jsp

<%@ page language="java" contentType="text/html; charset=UTF-8"
    pageEncoding="UTF-8"%>
<%@ taglib uri="http://java.sun.com/jsp/jstl/core" prefix="c"%>
<%@ taglib uri="http://java.sun.com/jsp/jstl/fmt" prefix="fmt"%>
<!DOCTYPE html PUBLIC "-//W3C//DTD HTML 4.01 Transitional//EN" "http://www.w3.org/TR/html4/loose.dtd">
<html>
<head>
<meta http-equiv="Content-Type" content="text/html; charset=UTF-8">
<title>查詢商品列表</title>
</head>
<body>
    <form action="${pageContext.request.contextPath }/itemList.do"
        method="post">
        查詢條件:
        <table width="100%" border=1>
            <tr>
                <td><input type="submit" value="查詢" /></td>
            </tr>
        </table>
        商品列表:
        <table width="100%" border=1>
            <tr>
                <td>商品名稱</td>
                <td>商品價格</td>
                <td>商品描述</td>
                <td>操作</td>
            </tr>
            <c:forEach items="${itemList }" var="item">
                <tr>
                    <td>${item.name }</td>
                    <td>${item.price }</td>
                    <td>${item.detail }</td>
                    <td><a
                        href="${pageContext.request.contextPath }/itemEdit.do?id=${item.name}">修改</a></td>
                </tr>
            </c:forEach>

        </table>
    </form>
</body>

</html>

 項目結構圖

 運行

 完整項目

 SpringMVC 框架源碼分析

 框架結構

 程序入口

一、初始化Servlet

二、處理器映射,渲染頁面

 注:標記的方法體,跟蹤進去讀源碼就好啦!~~

默認配置文件


# Default implementation classes for DispatcherServlet's strategy interfaces.
# Used as fallback when no matching beans are found in the DispatcherServlet context.
# Not meant to be customized by application developers.

org.springframework.web.servlet.LocaleResolver=org.springframework.web.servlet.i18n.AcceptHeaderLocaleResolver

org.springframework.web.servlet.ThemeResolver=org.springframework.web.servlet.theme.FixedThemeResolver

org.springframework.web.servlet.HandlerMapping=org.springframework.web.servlet.handler.BeanNameUrlHandlerMapping,\
    org.springframework.web.servlet.mvc.method.annotation.RequestMappingHandlerMapping,\
    org.springframework.web.servlet.function.support.RouterFunctionMapping

org.springframework.web.servlet.HandlerAdapter=org.springframework.web.servlet.mvc.HttpRequestHandlerAdapter,\
    org.springframework.web.servlet.mvc.SimpleControllerHandlerAdapter,\
    org.springframework.web.servlet.mvc.method.annotation.RequestMappingHandlerAdapter,\
    org.springframework.web.servlet.function.support.HandlerFunctionAdapter


org.springframework.web.servlet.HandlerExceptionResolver=org.springframework.web.servlet.mvc.method.annotation.ExceptionHandlerExceptionResolver,\
    org.springframework.web.servlet.mvc.annotation.ResponseStatusExceptionResolver,\
    org.springframework.web.servlet.mvc.support.DefaultHandlerExceptionResolver

org.springframework.web.servlet.RequestToViewNameTranslator=org.springframework.web.servlet.view.DefaultRequestToViewNameTranslator

org.springframework.web.servlet.ViewResolver=org.springframework.web.servlet.view.InternalResourceViewResolver

org.springframework.web.servlet.FlashMapManager=org.springframework.web.servlet.support.SessionFlashMapManager


架構流程

  1. 用戶發送請求至前端控制器DispatcherServlet
  2. DispatcherServlet收到請求調用HandlerMapping處理器映射器
  3. 處理器映射器根據請求url找到具體的處理器,生成處理器對象及處理器攔截器(如果有則生成)一併返回給DispatcherServlet
  4. DispatcherServlet通過HandlerAdapter處理器適配器調用處理器
  5. HandlerAdapter執行處理器(handler,也叫後端控制器)
  6. Controller執行完成返回ModelAndView
  7. HandlerAdapter將handler執行結果ModelAndView返回給DispatcherServlet
  8. DispatcherServlet將ModelAndView傳給ViewReslover視圖解析器
  9. ViewReslover解析后返回具體View對象
  10. DispatcherServlet對View進行渲染視圖(即將模型數據填充至視圖種)
  11. DispatcherServlet響應用戶

 組件說明

 DispatcherServlet:前端控制器

   用戶請求到達前端控制器,它就相當於mvc模式中的C,DispatcherServlet是整個流程控制的中心,由它調用其他組件處理用戶的請求,DispatcherServlet的存在降低了組件之間的耦合性。

HandlerMapping:處理器映射器

   HandlerMapping負責根據用戶請求找到Handler即處理器,springmvc提供了不同的映射器實現不同的映射方式,例如:配置文件方式,實現接口方式,註解方式等。

Handler:處理器

  Handler是繼DispatcherServlet前端控制器的後端控制器,在DispatcherServlet的控制下,Handler對具體的用戶請求進行處理。

  由於Handler涉及到具體的用戶業務請求,所以一般情況需要程序員根據業務需求開發Handler。

HandlerAdapter:處理器適配器

  通過HandlerAdapter對處理器進行執行,這是適配器模式的應用,通過擴展適配器可以對更多類型的處理器進行執行。

 View Resolver:視圖解析器

  View Resolver負責將處理結果生成View視圖,View Resolver首先根據邏輯視圖名解析成物理視圖名即具體的頁面地址,再生成View視圖對象,最後對View進行渲染將處理結果通過頁面展示給用戶。

View:視圖

  springmvc框架提供了很多View視圖類型的支持,包括:jstlView、freemarkerView、pdfView等。我們最常用的視圖就是jsp。

  一般情況下需要通過頁面標籤或頁面模板技術將模型數據通過頁面展示給用戶,需要由程序員根據業務需求開發具體的頁面。

說明

  再springmvc的各個組件中,處理器映射器、處理器適配器、視圖解析器稱為springmvc的三大組件。需要用戶開發的組件有:處理器、視圖

三大組件配置(註解方式)

註解映射器和適配器

通過bean標籤配置

RequestMappingHandlerMapping:註解式處理器映射器

  對類中標記@ResquestMapping的方式進行映射,根據ResquestMapping定義的url匹配ResquestMapping標記的方法,匹配成功返回HandlerMethod對象給前端控制器,HandlerMethod對象中封裝url對應的方法Method。

配置如下:

<!--註解映射器 -->
<bean class="org.springframework.web.servlet.mvc.method.annotation.RequestMappingHandlerMapping"/>
<!--註解適配器 -->
<bean class="org.springframework.web.servlet.mvc.method.annotation.RequestMappingHandlerAdapter"/>

通過mvc標籤配置(推薦)

<mvc:annotation-drivern />

  mvc:annotation-drivern標籤的作用,詳見AnnotationDrivenBeanDefinitionParser類的parse方法。分析源碼可知:mvc:annotation-drivern往spring容器中註冊以下的一些BeanDefinition

  • ContentNegotiationManagerFactoryBean
  • RequestMappingHandlerMapping
  • ConfigurableWebBindingInitializer
  • RequestMappingHandlerAdapter
  • CompositeUriComponentsContributorFactoryBean
  • ConversionServiceExposingInterceptor
  • MappedInterceptor
  • ExceptionHandlerExceptionResolver
  • ResponseStatusExceptionResolver
  • DefaultHandlerExceptionResolver
  • BeanNameUrlHandlerMapping
  • HttpRequestHandlerAdapter
  • SimpleControllerHandlerAdapter
  • HandlerMappingIntrospector

視圖解析器

再springmvc.xml文件配置如下:

<bean class="org.springframework.web.servlet.view.InternalResourceViewResolver">
            <!-- 該視圖解析器,默認的視圖類就是JstlView,可以不寫 -->
        <property name="viewClass"
            value="org.springframework.web.servlet.view.JstlView" />
        <property name="prefix" value="/WEB-INF/jsp/" />
        <property name="suffix" value=".jsp" />
    </bean>
  • InternalResourceViewResolver:默認支持JSP視圖解析
  •  viewClass:JstlView表示JSP模板頁面需要使用JSTL標籤庫,所以classpath中必須包含jstl的相關jar 包。此屬性可以不設置,默認為JstlView。
  • prefix 和suffix:查找視圖頁面的前綴和後綴,最終視圖的址為:前綴+邏輯視圖名+後綴,邏輯視圖名需要在controller中返回的ModelAndView指定,比如邏輯視圖名為hello,則最終返回的jsp視圖地址 “WEB-INF/jsp/hello.jsp”


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!