新加坡贈比亞迪100張電動計程車牌照 打造智慧交通

近日,新加坡政府向比亞迪頒發100個電動計程車牌照,意味著比亞迪正式成為有史以來進入新加坡計程車市場的第一家中國企業。  
  據悉,此次頒發的100個計程車牌照將用於e6純電動車。宏達同新加坡計程車私人有限公司將負責這100台e6計程車的日常運營和管理,首批車輛預計在今年9月上路運營,100台計程車計畫于明年一季度前全部投入服務。屆時,比亞迪將與其新加坡合作夥伴對這支e6車隊進行即時資料採集、分析和處理,聯合研發自動駕駛電動汽車技術和智慧交通管理系統,以支援新加坡政府打造智慧交通。   目前,比亞迪在新加坡的車型由最初的e6逐步擴展到電動巴士、叉車和電動商用車等多種車型,並與GrabCar等交通出行領軍企業展開合作。今年5月30日,比亞迪還攜手SMART集團在新加坡開啟了全球首家純電動車體驗中心,並簽署在新加坡聯合推廣1,000輛e6的合作諒解備忘錄。   文章來源:環球網

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
電動車供應鏈需求強,台達電、貿聯-KY忙翻

美國電動車廠商特斯拉(Tesla)、德國BMW接連提高電動車零組件的訂單,使中上游供應鏈廠商忙著接單。台灣台達電、貿聯-KY等特斯拉供貨廠商表示接單狀況良好,而台達電也透露可望與BMW達成供貨合約。

《經濟日報》報導,各國積極發展電動車,帶動了電動車產業鏈的興盛。台達電已通過歐、美、日、中等地的電動車認證標準,目前已有歐美合作廠商,未來在電動車業界的發展可期。由於台達電將於第三季起出貨北美油電混和車所需的零組件,因此台達電第三季的獲利十分看好。

在與特斯拉的合作方面,台達電一直都是Model S、Model X的電力控制系統、電池管理系統的供應商。針對特斯拉所提高的訂單需求,據了解,特斯拉已要求台達電備妥目前三至五倍的產能。另一家台系上游廠商貿聯-KY也接訂單忙翻天。

而在與BMW的合作方面,BMW將在泰國投資20億泰銖興建電動車用電池工廠,最快在2017年中動工。報導指出,台達電已與BMW達成共識,未來將為BMW供應電源控制系統,主要市場為東協。

台達電董事長海英俊曾於法說會上表示,汽車產業對台達電而言十分重要,也看好未來汽車相關應用的發展。

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

車用電池市場變化,傳日產將出售電池事業

日經新聞5日報導,日產汽車(Nissan)將退出車用電池事業,計畫出售和NEC共同設立的合資子公司「Automotive Energy Supply(以下簡稱AES)」,且除了日本電池廠之外、日產已和多家中國廠商展開出售協商;另外,除了AES之外,日產也計畫出售在美國及英國單獨營運的電池生產事業,且據悉多家中國廠商已表達有意收購的意願。預估日產在評估出售額、員工雇用等條件之後,會在今年內敲定出售對象。

報導指出,AES為日產、NEC分別出資51%、49%於2007年設立的公司,主要生產日產電動車Leaf或油電混合車(HV)所需的鋰離子電池,於車用鋰離子電池市場的市佔率僅次於Panasonic位居第2位,2015年度營收為366億日圓,不過因日產研判比起自家生產、向外部電池廠商採購電池較能進一步調降車輛價格,故決定出售ASE持股。

每日新聞5日報導,日產汽車計畫出售ASE持股,且已和Panasonic以及南韓LG化學(LG Chem)等海外廠商展開協商,而據關係人士透露,出售額預估將達數百億日圓。

日經新聞於6日追加報導指出,隨著日產有意退出車用電池事業,NEC也考慮跟進出售ASE持股,而ASE為全球第2大車用鋰離子電池廠,故日產/NEC出售ASE的舉動恐將對全球車用鋰離子電池的勢力版圖帶來巨大變動。

日經指出,供應鋰離子電池給特斯拉(Tesla)的Panasonic目前正面臨中國廠商的猛烈追趕、導致市佔萎縮,根據調查公司Techno Systems Research指出,2014年Panasonic車用鋰離子電池全球市佔率高達47%,而2015年雖維持首位、但市佔率萎縮至34%;反觀「其他廠商」市佔率從14%飆增至33%,而在「其他廠商」中、比亞迪(BYD)等中國廠商佔了大多數。

另外,LG化學、三星SDI等南韓廠商也在後猛追,且日本村田製作所也收購Sony鋰離子電池事業、今後可能將進軍車用市場,故未來日中韓於車用電池市場的競爭料將更趨激烈。

Sony 7月28日宣布,已和村田製作所締結意向確認書,計畫將電池事業出售給村田,雙方預計在2016年10月中旬簽訂具法律約束力的最終契約,且在獲得相關當局同意之後,目標在2017年3月底完成出售手續。

(本文內容由授權提供)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

賓士將推出四款電動車與特斯拉競爭

今年7月,有梅賽德斯•賓士內部員工透露,該公司將於九月份發佈一款概念版的電動車與特斯拉競爭。而今天看來,梅賽德斯•賓士的計畫遠不止這些。  
  根據外媒最新消息,梅賽德斯•賓士不會僅僅局限於一兩款產品,賓士計畫推出四款電動汽車產品,希望能夠與特斯拉、寶馬等對手進行正面競爭,同時這四款電動汽車將會採用全新的命名方式。   根據梅賽德斯•賓士執行董事長Dieter Zetsche表示,第一款電動汽車將會在今年10月的巴黎車展上亮相,同時另外還有三款其它類型的產品,一共包括了兩款電動轎車和兩款電動SUV,並且預計在2020年之前陸續上市。而在今年的巴黎車展上我們將看到一款SUV產品,並且續航里程將會達到讓人印象深刻的500公里。而這輛賓士的電動SUV除了擁有強悍的續航里程之外,還將與特斯拉的Model X直接競爭。   文章來源:雷鋒網

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

特斯拉新款電動汽車比Model 3便宜1萬美金

今年4月1日,特斯拉正式發佈旗下第四款純電動汽車——Model 3,此舉引爆了全球的電動汽車愛好者。不過,特斯拉似乎並沒打算將Model 3設定為自己的“國民車”,據悉,其未來的生產規劃中還有一款更“國民化”的車型。  
  有知情人士透露,特斯拉的“國民車”是一款A級車,售價將比Model 3還低1萬美元,僅2.5萬美元,約合人民幣16.65萬元。不過雖然價格有所下降,但因電池技術不斷提高,成本不斷下降,該款車型的續航里程將仍在300km以上。   該人士還介紹,此款“國民車”應該在2018年左右向全球公佈,2020年交付。屆時,特斯拉將在中國完成國產化,所以中國消費者未來購買該款車型可享受與美國相同的售價。   文章來源:EV世紀

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

2020即將到來,看完這篇幫你詳細了解數據策略


隨着企業與数字科技融合程度的逐漸加深,越來越多的企業在数字化轉型之路上感到前所未有的焦慮。他們相信組織已經擁有了具有經濟價值的數據資源,期望它能像其他資產那樣為組織帶來更多的未來利益。

諸如員工資產,與數據一樣,員工也是企業資產的重要組成部分。只不過相較於數據資產管理在國內企業中仍然處於早期階段。大部分企業在員工的選育用留上已經形成了一套標準化流程和相對成熟的管理策略。基於此,我們是不是應該考慮像管理員工資產那樣,以相同的方式處理數據呢?這時,數據策略顯得尤為重要。


一、數據策略的定義


數據策略是用於獲取、集成、存儲、保護、管理、監控、分析、使用和操作數據的方法。現代而全面的數據策略所涉及的不僅僅是數據,它是定義人員、流程和技術的路線圖,闡明了數據將如何實現和激發業務策略。


具體包括:闡明目標願景和實現該願景的實用指南,明確闡述成功標準和關鍵績效指標,這些指標可用於評估和合理化所有後續數據計劃。而不包含針對特定技術問題的詳細解決方案。隨着企業目標的發展,數據戰略並非一成不變,需要緊跟企業的技術創新和運作方式。


二、為什麼企業要建立數據策略


鑒於前面闡述的背景,數據策略與員工的選育用留策略一樣,都是為了更科學地管理企業資產。如果沒有策略,組織將被動應對各業務部門提出的數據要求。從前台業務、市場,到中後台的財務、供應鏈、人力資源,都會向一個部門提需求,可能涉及到某種數據分析、主數據管理、商業智能、數據治理、數據質量計劃等。


導致數據部門每天對外要理解業務數據需求的內涵,竭力排期滿足,對內要運維所使用的陳舊工具和系統,保證其正常運行,每天不堪重負。一旦出現數據質量、元數據等問題,就會被挑戰得體無完膚,甚至會升級到能力和信任的高度。更為關鍵的是,如果無法及時正確地支持這些計劃,很容易導致企業做出錯誤的商業決策。


三、誰來制定、推動數據策略


請不要將企業範圍的數據策略僅僅交給首席信息官(CIO),為什麼?數據不僅僅是IT資產,而是一種企業資產,數據策略在一定程度上是一種企業戰略。

DataPipeline認為,CEO和董事會需要深刻理解快速將數據戰略落地的意義和風險,並着手構建下述組織架構,鼓勵相應的文化和創新。


CEO相較於其他企業角色,既要關注生存,也要關注發展,而數據很難做到立竿見影,所以平衡短期收益與長期發展考驗的是CEO的智慧。如果CEO在公布決策時都是引用數據,並對企業內部的數據創新非常熟悉,那麼數據策略已經成功了一半,否則其他人的努力有極大概率會付諸東流。


CDO由CEO領導,直接負責公司組織內部數據發展策略落地的詳細路徑和整體節奏,根據業務模式確定合規要求、需求滿足的價值、速度、流程、以及自動化、智能化技術路線的選擇。這裏一定要注意滿足業務需求的速度和質量,由於數據需求的挑戰較大,太多CDO無法在一定時間,一定業務範圍內快速達成CEO、董事會、業務部門希望看到的效果。沒有一個好的起點,首席數據官的工作就會喪失前進的節奏,陷於和業務部門就數據的上收、使用等流程長期討論和拉鋸的泥潭中,造成惡性循環,使這個崗位變成高危職位。據DataPipeline觀察,很多企業開始設立CDO的崗位,並嘗試通過數據帶來業務增長,客觀來說,這和其他高管職位一樣,是一個機遇與挑戰並存的情況。


數據合規與標準委員會由CEO領導,並由公司的業務線領導、法務領導、首席數據官組成,詳細制定出數據使用的邊界、自由度和數據質量標準。負責隨着業務的發展保持最高頻率(一般是一周一次)的討論更新,同時使用自動化的工具將規則同步至數據系統中。如果業務的變化無法從合規層面保持一致,就會逐步成為限制數據使用的瓶頸。這裏的挑戰在於不讓規則討論過於大而全,要儘快在一定範圍內達成共識,逐步推動部分範圍內規則地快速落地,否則會使願景的落地失去前進節奏。


數據部門由首席數據官領導,包括數據工程師,分析師和數據科學家。數據工程師負責使用符合時代挑戰的自研或者商業的工具,確保業務用戶可以自助式地完成數據全生命周期的使用和管理。同時負責企業內外的數據源能自動高效地集成融合,快速滿足業務取數、用數需求,另外通過保證元數據、主數據、數據血緣與業務發展時刻保持一致,讓業務準確無誤地理解數據語義。

他們不僅要確保大數據平台的負載均衡、穩定性,可以隨時響應業務對數據模型的計算和查詢需求。還要遵循標準委員制定的標準,通過手工制定規則和各種算法確保數據質量並盡可能做到前置預警。最後,也是非常重要的一點,在應對業務部門的需求時,需要有一套“定價體系”。因為數據支持業務的發展探索是存在成本的,但目前業務部門對此並無感知,更核算不出ROI。在成本面前,很容易篩選出真需求,排出優先級,並且在後續服務中理清ROI。這條路舉步維艱,但又勢在必行,否則數據部門的業務價值困境始終會存在。 有時數據部門在沒有設立首席數據官的情況下也由CIO領導,這時有一個職責劃分藝術,每個企業的情況都不同,但CDO的重點職責是在合適的企業內帶領數據組用數據快速產生業務價值。CIO的職責範圍更廣,但專精的領域不在該點上。


業務部門中應當擁有能深入理解業務的分析師和科學家,自助使用數據部門提供的工具,這時使用門檻會不斷降低,取數用數的難度和周期也會大幅下降,技能的要求一般是SQL級別。因此業務部門需要更加理解數據,並構思數據可以應用到自身業務發展的角度,再通過管理數據使用的全生命周期,在實踐中不斷總結。挑戰在於如何能快速用數據高效地帶來業務價值,通過解耦來擺脫髮展受到數據部門效率制約的現狀。


四、數據策略中的數據融合策略


1. 為什麼要制定數據融合策略

企業希望在未來以數據支持數據應用和數據業務,但前提是能夠隨時隨心快速提取使用數據。在此過程中存在一些壁壘,諸如技術、組織、文化等。如果沒有提前思考這些難點,在後續朝目標努力時,會遇到很大的阻力,甚至有可能讓項目流產。

2. 制定數據融合策略時需要思考回答哪些問題

在搞清楚為什麼制定數據融合策略之後,接下來我們將從以下幾方面展開:

Who:組織中,誰將參与數據融合?是否有具備編程知識的IT專家解決所有數據融合任務?還是需要使業務部門的員工能夠自己使用數據融合工具?一旦實施,潛在的技術風險和實施周期是什麼?這些問題將對您選擇購買的數據融合解決方案的類型產生重大影響。

What:哪些數據可能需要集成?在DataPipeline看來,我們反對大而全,支持企業按需制定非常靈活的數據融合策略。企業需要反向從業務角度去思考,從全局角度梳理清楚在未來一到三年或更長期的時間內,有哪些業務目標希望通過數據去驅動,這些數據包括哪些數據,這些數據都存在於哪裡,避免重複建設。

如果只存在幾個數據孤島,對企業來說,最具成本效益的策略可能是選擇可以滿足特定需求的基本數據交換或ETL工具。但是,如果需要集成許多不同的孤島(或者不同類型的數據),那麼最好使用功能更為全面的數據融合平台。

When:何時進行數據融合?企業一旦制定了數據策略,接下來數據融合策略將會被擺在一個非常高的位置上。因為,如果不做數據融合,其餘事情將會舉步維艱,但從時間上要做通盤考慮,進行一個頂層設計,然後再按階段逐步進行。

如果要創建數據倉庫,則數據融合可能會在分析之前進行。如果要創建基於Hadoop或類似技術的數據湖,以原始未更改的形式存儲數據,則將在運行分析工作負載之前進行一些數據融合。目前許多企業都有數據倉庫和數據湖,選擇何種體繫結構將影響數據融合所需的技術類型。

Where:數據融合將在哪裡進行?雲和本地並不是一個矛盾,因為現在有許多公司既有本地的IDC(數據中心),又有雲上,甚至是多雲的架構。企業需要選擇一種能夠支持本地部署、雲上部署、Docker,在容器大的平台上多管齊下的數據融合工具。另外,該工具的現代化和智能化程度還應該適應企業當中非常複雜多變的環境。

How:如何進行數據融合?這個問題最為複雜,因為它涉及到工具、文化和流程。關於員工,作為企業和組織的戰略性資源,我們並非要將每個人都訓練成高水平、有經驗、訓練有素的數據工程師。而應注重培養其數據意識,知道如何使用數據,如何去發揮數據的價值。

同時企業應該採取靈活易用、穩定的數據融合工具。面對再厲害的人才,如果沒有匹配相應的工具和方法論,在工作中也很難游刃有餘。未來企業需要多思考何種工具,何種平台,何種工作方式能讓組織儘快釋放數據效能。


3. 選擇數據融合平台需要做哪些考量

公司需要結合自身的發展階段、信息化建設水平以及人員的素養等情況,來選擇自己的解決方案。

如果研發人員較多,可選擇的範圍相對會比較廣泛。面對開源和商業的數據融合工具,您需要根據企業的需求和對生產的要求進行選擇。開源是很好的方式,可以先從這裏嘗試做起,但是對於業務的連續性要求和有些生產級別的要求,可能就需要商業工具。

另外,關於一些技術考量點,可以看這篇文章:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

一、從零開始搭建自己的靜態博客 — 基礎篇

目錄

前幾天心血來潮,想要在GitHub Pages上搭建一個靜態博客;之前,我也曾基於Django開發過自己的博客,並買了雲主機部署,但是訪問量感人,慢慢自己也不打理了,就把雲主機退訂了(去吃噸好的~~~);

雖然搭建靜態博客很簡單,但是也想記錄一下,如果恰好能對你有所幫助或啟發,那我也覺的很開心了。

搭建靜態博客的工具多種多樣,即有流行的,也有GitHub Pages官方推薦的;其實,選用哪種工具不重要,關鍵是一步步的理解它,遇到問題、解決問題的思路和過程;

因為我本人對Python比較熟悉,所以我選用基於Python開發的,它基本滿足我的需求:

  • 支持markdown的格式;
  • 提供自動化構建;
  • 足夠的主題庫和插件庫,並且支持定製化;
  • …

本文主要涉及pelican的基本使用方法,最終在本地搭建一個簡陋的博客網站;

1. 準備環境

選定工作目錄,並使用創建一個虛擬環境:

λ mkdir pelican-blog
λ cd pelican-blog

# 創建基於 Python 3 的虛擬環境 
λ pipenv install --three

# 查看虛擬環境中的 Python 版本
λ pipenv run python --version
Python 3.7.3

在虛擬環境中安裝必要的包:

λ pipenv install Markdown pelican

# 查看包之間的依賴關係
λ pipenv graph
Markdown==3.1.1
  - setuptools [required: >=36, installed: 41.6.0]
pelican==4.2.0
  - blinker [required: Any, installed: 1.4]
  - docutils [required: Any, installed: 0.15.2]
  - feedgenerator [required: >=1.9, installed: 1.9]
    - pytz [required: >=0a, installed: 2019.3]
    - six [required: Any, installed: 1.13.0]
  - jinja2 [required: >=2.7, installed: 2.10.3]
    - MarkupSafe [required: >=0.23, installed: 1.1.1]
  - pygments [required: Any, installed: 2.4.2]
  - python-dateutil [required: Any, installed: 2.8.1]
    - six [required: >=1.5, installed: 1.13.0]
  - pytz [required: >=0a, installed: 2019.3]
  - six [required: >=1.4, installed: 1.13.0]
  - unidecode [required: Any, installed: 1.1.1]

2. 新建項目

pelican提供了一個命令行工具:pelican-quickstart,能夠讓我們快速地新建一個網站項目;

它在執行的過程中,會交互式的詢問一些配置項,如果你現在還不能確定的話,那就大膽的使用默認值吧,後面還可以在配置文件中修改;

命令執行完成后,它會在我們的項目中新建如下的目錄和文件:

.
├── content         # 目錄,存放原始博文和相關靜態文件
├── output          # 目錄,存放構建后的網站源碼
├── Makefile        
├── pelicanconf.py  # 構建相關的配置文件
├── publishconf.py  # 發布相關的配置文件
└── tasks.py

其中,content/目錄存放所有的markdown格式的文本,我們還可以再新建一個content/images/的子目錄,用於存放所有的圖片;

注意:

在自動構建的過程中,content/images/中的文件會被無損地拷貝到output/images/中,通過修改pelicanconf.py文件中STATIC_PATHS的配置項(默認值為['images'])可以改變這種行為;

3. 第一篇博文

現在我們在content/目錄下添加第一篇markdown格式的文章,就以本文為例;

pelican可以很“聰明”地從文章的元數據中提取需要的信息,所以我們以特定的格式編寫文章的開頭:

Title: 一、從零開始搭建自己的靜態博客 -- 基礎篇
Date: 2019-11-21 14:37
Modified: 2019-11-22 11:09
Category: 工具
Tags: pelican
Author: luizyao
Slug: pelican-blog-chapter-1
Summary: 本文簡要的介紹 pelican 的基本用法
Status: published

<開始正文>

注意:

  • 更多元數據以參考:;

  • 如果你使用VSCode作為你的日常開發工具,那麼我建議你使用插件為不同類型的文件自動生成頭信息模版;

4. 修改配置文件

在正式開始構建之前,我們需要完善一下配置文件pelicanconf.py:

# pelicanconf.py

# 修改時區
TIMEZONE = 'Asia/Shanghai'

# 添加一個 GitHub 的“絲帶”鏈接
GITHUB_URL = 'https://github.com/luizyao'

# 修改社交賬號的展示
SOCIAL = (
    ('GitHub', 'https://github.com/luizyao'),
)

# 修改默認的時間格式('%a %d %B %Y')
DEFAULT_DATE_FORMAT = "%Y-%m-%d %H:%M"

# 為元數據定義默認值
DEFAULT_METADATA = {
    # 默認發布的文章都是草稿,除非在文章元數據中明確指定:Status: published
    'status': 'draft',
}

5. 本地構建和訪問

我們通過以下命令構建網站並自動適配文件的修改,通過訪問:

λ pipenv run pelican --autoreload --listen content/

注意:

  • 不要忘記把文章元數據中的Status: draft改成Status: published,不然我們是看不到這篇文章的;

  • pelican默認使用notmyidea這個主題來構建網站;你可以通過pelican-themes命令查看已安裝的主題:

    λ pipenv run pelican-themes --list
    notmyidea
    simple

    然後通過在pelicanconf.py中設定THEME = 'simple'或者構建時傳入-t 'simple'選項來使用主題simple,實際上和純文本差不多了;

6. markdown解析異常

  • 這是一個列表:

    if 1:
        print('這是一段python代碼')

這個時候,如果你訪問我們的網站,你會發現上面的markdown代碼被展示成下面的形式,根本就不是我們想要的縮進代碼塊的效果:

為什麼會這樣呢?我們又該如何解決這個問題?

6.1. Markdown包的實現機制

pelican使用包作為markdown文本的解釋器,這個包嚴格實現了語法,並提供一些擴展;

John Gruber是markdown語法的發明者,他在2004發布了第一個版本的markdown語法,這一版本的語法有着明顯的特點:

  • 不支持三個反引號('```')包裹代碼的寫法;
  • 不支持表格;
  • 定義了嚴格的嵌套縮進的格式,必須是4個空格;
  • …

雖然自從發布了第一版之後,就再也沒有更新過,但是現在流行的各種markdown語法都是基於它的擴展和補充,例如:、等;

注意:

雖然Markdown包嚴格實現了John Gruber’s Markdown語法,但是具體的實現還是有一些差別的,更多細節可以參考:

6.2. pelican默認使用的Markdown擴展

上一節中我們提到,Markdown包同樣提供一些擴展用於解析更多類型的語法,這些擴展又分為官方擴展和第三方擴展;

通過查閱pelican的源碼(或官方文檔),可以看到其默認使用了以下擴展:

# pelican/settings.py

'MARKDOWN': {
    'extension_configs': {
        'markdown.extensions.codehilite': {'css_class': 'highlight'},
        'markdown.extensions.extra': {},
        'markdown.extensions.meta': {},
    },
    'output_format': 'html5',
},

首先,我們看一下擴展:

它主要實現了大多數PHP Markdown的語法,是其它6個擴展的合集:

擴展 文檔 描述
Abbreviations
Attribute Lists
Definition Lists
Fenced Code Blocks 擴展了代碼塊的寫法
Footnotes
Tables 支持表格

我們重點看一下Fenced Code Blocks,因為它支持了我常用的三個反引號包裹代碼塊的寫法:

GitHub‘s backtick (“`) syntax is also supported:

# more python code

然後,我們再看一下擴展:

它基於包為我們提供了代碼的高亮显示,我們主要看一下它的一些可配置選項:

  • linenums:如果置為True,將會為代碼塊每行標上行號;
  • css_class:為<div>標籤加上class屬性,默認是codehilite;在這裏,pelican使用的是highlight;

最後,我們看一下:

它主要是pelican內部使用,還記得我們每個markdown文本的開頭都要有特定的格式嗎?就是通過這個擴展讀取的;感興趣的同學可以自己去看一下,這裏我們就不多說了;

6.3. 向第三方擴展尋求幫助

看到現在,我們也沒有找到想要的解決方案:對列表裡縮進嵌套反引號包裹的代碼塊,進行正確的渲染;

還好我們還有眾多的第三方擴展供我們使用:

我們找到一個的擴展貌似可以代替markdown.extensions.extra,來一起看一下吧:

它和markdown.extensions.extra大部分是一樣的,只是有以下不同:

  • 新包含了擴展:優化粗體和斜體的展示(不關心);
  • 新包含了擴展:增加了對原始HTML代碼的處理(不關心);
  • 使用擴展代替Fenced Code Blocks:加強版的markdown語法解析(看來正式我們想要的);

其實,看到SuperFences文檔的第一句話,我就知道妥了,嘻嘻;

Allowing the nesting of fences under blockquotes, lists, or other block elements (see Limitations for more info).

文檔的內容很豐富,我們就不再這裏一一解釋了,有興趣的同學可以自己去看一看,說不定有什麼意外的收穫呢!!!

6.4. 解決問題

現在,我們來實際解決這個問題:

  1. 安裝必要的包:

    λ pipenv install pymdown-extensions
  2. 修改pelicanconf.py文件中MARKDOWN的默認配置:

    # 使用第三方擴展來增強對 markdown 語言的解析,但是首先要安裝 pymdown-extensions 模塊
    MARKDOWN = {
        'extension_configs': {
            'markdown.extensions.codehilite': {'css_class': 'highlight'},
            'pymdownx.extra': {},
            'markdown.extensions.meta': {},
        },
        'output_format': 'html5',
    }

7. One more thing

我在瀏覽SuperFences文檔時,發現一個很有意思的章節:;

它推薦了代替markdown.extensions.codehilite,那我們就來看看這到底是個什麼鬼?

在它的文檔中有一句話大概能說明兩者的關係:

The Highlight extension is inspired by CodeHilite, but differs in features. PyMdown Extensions chooses not to implement special language headers for standard Markdown code blocks like CodeHilite does; PyMdown Extensions takes the position that language headers are better suited in fenced code blocks.

更多實現上的細節,我們不再去深究,主要看看我們可以用來干什麼?

比如,為代碼塊每行加上行號:

咦?markdown.extensions.codehilite也可以啊,它不是也有一個linenums的選項嗎?置成True不就行了;

說的對,不過丑。

一般情況下,為代碼塊添加行號有兩種樣式:

  • table:默認的樣式,創建一個表,第一列是行號;
  • inline:在每行代碼的開頭,但是複製代碼會把行號一起複制,不方便;

不過,pymdownx.highlight提供了第三種樣式:pymdownx-inline,它和inline很像,只是複製時不會加上行號,因為實際上把行號元素渲染成下面這樣:

<span class="lineno" data-linenos="1 "></span>

然後,我們通過以下的CSS樣式去“激活”它:

[data-linenos]:before {
  content: attr(data-linenos);
}

下面,我們來將它具體的應用到我們的項目中吧:

首先,修改pelicanconf.py文件中MARKDOWN的默認配置:

# 使用第三方擴展來增強對 markdown 語言的解析,但是首先要安裝 pymdown-extensions 模塊
MARKDOWN = {
    'extension_configs': {
        'pymdownx.highlight': {
            'css_class': 'highlight',
            'linenums': True,
            'linenums_style': 'pymdownx-inline',
        },
        'pymdownx.extra': {},
        'markdown.extensions.meta': {},
    },
    'output_format': 'html5',
}

然後,在output/theme/css/main.css文件的末尾加上下面這段代碼:

[data-linenos]:before {
  content: attr(data-linenos);
}

最後重啟下服務,就能看到效果了:

注意:

這裡有個問題,如果我們重新執行構建命令,output/theme/css/main.css文件又會被覆蓋成原先的內容,我們這個效果就看不到了;

不過這並不是我們最終的方案,所以我們也不在這裏繼續深究了。

GitHub:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

【Flume】Flume基礎之安裝與使用

1、Flume簡介

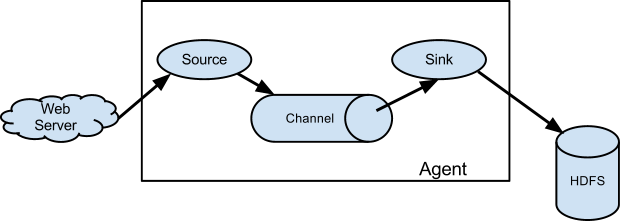
​ (1) Flume提供一個分佈式的,可靠的,對大數據量的日誌進行高效收集、聚集、移動的服務,Flume只能在Unix環境下運行。

​ (2) Flume基於流式架構,容錯性強,也很靈活簡單。

​ (3) Flume、Kafka用來實時進行數據收集,Spark、Flink用來實時處理數據,impala用來實時查詢。

2、Flume角色

2.1 Source

​ 用於採集數據,Source是產生數據流的地方,同時Source會將產生的數據流傳輸到Channel,這個有點類似於Java IO部分的Channel。

2.2 Channel

​ 用於橋接Sources和Sinks,類似於一個隊列。

2.3 Sink

​ 從Channel收集數據,將數據寫到目標源(可以是下一個Source,也可以是HDFS或者HBase)。

2.4 Event

​ 傳輸單元,Flume數據傳輸的基本單元,以事件的形式將數據從源頭送至目的地。

3、Flume傳輸過程

​ source監控某個文件或數據流,數據源產生新的數據,拿到該數據后,將數據封裝在一個Event中,並put到channel后commit提交,channel隊列先進先出,sink去channel隊列中拉取數據,然後寫入到HDFS或其他目標源中。

4、Flume安裝與部署

4.1 上傳包

​ 將flume的gz包上傳到/opt/soft/目錄下;

[root@bigdata111 conf]# rz

​ 若不支持rz命令,則用yum安裝lrzsz命令:

​ 查詢含有rz的yum源,由結果可見,yum源中含有lrzsz.x86_64包;

[root@bigdata111 soft]# yum search rzsz
已加載插件:fastestmirror
Loading mirror speeds from cached hostfile
 * base: mirrors.tuna.tsinghua.edu.cn
 * extras: mirrors.aliyun.com
 * updates: mirrors.aliyun.com
============================================================================================================================= N/S matched: rzsz ==============================================================================================================================
lrzsz.x86_64 : The lrz and lsz modem communications programs

  名稱和簡介匹配 only,使用“search all”試試。

​ 安裝rz命令

[root@bigdata111 soft]# yum -y install lrzsz

4.2 解壓包

​ 將flume解壓到/opt/module/目錄下,並改短名字flume-1.8.0:

[root@bigdata111 soft]# tar -zvxf apache-flume-1.8.0-bin.tar.gz -C /opt/module
[root@bigdata111 module]# mv apache-flume-1.8.0-bin flume-1.8.0

4.3 配置參數

​ 切換到/opt/module/flume-1.8.0/conf目錄,將flume-env.sh.template文件名改為:flume-env.sh

[root@bigdata111 module]# mv flume-env.sh.template flume-env.sh

​ 查詢JAVA_HOME的值;

[root@bigdata111 conf]# echo $JAVA_HOME
/opt/module/jdk1.8.0_144

​ 編輯flume-env.sh,將文件內容中的JAVA_HOME的值修改為上面查到的;

export JAVA_HOME=/opt/module/jdk1.8.0_144

4.4 配置環境變量

​ 在/etc/profile末尾添加flume的家路徑

export FLUME_HOME=/opt/module/flume-1.8.0
export PATH=$PATH:$FLUME_HOME/bin

4.5 驗證flume成功與否

​ 在xshell客戶端下,輸入flu,按tab鍵,看是否能夠自動補全:flume-ng

​ 如果可以自動補全,則代表安裝flume成功,否則失敗。

[root@bigdata112 opt]# flume-ng
Error: Unknown or unspecified command ''

Usage: /opt/module/flume-1.8.0/bin/flume-ng <command> [options]...

commands:
  help                      display this help text
  agent                     run a Flume agent
  avro-client               run an avro Flume client
  version                   show Flume version info
............

4.6 配置其他兩台機器

​ 利用scp命令,配置其他兩台機器;

​ 首先,將flume目錄分發到bigdata112,bigdata113

[root@bigdata111 ~]# scp -r /opt/module/flume-1.8.0/ root@bigdata112:/opt/module/
[root@bigdata111 ~]# scp -r /opt/module/flume-1.8.0/ root@bigdata113:/opt/module/

​ 其次,將/etc/profile環境變量文件分發到bigdata112,bigdata113

[root@bigdata111 ~]# scp -r /etc/profile root@bigdata112:/etc/
[root@bigdata111 ~]# scp -r /etc/profile root@bigdata113:/etc/

​ 最後,在bigdata112,bigdata113上分別刷新環境變量

[root@bigdata112 opt]# source /etc/profile
[root@bigdata113 opt]# source /etc/profile

5、Flume案例

5.1 監控端口數據

​ 目標:Flume監控一端Console,另一端Console發送消息,使被監控端實時显示。

5.1.1 安裝telnet命令

[root@bigdata111 conf]# yum -y install telnet

5.1.2 創建Agent配置文件

​ 在flume根目錄下,新建一個myconf目錄,用於存放自定義conf配置文件;

​ 新建flume-telnet.conf文件,文件內容如下:

# 定義agent
# <自定義agent名>.sources=<自定義source名稱>
a1.sources = r1
# <自定義agent名>.sinks=<自定義sink名稱>
a1.sinks = k1
# <自定義agent名>.channels=<自定義channel名稱>
a1.channels = c1

# 定義source
# <agent名>.sources.<source名稱>.type = 源類型
a1.sources.r1.type = netcat
# <agent名>.sources.<source名稱>.bind = 數據來源服務器
a1.sources.r1.bind = bigdata111
# <agent名>.sources.<source名稱>.port = 自定義未被佔用的端口
a1.sources.r1.port = 44445

# 定義sink
# <agent名>.sinks.<sink名稱>.type = 下沉到目標源的類型
a1.sinks.k1.type = logger

# 定義channel
# <agent名>.channels.<channel名稱>.type = channel的類型
a1.channels.c1.type = memory
# <agent名>.channels.<channel名稱>.capacity = 最大容量
a1.channels.c1.capacity = 1000
# transactionCapacity<=capacity
a1.channels.c1.transactionCapacity = 1000                  

# 雙向鏈接
# <agent名>.sources.<source名稱>.channels = channel名稱
a1.sources.r1.channels = c1
# <agent名>.sinks.<sink名稱>.channel = channel名稱
a1.sinks.k1.channel = c1

5.1.3 啟動flume配置文件

[root@bigdata111 conf]# flume-ng agent --conf /opt/module/flume-1.8.0/conf/ --name a1 --conf-file /opt/module/flume-1.8.0/conf/flume-telnet.conf -Dflume.root.logger==INFO,console

​ 可以簡寫為:

[root@bigdata111 conf]# flume-ng agent --c /opt/module/flume-1.8.0/conf/ --n a1 --f /opt/module/flume-1.8.0/conf/flume-telnet.conf -Dflume.root.logger==INFO,console

5.1.4 發送測試數據

​ 通過其他機器向bigdata111的44445端口發送數據

[root@bigdata112 ~]# telnet bigdata111 44445
Trying 192.168.1.111...
Connected to bigdata111.
Escape character is '^]'.
echo aaaa
OK
echo aaaa
OK
echo bbbbbbbbb
OK

運行結果如圖:

5.2 實時讀取本地文件到HDFS

5.2.1 創建Agent配置文件

​ 創建flume-hdfs配置文件

# 1 agent  若同時運行兩個agent,則agent名字需要改變,比如下面a2
a2.sources = r2
a2.sinks = k2
a2.channels = c2

# 2 source 
# 因監控linux本地文件,執行shell命令,所以type為exec;
a2.sources.r2.type = exec
# 監控的文件路徑
a2.sources.r2.command = tail -F /opt/test.log
a2.sources.r2.shell = /bin/bash -c

# 3 sink
# 數據下沉到目標源hdfs
a2.sinks.k2.type = hdfs
# 如果集群為HA模式,則路徑為active的namenode地址,普通分佈式集群,直接寫namenode所在地址即可。
a2.sinks.k2.hdfs.path = hdfs://bigdata111:9000/flume/%Y%m%d/%H
#上傳文件的前綴
a2.sinks.k2.hdfs.filePrefix = logs-
#是否按照時間滾動文件夾
a2.sinks.k2.hdfs.round = true
#多少時間單位創建一個新的文件夾
a2.sinks.k2.hdfs.roundValue = 1
#重新定義時間單位
a2.sinks.k2.hdfs.roundUnit = hour
#是否使用本地時間戳
a2.sinks.k2.hdfs.useLocalTimeStamp = true
#積攢多少個Event才flush到HDFS一次
a2.sinks.k2.hdfs.batchSize = 1000
#設置文件類型,可支持壓縮
a2.sinks.k2.hdfs.fileType = DataStream
#多久生成一個新的文件
a2.sinks.k2.hdfs.rollInterval = 600
#設置每個文件的滾動大小
a2.sinks.k2.hdfs.rollSize = 134217700
#文件的滾動與Event數量無關
a2.sinks.k2.hdfs.rollCount = 0
#最小副本數
a2.sinks.k2.hdfs.minBlockReplicas = 1

# 定義channel
a2.channels.c2.type = memory
a2.channels.c2.capacity = 1000
a2.channels.c2.transactionCapacity = 1000

# 雙向鏈接綁定
a2.sources.r2.channels = c2
a2.sinks.k2.channel = c2

5.2.2 啟動flume配置文件

[root@bigdata111 flume-1.8.0]# flume-ng agent --conf /opt/module/flume-1.8.0/conf/ --name a2 --conf-file /opt/module/flume-1.8.0/myconf/flume-hdfs.conf 

5.2.3 發送文件內容

[root@bigdata111 opt]# echo kjalksdjglkajsdg2333333333333333asdgasdgasdg >> test.log
[root@bigdata111 opt]# echo kjalksdjglkajsdg2333333333333333asdgasdgasdg >> test.log
[root@bigdata111 opt]# echo kjalksdjglkajsdg2333333333333333asdgasdgasdg >> test.log
[root@bigdata111 opt]# echo kjalksdjglkajsdg2333333333333333asdgasdgasdg >> test.log

​ 運行結果:

5.3 實時讀取目錄文件到HDFS

​ 目標:使用flume監聽整個目錄的文件

5.3.1 創建Agent配置文件

​ 創建agent配置文件,命名為:flume-dir.conf,文件內容如下:

#1 Agent
a3.sources = r3
a3.sinks = k3
a3.channels = c3

#2 source
#監控目錄的類型
a3.sources.r3.type = spooldir
#監控目錄的路徑
a3.sources.r3.spoolDir = /opt/module/flume1.8.0/upload
#哪個文件上傳hdfs,然後給這個文件添加一個後綴
a3.sources.r3.fileSuffix = .COMPLETED
a3.sources.r3.fileHeader = true
#忽略所有以.tmp結尾的文件,不上傳(可選)
a3.sources.r3.ignorePattern = ([^ ]*\.tmp)

# 3 sink
a3.sinks.k3.type = hdfs
a3.sinks.k3.hdfs.path = hdfs://bigdata111:9000/flume/%H
#上傳文件的前綴
a3.sinks.k3.hdfs.filePrefix = upload-
#是否按照時間滾動文件夾
a3.sinks.k3.hdfs.round = true
#多少時間單位創建一個新的文件夾
a3.sinks.k3.hdfs.roundValue = 1
#重新定義時間單位
a3.sinks.k3.hdfs.roundUnit = hour
#是否使用本地時間戳
a3.sinks.k3.hdfs.useLocalTimeStamp = true
#積攢多少個Event才flush到HDFS一次
a3.sinks.k3.hdfs.batchSize = 100
#設置文件類型,可支持壓縮
a3.sinks.k3.hdfs.fileType = DataStream
#多久生成一個新的文件
a3.sinks.k3.hdfs.rollInterval = 600
#設置每個文件的滾動大小大概是128M
a3.sinks.k3.hdfs.rollSize = 134217700
#文件的滾動與Event數量無關
a3.sinks.k3.hdfs.rollCount = 0
#最小副本數
a3.sinks.k3.hdfs.minBlockReplicas = 1

# Use a channel which buffers events in memory
a3.channels.c3.type = memory
a3.channels.c3.capacity = 1000
a3.channels.c3.transactionCapacity = 100

# Bind the source and sink to the channel
a3.sources.r3.channels = c3
a3.sinks.k3.channel = c3

​ 溫馨提示:

​ 1) 不要在監控目錄中創建並持續修改文件

​ 2) 上傳完成的文件會以.COMPLETED結尾

​ 3) 被監控文件夾每500毫秒掃描一次文件變動

5.3.2 啟動flume配置文件

[root@bigdata111 myconf]# flume-ng agent --conf /opt/module/flume-1.8.0/conf/ --name a3 --conf-file /opt/module/flume-1.8.0/myconf/flume-dir.conf

5.3.3 上傳文件到upload目錄

[root@bigdata111 opt]# mkdir upload
[root@bigdata111 opt]# ls
module  soft  test.log  upload
[root@bigdata111 opt]# mv test.log upload/
[root@bigdata111 opt]# ls
module  soft  upload
[root@bigdata111 opt]# vi test1.log
[root@bigdata111 opt]# mv test1.log upload/

​ 運行如圖:

5.4 扇出例子01

扇出:數據用於多個地方。(簡單理解:一個數據源對應多個channel,sink,並且輸出到多個目標源)

例子01示意圖:

目標:在flume1裏面接收數據,然後數據下沉到兩個不同目標源(控制台和HDFS)

5.4.1 創建Agent配置文件

​ 在myconf目錄下,新建一個flume-fanout1.conf文件,內容配置如下:

# 定義agent
a1.sources=c1
a1.channels=k1 k2
a1.sinks=s1 s2

# 定義source
a1.sources.c1.type=exec
a1.sources.c1.command=tail -F /opt/test.log
a1.sources.c1.shell=/bin/bash -c

# 將數據流複製給多個channel
a1.sources.r1.selector.type=replicating

# 定義channel1
a1.channels.k1.type=memory
a1.channels.k1.capacity = 1000
a1.channels.k1.transactionCapacity=1000

# 定義channel2
a1.channels.k2.type=memory
a1.channels.k2.capacity = 1000
a1.channels.k2.transactionCapacity=1000

# 定義sink1
a1.sinks.s1.type=logger

# 定義sink2
a1.sinks.s2.type=hdfs
a1.sinks.s2.hdfs.path = hdfs://bigdata111:9000/flume/%Y%m%d/%H
# 上傳文件的前綴
a1.sinks.s2.hdfs.filePrefix = logs-
# 是否按照時間滾動文件夾
a1.sinks.s2.hdfs.round = true
# 多少時間單位創建一個新的文件夾
a1.sinks.s2.hdfs.roundValue = 1
# 重新定義時間單位
a1.sinks.s2.hdfs.roundUnit = hour
# 是否使用本地時間戳
a1.sinks.s2.hdfs.useLocalTimeStamp = true
# 積攢多少個Event才flush到HDFS一次
a1.sinks.s2.hdfs.batchSize = 1000
# 設置文件類型,可支持壓縮
a1.sinks.s2.hdfs.fileType = DataStream
# 多久生成一個新的文件
a1.sinks.s2.hdfs.rollInterval = 600
# 設置每個文件的滾動大小
a1.sinks.s2.hdfs.rollSize = 134217700
# 文件的滾動與Event數量無關
a1.sinks.s2.hdfs.rollCount = 0
# 最小副本數
a1.sinks.s2.hdfs.minBlockReplicas = 1

# 雙向鏈接
a1.sources.c1.channels = k1 k2
a1.sinks.s1.channel=k1
a1.sinks.s2.channel=k2

5.4.2 啟動flume配置文件

[root@bigdata111 myconf]# flume-ng agent --conf /opt/module/flume-1.8.0/conf/ --name a1 --conf-file /opt/module/flume-1.8.0/myconf/flume-fanout1.conf -Dflume.root.logger==INFO,console

5.4.3 向文件添加內容

​ 切換到/opt/目錄下,新建test.log文件,然後動態添加內容,觀察控制台輸出以及web的hdfs文件

[root@bigdata111 opt]# touch test.log
[root@bigdata111 opt]# touch test.log
[root@bigdata111 opt]# echo 'china' >>test.log 
[root@bigdata111 opt]# echo 'hello world' >>test.log
[root@bigdata111 opt]# echo 'nihao' >> test.log

​ 控制台輸出如下:

​ web頁面結果:

5.5 扇出例子02

目標:flume1監控文件,然後將變動數據分別傳給flume2和flume3,flume2的數據下沉到HDFS;flume3的數據下沉到本地文件;

5.5.1 創建flume1配置文件

​ 在bigdata111上的myconf目錄下,新建agent配置文件:flume-fanout1.conf;

​ flume1用於監控某文件的變動,同時產生兩個channel和兩個sink,分別輸送給flume2,flume3;

​ 文件內容如下:

# 配置agent
a1.sources = c1
a1.channels = k1 k2
a1.sinks = s1 s2

# 定義source
a1.sources.c1.type=exec
a1.sources.c1.command=tail -F /opt/test.log
a1.sources.c1.shell=/bin/bash -c

# 將數據流複製給多個channel
a1.sources.c1.selector.type=replicating

# 定義channel1
a1.channels.k1.type=memory
a1.channels.k1.capacity = 1000
a1.channels.k1.transactionCapacity=1000

# 定義channel2
a1.channels.k2.type=memory
a1.channels.k2.capacity = 1000
a1.channels.k2.transactionCapacity=1000

# 定義sink1
a1.sinks.s1.type = avro
a1.sinks.s1.hostname = bigdata112
a1.sinks.s1.port = 4402

# 定義sink2
a1.sinks.s2.type = avro
a1.sinks.s2.hostname = bigdata113
a1.sinks.s2.port = 4402

# 雙向鏈接
a1.sources.c1.channels = k1 k2
a1.sinks.s1.channel=k1
a1.sinks.s2.channel=k2

5.5.2 創建flume2配置文件

​ 在bigdata112的myconf目錄下,新建agent配置文件:flume-fanout2.conf

​ 接收flume1的event數據,然後產生一個channel和一個sink,最後將數據下沉到hdfs

​ 文件內容如下:

# 配置agent 不同agent之間,agent名不相同,但是source,channel,sink名可以相同
a2.sources = c2
a2.channels = k2
a2.sinks = s2

# 定義source
a2.sources.c2.type=avro
a2.sources.c2.bind = bigdata112
a2.sources.c2.port = 4402

# 定義channel
a2.channels.k2.type=memory
a2.channels.k2.capacity = 1000
a2.channels.k2.transactionCapacity=1000

# 定義sink
a2.sinks.s2.type = hdfs
a2.sinks.s2.hdfs.path=hdfs://bigdata111:9000/flume2/%H
#上傳文件的前綴
a2.sinks.s2.hdfs.filePrefix = flume2-
#是否按照時間滾動文件夾
a2.sinks.s2.hdfs.round = true
#多少時間單位創建一個新的文件夾
a2.sinks.s2.hdfs.roundValue = 1
#重新定義時間單位
a2.sinks.s2.hdfs.roundUnit = hour
#是否使用本地時間戳
a2.sinks.s2.hdfs.useLocalTimeStamp = true
#積攢多少個Event才flush到HDFS一次
a2.sinks.s2.hdfs.batchSize = 100
#設置文件類型,可支持壓縮
a2.sinks.s2.hdfs.fileType = DataStream
#多久生成一個新的文件
a2.sinks.s2.hdfs.rollInterval = 600
#設置每個文件的滾動大小大概是128M
a2.sinks.s2.hdfs.rollSize = 134217700
#文件的滾動與Event數量無關
a2.sinks.s2.hdfs.rollCount = 0
#最小副本數
a2.sinks.s2.hdfs.minBlockReplicas = 1

# 雙向鏈接
a2.sources.c2.channels = k2
a2.sinks.s2.channel=k2

5.5.3 創建flume3配置文件

​ 在bigdata113的myconf目錄下,新建agent配置文件:flume-fanout3.conf

​ 接收flume1的event數據,然後產生一個channel和一個sink,最後將數據下沉到本地/opt/flume3

​ 文件內容如下:

# 配置agent
a3.sources = c3
a3.channels = k3
a3.sinks = s3

# 定義source
a3.sources.c3.type=avro
a3.sources.c3.bind = bigdata113
a3.sources.c3.port = 4402

# 定義channel
a3.channels.k3.type=memory
a3.channels.k3.capacity = 1000
a3.channels.k3.transactionCapacity=1000

# 定義sink
a3.sinks.s3.type = file_roll
# 提示:本地此目錄必須先建好,程序不會自動創建該目錄
a3.sinks.s3.sink.directory=/opt/flume3

# 雙向鏈接
a3.sources.c3.channels = k3
a3.sinks.s3.channel=k3

5.5.4 啟動三台機器配置文件

bigdata111:

[root@bigdata111 myconf]# flume-ng agent --conf /opt/module/flume-1.8.0/conf/ --name a1 --conf-file /opt/module/flume-1.8.0/myconf/flume-fanout1.conf -Dflume.root.logger==INFO,console

bigdata112:

[root@bigdata112 myconf]# flume-ng agent --conf /opt/module/flume-1.8.0/conf/ --name a2 --conf-file /opt/module/flume-1.8.0/myconf/flume-fanout2.conf 

bigdata113:

[root@bigdata113 myconf]# flume-ng agent --conf /opt/module/flume-1.8.0/conf/ --name a3 --conf-file /opt/module/flume-1.8.0/myconf/flume-fanout3.conf 

​ 運行結果如圖:

​ bigdata112:

​ bigdata113:

5.6 扇入例子

5.6.1 創建flume1配置文件

​ flume1(agent1)監控端口數據變化,將數據sink到flume3(agent3);

​ 在myconf目錄下新建agent文件:flume-fanin-1.conf

​ 配置內容如下:

# 配置agent
a1.sources = c1
a1.channels = k1
a1.sinks = s1

# 配置source
a1.sources.c1.type = netcat
a1.sources.c1.bind = bigdata111
a1.sources.c1.port = 6666

# 配置sink
a1.sinks.s1.type=avro
a1.sinks.s1.hostname=bigdata113
a1.sinks.s1.port=5008

# 配置channel
a1.channels.k1.type=memory
a1.channels.k1.capacity=1000
a1.channels.k1.transactionCapacity=1000

# 雙向綁定
a1.sources.c1.channels = k1
a1.sinks.s1.channel = k1

5.6.2 創建flume2配置文件

​ flume2(agent2)監控本地文件變化,將數據sink到flume3(agent3);

​ 在myconf目錄下新建agent文件:flume-fanin-2.conf

​ 配置內容如下:

# 配置agent
a2.sources = c1
a2.channels = k1
a2.sinks = s1

# 配置source
a2.sources.c1.type = exec
a2.sources.c1.command = tail -F /opt/ceshi.log
a2.sources.c1.shell=/bin/bash -c

# 配置sink
a2.sinks.s1.type=avro
a2.sinks.s1.hostname=bigdata113
a2.sinks.s1.port=5008

# 配置channel
a2.channels.k1.type=memory
a2.channels.k1.capacity=1000
a2.channels.k1.transactionCapacity=1000

# 雙向綁定
a2.sources.c1.channels = k1
a2.sinks.s1.channel = k1

5.6.3 創建flume3配置文件

​ flume3(agent3)接收flume1和flume2的數據,將數據sink到HDFS ;

​ 在myconf目錄下新建agent文件:flume-fanin-3.conf

​ 配置內容如下:

# 配置agent
a3.sources = c1
a3.channels = k1
a3.sinks = s1

# 配置source
a3.sources.c1.type = avro
a3.sources.c1.bind = bigdata113
a3.sources.c1.port = 5008

# 配置sink
a3.sinks.s1.type=hdfs
a3.sinks.s1.hdfs.path=hdfs://bigdata111:9000/flume3/%H
# 上傳文件的前綴
a3.sinks.s1.hdfs.filePrefix = flume3-
# 是否按照時間滾動文件夾
a3.sinks.s1.hdfs.round = true
# 多少時間單位創建一個新的文件夾
a3.sinks.s1.hdfs.roundValue = 1
# 重新定義時間單位
a3.sinks.s1.hdfs.roundUnit = hour
# 是否使用本地時間戳
a3.sinks.s1.hdfs.useLocalTimeStamp = true
# 積攢多少個Event才flush到HDFS一次
a3.sinks.s1.hdfs.batchSize = 1000
# 設置文件類型,可支持壓縮
a3.sinks.s1.hdfs.fileType = DataStream
# 多久生成一個新的文件
a3.sinks.s1.hdfs.rollInterval = 600
# 設置每個文件的滾動大小大概是128M
a3.sinks.s1.hdfs.rollSize = 134217700
# 文件的滾動與Event數量無關
a3.sinks.s1.hdfs.rollCount = 0
# 最小冗餘數
a3.sinks.s1.hdfs.minBlockReplicas = 1

# 配置channel
a3.channels.k1.type=memory
a3.channels.k1.capacity=1000
a3.channels.k1.transactionCapacity=1000

# 雙向綁定
a3.sources.c1.channels = k1
a3.sinks.s1.channel = k1

5.6.4 啟動三個flume配置文件

flume1:

[root@bigdata111 myconf]# flume-ng agent -c ../conf/ -n a1 -f flume-fanout1.conf -Dflume.root.logger==INFO,console

flume2:

[root@bigdata112 myconf]# flume-ng agent -c ../conf/ -n a2 -f flume-fanout2.conf 

flume3:

[root@bigdata113 myconf]# flume-ng agent -c ../conf/ -n a3 -f flume-fanout3.conf 

5.6.5 操作端口與文件

新開xshell選項卡,鏈接bigdata111服務器,然後執行telnet命令:

[root@bigdata111 ~]# telnet bigdata111 6666
Trying 192.168.1.111...
Connected to bigdata111.
Escape character is '^]'.
english
OK
chinese
OK
hello
OK
.net
OK
php
OK
java
OK

新開xshell選項卡,鏈接bigdata112服務器,然後向/opt/ceshi.log添加新內容:

[root@bigdata112 ~]# cd /opt/
[root@bigdata112 opt]# ls
ceshi.log  ha  module  soft  zookeeper.out
[root@bigdata112 opt]# cat ceshi.log
start-log-in
end-log
[root@bigdata112 opt]# echo `date` >> ceshi.log
[root@bigdata112 opt]# echo "end-log" >> ceshi.log
[root@bigdata112 opt]# cat ceshi.log 
start-log-in
end-log
2019年 09月 07日 星期六 23:36:03 CST
end-log

5.6.6 显示運行結果

​ web頁面結果:

​ hdfs的文件內容:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

[ch02-00] 反向傳播與梯度下降的通俗解釋

系列博客,原文在筆者所維護的github上:,
點擊star加星不要吝嗇,星越多筆者越努力。

第2章 神經網絡中的三個基本概念

2.0 通俗地理解三大概念

這三大概念是:反向傳播,梯度下降,損失函數。

神經網絡訓練的最基本的思想就是:先“猜”一個結果,我們叫預測結果a,看看這個預測結果和事先標記好的訓練集中的真實結果y之間的差距,然後調整策略,再試一次,這一次就不是“猜”了,而是有依據地向正確的方向靠近。如此反覆多次,一直到預測結果和真實結果之間相差無幾,亦即|a-y|->0,就結束訓練。

在神經網絡訓練中,我們把“猜”叫做初始化,可以隨機,也可以根據以前的經驗給定初始值。即使是“猜”,也是有技術含量的。

這三個概念是前後緊密相連的,講到一個,肯定會牽涉到另外一個。但由於損失函數篇幅較大,我們將在下一章中再詳細介紹。

下面我們舉幾個例子來直觀的說明下這三個概念。

2.0.1 例一:猜數

甲乙兩個人玩兒猜數的遊戲,数字的範圍是[1,50]:

甲:我猜5

乙:太小了

甲:50

乙:有點兒大

甲:30

乙:小了

……

在這個遊戲里:

  • 目的:猜到乙心中的数字;
  • 初始化:甲猜5;
  • 前向計算:甲每次猜的新数字;
  • 損失函數:乙在根據甲猜的數來和自己心中想的數做比較,得出“大了”或“小了”的結論;
  • 反向傳播:乙告訴甲“小了”、“大了”;
  • 梯度下降:甲根據乙的反饋中的含義自行調整下一輪的猜測值。

這裏的損失函數是什麼呢?就是“太小了”,“有點兒大”,很不精確!這個“所謂的”損失函數給出了兩個信息:

  1. 方向:大了或小了
  2. 程度:“太”,“有點兒”,但是很模糊

2.0.2 例二:黑盒子

假設有一個黑盒子如圖2-1。

圖2-1 黑盒子

我們只能看到輸入和輸出的數值,看不到裏面的樣子,當輸入1時,輸出2.334,然後黑盒子有個信息显示:我需要輸出值是4。然後我們試了試輸入2,結果輸出5.332,一下子比4大了很多。那麼我們第一次的損失值是\(2.334-4=-1.666\),而二次的損失值是\(5.332-4=1.332\)。

這裏,我們的損失函數就是一個簡單的減法,用實際值減去目標值,但是它可以告訴你兩個信息:1)方向,是大了還是小了;2)差值,是0.1還是1.1。這樣就給了我們下一次猜的依據。

  • 目的:猜到一個輸入值,使得黑盒子的輸出是4
  • 初始化:輸入1
  • 前向計算:黑盒子內部的數學邏輯
  • 損失函數:在輸出端,用輸出值減4
  • 反向傳播:告訴猜數的人差值,包括正負號和值
  • 梯度下降:在輸入端,根據正負號和值,確定下一次的猜測值,goto前向計算

2.0.3 例三:打靶

小明拿了一支步槍,射擊100米外的靶子。這支步槍沒有準星,或者是準星有問題,或者是小明眼神兒不好看不清靶子,或者是霧很大,或者風很大,或者由於木星的影響而側向引力場異常……反正就是遇到各種干擾因素。

第一次試槍后,拉回靶子一看,彈着點偏左了,於是在第二次試槍時,小明就會有意識地向右側偏幾毫米,再看靶子上的彈着點,如此反覆幾次,小明就會掌握這支步槍的脾氣了。圖2-2显示了小明的5次試槍過程。

圖2-2 打靶的彈着點記錄

在有監督的學習中,需要衡量神經網絡輸出和所預期的輸出之間的差異大小。這種誤差函數需要能夠反映出當前網絡輸出和實際結果之間一種量化之後的不一致程度,也就是說函數值越大,反映出模型預測的結果越不準確。

這個例子中,小明預期的目標是全部命中靶子的中心,最外圈是1分,之後越向靶子中心分數是2,3,4分,正中靶心可以得10分。

  • 每次試槍彈着點和靶心之間的差距就叫做誤差,可以用一個誤差函數來表示,比如差距的絕對值,如圖中的紅色線。
  • 一共試槍5次,就是迭代/訓練了5次的過程 。
  • 每次試槍后,把靶子拉回來看彈着點,然後調整下一次的射擊角度的過程,叫做反向傳播。注意,把靶子拉回來看和跑到靶子前面去看有本質的區別,後者容易有生命危險,因為還有別的射擊者。一個不恰當的比喻是,在數學概念中,人跑到靶子前面去看,叫做正向微分;把靶子拉回來看,叫做反向微分。
  • 每次調整角度的數值和方向,叫做梯度。比如向右側調整1毫米,或者向左下方調整2毫米。如圖中的綠色矢量線。

上圖是每次單發點射,所以每次訓練樣本的個數是1。在實際的神經網絡訓練中,通常需要多個樣本,做批量訓練,以避免單個樣本本身採樣時帶來的誤差。在本例中,多個樣本可以描述為連發射擊,假設一次可以連打3發子彈,每次的離散程度都類似,如圖2-3所示。

圖2-3 連發彈着點記錄

  • 如果每次3發子彈連發,這3發子彈的彈着點和靶心之間的差距之和再除以3,叫做損失,可以用損失函數來表示。

那小明每次射擊結果和目標之間的差距是多少呢?在這個例子裏面,用得分來衡量的話,就是說小明得到的反饋結果從差9分,到差8分,到差2分,到差1分,到差0分,這就是用一種量化的結果來表示小明的射擊結果和目標之間差距的方式。也就是誤差函數的作用。因為是一次只有一個樣本,所以這裏採用的是誤差函數的稱呼。如果一次有多個樣本,就要叫做損失函數了。

其實射擊還不這麼簡單,如果是遠距離狙擊,還要考慮空氣阻力和風速,在神經網絡里,空氣阻力和風速可以對應到隱藏層的概念上。

在這個例子中:

  • 目的:打中靶心;
  • 初始化:隨便打一槍,能上靶就行,但是要記住當時的步槍的姿態;
  • 前向計算:讓子彈飛一會兒,擊中靶子;
  • 損失函數:環數,偏離角度;
  • 反向傳播:把靶子拉回來看;
  • 梯度下降:根據本次的偏差,調整步槍的射擊角度,goto前向計算。

損失函數的描述是這樣的:

  1. 1環,偏左上45度;
  2. 6環,偏左上15度;
  3. 7環,偏左;
  4. 8環,偏左下15度;
  5. 10環。

這裏的損失函數也有兩個信息:

  1. 距離;
  2. 方向。

所以,梯度,是個矢量! 它應該即告訴我們方向,又告訴我們數值。

2.0.4 黑盒子的真正玩兒法

以上三個例子比較簡單,容易理解,我們把黑盒子再請出來:黑盒子這件事真正的意義並不是猜測當輸入是多少時輸出會是4。它的實際意義是:我們要破解這個黑盒子!於是,我們會有如下破解流程:

  1. 記錄下所有輸入值和輸出值,如表2-1。

表2-1 樣本數據表

樣本ID 輸入(特徵值) 輸出(標籤)
1 1 2.21
2 1.1 2.431
3 1.2 2.652
4 2 4.42
  1. 搭建一個神經網絡,給出初始權重值,我們先假設這個黑盒子的邏輯是:\(z=x + x^2\);
  2. 輸入1,根據\(z=x + x^2\)得到輸出為2,而實際的輸出值是2.21,則誤差值為\(2-2.21=-0.21\),小了;
  3. 調整權重值,比如\(z=1.5x+x^2\),再輸入1.1,得到的輸出為2.86,實際輸出為2.431,則誤差值為\(2.86-2.431=0.429\),大了;
  4. 調整權重值,比如\(z=1.2x+x^2\)再輸入1.2……
  5. 調整權重值,再輸入2……
  6. 所有樣本遍歷一遍,計算平均的損失函數值;
  7. 依此類推,重複3,4,5,6過程,直到損失函數值小於一個指標,比如0.001,我們就可以認為網絡訓練完畢,黑盒子“破解”了,實際是被複制了,因為神經網絡並不能得到黑盒子里的真實函數體,而只是近似模擬。

從上面的過程可以看出,如果誤差值是正數,我們就把權重降低一些;如果誤差值為負數,則升高權重。

2.0.5 總結

簡單總結一下反向傳播與梯度下降的基本工作原理:

  1. 初始化;
  2. 正向計算;
  3. 損失函數為我們提供了計算損失的方法;
  4. 梯度下降是在損失函數基礎上向著損失最小的點靠近而指引了網絡權重調整的方向;
  5. 反向傳播把損失值反向傳給神經網絡的每一層,讓每一層都根據損失值反向調整權重;
  6. goto 2,直到精度足夠好(比如損失函數值小於0.001)。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

022.掌握Pod-Pod升級和回滾

一 deploymentPod升級和回滾

1.1 deployment升級


若Pod是通過Deployment創建的,可以在運行時修改Deployment的Pod定義(spec.template)或鏡像名稱,並應用到Deployment對象上,系統即可完成Deployment的自動更新操作。 如果在更新過程中發生了錯誤, 則還可以通過回滾操作恢復Pod的版本。

示例:

  1 [root@uk8s-m-01 study]# vi nginx-deployment.yaml
  2 apiVersion: apps/v1beta1
  3 kind: Deployment
  4 metadata:
  5   name: nginx-deployment
  6 spec:
  7   replicas: 3
  8   template:
  9     metadata:
 10       labels:
 11         app: nginx
 12     spec:
 13       containers:
 14       - name: nginx
 15         image: nginx:1.7.9
 16         ports:
 17         - containerPort: 80
 18 
 19 [root@uk8s-m-01 study]# kubectl create -f nginx-deployment.yaml
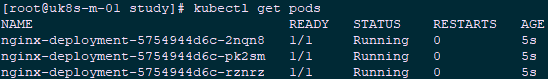
 20 [root@uk8s-m-01 study]# kubectl get pods


  1 [root@uk8s-m-01 study]# kubectl get deployment			#查看deployment
  2 [root@uk8s-m-01 study]# kubectl set image deployment/nginx-deployment nginx=nginx:1.8.1	#命令更新
  3 [root@uk8s-m-01 study]# kubectl get pods			        #查看升級后的pod


  1 [root@uk8s-m-01 study]# kubectl edit deployment/nginx-deployment			#直接編輯deployment


  1 [root@uk8s-m-01 study]# kubectl rollout status deployment/nginx-deployment		#查看升級情況


  1 [root@uk8s-m-01 study]# kubectl get pods
  2 [root@uk8s-m-01 study]# kubectl describe pod nginx-deployment-7448597cd5-8sng2 | grep Image


1.2 deployment升級原理

  1 [root@uk8s-m-01 study]# kubectl describe deployments/nginx-deployment		#觀察Deployment的更新過程


初始創建Deployment時,系統創建了一個ReplicaSet(nginx-deployment-5754944d6c),並按用戶的需求創建了3個Pod副本。

當更新Deployment時,系統創建了一個新的ReplicaSet(nginx-deployment-b5f766d54),並將其副本數量擴展到1,然後將舊ReplicaSet縮減為2。

之後,系統繼續按照相同的更新策略對新舊兩個ReplicaSet進行逐個調整。

最後,新的ReplicaSet運行了3個新版本Pod副本,舊的ReplicaSet副本數量則縮減為0。


  1 [root@uk8s-m-01 study]# kubectl get rs			#查看多次升級的結果


注意:在整個升級的過程中,系統會保證至少有兩個Pod可用,並且最多同時運行4個Pod,這是Deployment通過複雜的算法完成的。Deployment需要確保在整個更新過程中只有一定數量的Pod可能處於不可用狀態。在默認情況下,Deployment確保可用的Pod總數至少為所需的副本數量(DESIRED)減1,也就是最多1個不可用(maxUnavailable=1)。

1.3 deployment升級策略


在Deployment的定義中,可以通過spec.strategy指定Pod更新的策略,目前支持兩種策略:Recreate(重建)和RollingUpdate(滾動更新),默認值為RollingUpdate。

  • Recreate:設置spec.strategy.type=Recreate,表示Deployment在更新Pod時,會先殺掉所有正在運行的Pod,然後創建新的Pod。
  • RollingUpdate:設置spec.strategy.type=RollingUpdate,表示Deployment會以滾動更新的方式來逐個更新Pod。同時,可以通過設置spec.strategy.rollingUpdate下的兩個參數(maxUnavailable和maxSurge)來控制滾動更新的過程。


    • spec.strategy.rollingUpdate.maxUnavailable:用於指定Deployment在更新過程中不可用狀態的Pod數量的上限。 該maxUnavailable的數值可以是絕對值(例如5)或Pod期望的副本數的百分比(例如10%),如果被設置為百分比,那麼系統會先以向下取整的方式計算出絕對值(整數)。而當另一個參數maxSurge被設置為0時,maxUnavailable則必須被設置為絕對數值大於0。舉例來說,當maxUnavailable被設置為30%時,舊的ReplicaSet可以在滾動更新開始時立即將副本數縮小到所需副本總數的70%。一旦新的Pod創建並準備好,舊的ReplicaSet會進一步縮容,新的ReplicaSet又繼續擴容。整個過程中系統在任意時刻都可以確保可用狀態的Pod總數至少佔Pod期望副本總數的70%。
    • spec.strategy.rollingUpdate.maxSurge:用於指定在Deployment更新Pod的過程中Pod總數超過Pod期望副本數部分的最大值。該maxSurge的數值可以是絕對值(例如5)或Pod期望副本數的百分比(例

  • 如10%)。如果設置為百分比,那麼系統會先按照向上取整的方式計算出絕對數值(整數)。舉例來說,當maxSurge的值被設置為30%時,新的ReplicaSet可以在滾動更新開始時立即進行副本數擴容,只需要保證新舊ReplicaSet的Pod副本數之和不超過期望副本數的130%即可。一旦舊的Pod被殺掉,新的ReplicaSet就會進一步擴容。在整個過程中系統在任意時刻都能確保新舊ReplicaSet的Pod副本總數之和不超過所需副本數的130%。

1.4 deployment回滾


默認情況下,所有Deployment的發布歷史記錄都被保留在系統中,以便於我們隨時進行回滾(可以配置歷史記錄數量)。

  1 [root@uk8s-m-01 study]# kubectl rollout history deployment/nginx-deployment	#查看部署歷史
  2 [root@uk8s-m-01 study]# kubectl rollout history deployment/nginx-deployment  --revision=3	#查看對應的部署歷史版本
  3 [root@uk8s-m-01 study]# kubectl rollout history deployment/nginx-deployment  --revision=2	#查看對應的部署歷史版本


提示:Deployment的更新操作是在Deployment進行部署(Rollout)時被觸發的,即當且僅當Deployment的Pod模板(即spec.template)被更改時才會創建新的修訂版本,例如更新模板標籤或容器鏡像。其他更新操作(如擴展副本數)將不會觸發Deployment的更新操作,因此將Deployment回滾到之前的版本時,只有Deployment的Pod模板部分會被修改。

  1 [root@uk8s-m-01 study]# kubectl rollout undo deployment/nginx-deployment --to-revision=2	#回滾版本
  2 [root@uk8s-m-01 study]# kubectl describe deployment/nginx-deployment


1.5 暫停和恢復deployment


對於一次複雜的Deployment配置修改,為了避免頻繁觸發Deployment的更新操作,可以先暫停Deployment的更新操作,然後進行

配置修改,再恢復Deployment,一次性觸發完整的更新操作,從而避免不必要的Deployment更新操作了。

  1 [root@uk8s-m-01 study]# kubectl get deployments				#查看deployment
  2 [root@uk8s-m-01 study]# kubectl get rs					#查看rs
  3 [root@uk8s-m-01 study]# kubectl rollout pause deployment/nginx-deployment	#暫停deployment
  4 [root@uk8s-m-01 study]# kubectl set image deployment/nginx-deployment nginx=nginx:1.10.3	#升級操作,但由於暫停deployment,因此不會觸發更新
  5 [root@uk8s-m-01 study]# kubectl rollout history deployment/nginx-deployment	#查看歷史版本
  6 [root@uk8s-m-01 study]# kubectl set resources deployment/nginx-deployment -c=nginx --limits=cpu=200m,memory=512Mi
  7 [root@uk8s-m-01 study]# kubectl rollout resume deployment/nginx-deployment	#恢復deployment
  8 [root@uk8s-m-01 study]# kubectl get rs
  9 NAME                          DESIRED   CURRENT   READY   AGE
 10 nginx-deployment-7448597cd5   0         0         0       52m
 11 nginx-deployment-84bc94dcb7   1         1         0       6s
 12 nginx-deployment-b5f766d54    3         3         3       55m


  1 [root@uk8s-m-01 study]# kubectl describe deployment/nginx-deployment
  2 [root@uk8s-m-01 study]# kubectl describe pods nginx-deployment-84bc94dcb7-hqxkk | grep Image
  3     Image:          nginx:1.10.3


二 RC升級和回滾

2.1 RC滾動升級


, Kubernetes提供了kubectl rolling-update命令進行對於RC的滾動升級。該命令創建了一個新的RC,然後自動控制舊的RC中的Pod副本數量逐漸減少到0,同時新的RC中的Pod副本數量從0逐步增加到目標值,來完成Pod的升級。

注意:該方式要求新的RC與舊的RC都在相同的命名空間內。

示例:

  1 [root@uk8s-m-01 study]# vi redis-master-controller-v1.yaml
  2 apiVersion: v1
  3 kind: ReplicationController
  4 metadata:
  5   name: redis-master-v1
  6   labels:
  7     name: redis-master
  8 spec:
  9   replicas: 1
 10   selector:
 11     name: redis-master
 12   template:
 13     metadata:
 14       labels:
 15         name: redis-master
 16     spec:
 17       containers:
 18       - name: master
 19         image: kubeguide/redis-master:1.0
 20         ports:
 21         - containerPort: 6379
 22 
 23 [root@uk8s-m-01 study]# kubectl create -f redis-master-controller-v1.yaml


  1 [root@uk8s-m-01 study]# vi redis-master-controller-v2.yaml		#RC升級配置文件
  2 apiVersion: v1
  3 kind: ReplicationController
  4 metadata:
  5   name: redis-master-v2
  6   labels:
  7     name: redis-master
  8     version: v2
  9 spec:
 10   replicas: 1
 11   selector:
 12     name: redis-master
 13     version: v2
 14   template:
 15     metadata:
 16       labels:
 17         name: redis-master
 18         version: v2
 19     spec:
 20       containers:
 21       - name: master
 22         image: kubeguide/redis-master:2.0
 23         ports:
 24         - containerPort: 6379


注意:使用此方式升級的時候需要注意以下兩點:

  1. RC的名字(name) 不能與舊RC的名字相同。
  2. 在selector中應至少有一個Label與舊RC的Label不同, 以標識其為新RC。如上所示新增了一個名為version的Label,以與舊RC進行區分。

  1 [root@uk8s-m-01 study]# kubectl rolling-update redis-master-v1 -f redis-master-controller-v2.yaml
  2 [root@uk8s-m-01 study]# kubectl rolling-update redis-master-v1 --image=kubeguide/redis-master:2.0	#也可直接命令中升級


kubectl通過新建一個新版本Pod, 停掉一箇舊版本Pod,如此逐步迭代來完成整個RC的更新。

2.2 RC回滾

  1 [root@uk8s-m-01 study]# kubectl rolling-update redis-master-v1 --rollback


提示:RC的滾動升級不具有Deployment在應用版本升級過程中的歷史記錄、新舊版本數量的精細控制等功能,RC將逐漸被RS和Deployment所取代,建議用戶優先考慮使用Deployment完成Pod的部署和升級操作。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享