Spring Cloud Alibaba(四)實現Dubbo服務消費

本項目演示如何使用 Spring Cloud Alibaba 完成 Dubbo 的RPC調用。

Spring Cloud與Dubbo

  • Spring Cloud是一套完整的微服務架構方案

  • Dubbo是國內目前非常流行的服務治理與RPC實現方案

由於Dubbo在國內有着非常大的用戶群體,但是其周邊設施與組件相對來說並不那麼完善(比如feign,ribbon等等)。很多開發者使用Dubbo,又希望享受Spring Cloud的生態,因此也會有一些Spring Cloud與Dubbo一起使用的案例與方法出現。

Spring Cloud Alibaba的出現,實現了Spring Cloud與Dubbo的完美融合。在之前的教程中,我們已經介紹過使用Spring Cloud Alibaba中的Nacos來作為服務註冊中心,並且在此之下可以如傳統的Spring Cloud應用一樣地使用Ribbon或Feign來實現服務消費。這篇,我們就來繼續說說Spring Cloud Alibaba 下額外支持的RPC方案:Dubbo

代碼實現

我們通過一個簡單的例子,使用Nacos做服務註冊中心,利用Dubbo來實現服務提供方與服務消費方。這裏省略Nacos的安裝與使用,下面就直接進入Dubbo的使用步驟。

定義 Dubbo 服務接口

創建 ali-nacos-dubbo-api 工程

Dubbo 服務接口是服務提供方與消費方的遠程通訊契約,通常由普通的 Java 接口(interface)來聲明,如 HelloService 接口:

public interface HelloService {
    String hello(String name);
}

為了確保契約的一致性,推薦的做法是將 Dubbo 服務接口打包在jar包中,如以上接口就存放在 ali-nacos-dubbo-api 之中。 對於服務提供方而言,不僅通過依賴 artifact 的形式引入 Dubbo 服務接口,而且需要將其實現。對應的服務消費端,同樣地需要依賴該 artifact, 並以接口調用的方式執行遠程方法。接下來進一步討論怎樣實現 Dubbo 服務提供方和消費方。

實現 Dubbo 服務提供方

創建 ali-nacos-dubbo-provider,端口:9001 工程

pom.xml配置

<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <parent>
        <artifactId>cloud-alibaba</artifactId>
        <groupId>com.easy</groupId>
        <version>1.0.0</version>
    </parent>

    <modelVersion>4.0.0</modelVersion>

    <artifactId>ali-nacos-dubbo-provider</artifactId>

    <dependencies>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-actuator</artifactId>
        </dependency>

        <!-- API -->
        <dependency>
            <groupId>com.easy</groupId>
            <artifactId>ali-nacos-dubbo-api</artifactId>
            <version>${project.version}</version>
        </dependency>

        <!--dubbo-->
        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-starter-dubbo</artifactId>
        </dependency>

        <!--nacos-->
        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
        </dependency>
    </dependencies>

    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
    </build>

</project>

bootstrap.yaml配置

dubbo:
  scan:
    # dubbo 服務掃描基準包
    base-packages: com.easy.andProvider.service

  #Dubbo 服務暴露的協議配置,其中子屬性 name 為協議名稱,port 為協議端口( -1 表示自增端口,從 20880 開始)
  protocol:
    name: dubbo
    port: -1

  #Dubbo 服務註冊中心配置,其中子屬性 address 的值 “spring-cloud://localhost”,說明掛載到 Spring Cloud 註冊中心
  registry:
    address: spring-cloud://localhost

spring:
  application:
    # Dubbo 應用名稱
    name: ali-nacos-dubbo-provider
  main:
    allow-bean-definition-overriding: true
  cloud:
    # Nacos 服務發現與註冊配置
    nacos:
      discovery:
        server-addr: 127.0.0.1:8848

Dubbo Spring Cloud 繼承了 Dubbo Spring Boot 的外部化配置特性,也可以通過標註 @DubboComponentScan 來實現基準包掃描。

實現 Dubbo 服務

HelloService 作為暴露的 Dubbo 服務接口,服務提供方 ali-nacos-dubbo-provider 需要將其實現:

package com.easy.andProvider.service;

import com.easy.and.api.service.HelloService;
import org.apache.dubbo.config.annotation.Service;

@Service
public class HelloServiceImpl implements HelloService {
    @Override
    public String hello(String name) {
        return "你好 " + name;
    }
}

import org.apache.dubbo.config.annotation.Service 是 Dubbo 服務註解,僅聲明該 Java 服務實現為 Dubbo 服務

貼上啟動類代碼:

@EnableDiscoveryClient
@EnableAutoConfiguration
public class AndProviderApplication {
    public static void main(String[] args) {
        SpringApplication.run(AndProviderApplication.class);
    }
}

實現 Dubbo 服務消費方

創建 ali-nacos-dubbo-consumer,端口:9103 工程

pom.xml依賴

<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <parent>
        <artifactId>cloud-alibaba</artifactId>
        <groupId>com.easy</groupId>
        <version>1.0.0</version>
    </parent>

    <modelVersion>4.0.0</modelVersion>

    <artifactId>ali-nacos-dubbo-consumer</artifactId>

    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-actuator</artifactId>
        </dependency>

        <dependency>
            <groupId>com.easy</groupId>
            <artifactId>ali-nacos-dubbo-api</artifactId>
            <version>${project.version}</version>
        </dependency>

        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-starter-dubbo</artifactId>
        </dependency>

        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
        </dependency>
    </dependencies>

    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
    </build>
</project>

yaml配置文件

dubbo:
  registry:
    address: spring-cloud://localhost
  cloud:
    subscribed-services: ali-nacos-dubbo-provider

spring:
  application:
    name: ali-nacos-dubbo-consumer
  main:
    allow-bean-definition-overriding: true
  cloud:
    nacos:
      discovery:
        server-addr: 127.0.0.1:8848

實現 Dubbo 服務消費方

HomeController.java

package com.easy.andConsumer;

import com.easy.and.api.service.HelloService;
import lombok.extern.slf4j.Slf4j;
import org.apache.dubbo.config.annotation.Reference;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@RestController
@Slf4j
public class HomeController {

    @Reference
    HelloService helloService;

    @GetMapping("/hello")
    public String hello(String name) {
        return helloService.hello("雲天");
    }
}

AndConsumerApplication.java啟動類

package com.easy.andConsumer;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.cloud.client.discovery.EnableDiscoveryClient;

@EnableDiscoveryClient
@SpringBootApplication
public class AndConsumerApplication {
    public static void main(String[] args) {
        SpringApplication.run(AndConsumerApplication.class, args);
    }
}

使用示例

示例關聯項目

本示例我們創建了三個項目實現

  • ali-nacos-dubbo-api:定義Dubbo服務接口工程

  • ali-nacos-dubbo-provider:Dubbo服務提供方並向nacos註冊服務,服務名:ali-nacos-dubbo-provider,端口:9001

  • ali-nacos-dubbo-consumer:Dubbo服務消費方並向nacos註冊服務,服務名:ali-nacos-dubbo-consumer,端口:9103

運行示例測試

首先要啟動服務註冊中心 nacos、ali-nacos-dubbo-provider服務及ali-nacos-dubbo-consumer服務

  • 訪問服務消費方地址: http://localhost:9103/hello

返回

你好 雲天

或者你也可以通過 curl 命令執行 HTTP GET 方法

$curl http://127.0.0.1:9103/hello

HTTP 響應為:

你好 雲天

以上結果說明應用 ali-nacos-dubbo-consumer 通過消費 Dubbo 服務,返回服務提供方 ali-nacos-dubbo-provider 運算后的內容。

以上我們完成了 Dubbo 服務提供方和消費方的入門運用,源代碼請直接參考模塊:

資料

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!
【控制系統数字仿真與CAD】實驗三:離散相似法数字仿真

一、實驗目的
  1. 了解離散相似法的基本原理
  2. 掌握離散相似法仿真的基本過程
  3. 應用離散相似法仿真非線性系統
  4. MATLAB實現離散相似法的非線性系統仿真
  5. 掌握SIMULINK仿真方法,應用於非線性系統的仿真,並對實驗結果進行分析比較

二、實驗原理

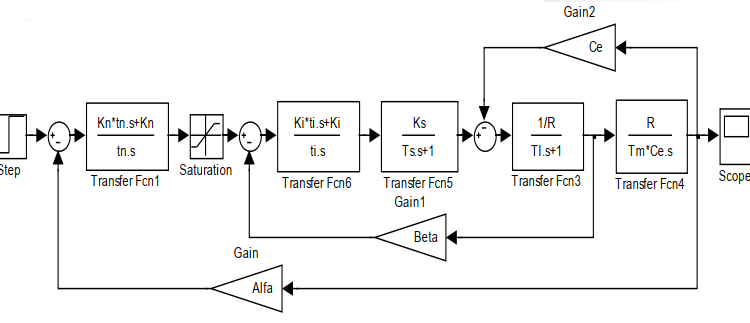
  在ASR的輸出增加限幅裝置(飽和非線性,飽和界為c=8 )。 Ce=0.031,其它參數不變。輸入為單位階躍,用離散相似法求系統各環節的輸出。

  要求:採用零階保持器和一階保持器離散化系統,分別完成本實驗。

  1、各環節的參數:

  由5個典型環節組成:

  A=[0 0 1 1 0];

  B=[tn ti Ts Tl Tm*Ce];
  C=[Kn Ki Ks 1/R R];
  D=[Kn*tn Ki*ti 0 0 0];

  還有一飽和非線性環節:c=8;

  2、各環節的離散化係數矩陣

 3、各環節的輸入作用


    (1)、u(n)可通過聯接矩陣直接求得: 


      u(n)=[u1(n), u2(n),…,un(n)]為各環節的輸入量, n為環節數。 Y(n)=[Y1(n), Y2(n),…,Yn(n)]為各環節的輸出量, r為外中參考輸入量。

    (2)、U(n)由近似表達式求得:
      

    (3)、u(n+1)用折線法近似求得:


  4、狀態和輸出計算

    (1)、一階保持器
      X=FI’.*X+FIM’.*Uk+FIJ’.*Udot;
      Y=FIC’.*X+FID’.*Uf;
    (2)、零階保持器
      X=FI’.*X+FIM’.*Uk;
      Y=FIC’.*X+FID’.*Uf;

  5、飽和非線性環節

  看作環節1(ASR)的一部分。建立satur.m文件:

function [uo]=satur(ui,c)
    if (abs(ui)<=c)
        uo=ui;
    elseif ( ui > c )
        uo = c;
    else
        uo=-c;
    end
end

 三、實驗過程

  1、新建腳本文件,命名為satur.m

function [uo]=satur(ui,c)
    if (abs(ui)<=c)
        uo=ui;
    elseif ( ui > c )
        uo = c;
    else
        uo=-c;
    end
end

  2、新建腳本文件,命名為test3.m

  完整代碼:

clc;
clear;
% ******  各環節參數  ****** %
Kn=26.7;
tn=0.03;
Ki=0.269;
ti=0.067;
Ks=76;
Ts=0.00167;
R=6.58;
T1=0.018;
Tm=0.25;
Ce=0.031;
Alpha=0.00337;
Beta=0.4;
A=[0 0 1 1 0];
B=[tn ti Ts T1 Tm*Ce];
C=[Kn Ki Ks 1/R R];
D=[Kn*tn Ki*ti 0 0 0];
c=8;
r=1;
W=[0 0 0 0 -Alpha;
    1 0 0 -Beta 0;
    0 1 0 0 0;
    0 0 1 0 -Ce;
    0 0 0 1 0];
W0=[1 0 0 0 0]';
h=0.001;
t_end=0.5;
t=0:h:t_end;
n=length(t);
% ******  各環節離散化係數  ****** %
block_num=5;
for k=1:block_num
    if(A(k)==0)
        FI(k)=1;
        FIM(k)=h*C(k)/B(k);
        FIJ(k)=h*h*C(k)/B(k)/2;
        FIC(k)=1;
        FID(k)=0;
        if(D(k)~=0)
            FID(k)=D(k)/B(k);
        end
    else
        FI(k)=exp(-h*A(k)/B(k));
        FIM(k)=(1-FI(k))*C(k)/A(k);
        FIJ(k)=h*C(k)/A(k)-FIM(k)*B(k)/A(k);
        FIC(k)=1;
        FID(k)=0;
        if(D(k)~=0)
            FIC(k)=C(k)/D(k)-A(k)/B(k);
            FID(k)=D(k)/B(k);
        end
    end
end

Y0=[0 0 0 0 0]';
Y=Y0;
X=zeros(block_num,1);
result1=Y;
Uk=zeros(block_num,1);
Ub=Uk;

for m=1:(n-1)
    Ub=Uk;
    Uk=W*Y+W0*r;
    Uf=2*Uk-Ub;
    Udot=(Uk-Ub)/h;
    
    %******  零階保持器  ******%
    X=FI'.*X+FIM'.*Uk;
    Y=FIC'.*X+FID'.*Uf;
    
    Y(1)=satur(Y(1),c);
    result1=[result1,Y];
end

Y0=[0 0 0 0 0]';
Y=Y0;
X=zeros(block_num,1);
result2=Y;
Uk=zeros(block_num,1);
Ub=Uk;
for m=1:(n-1)
    Ub=Uk;
    Uk=W*Y+W0*r;
    Uf=2*Uk-Ub;
    Udot=(Uk-Ub)/h;
    
    %******  一階保持器  ******%
    X=FI'.*X+FIM'.*Uk + FIJ'.*Udot;
    Y=FIC'.*X + FID'.*Uf;
    
    Y(1)=satur(Y(1),c);
    result2=[result2,Y];
end

plot(t,result1(5,:),’-.’,t,result2(5,:),’–‘,t,ScopeData.signals.values,’k’);
legend(‘零階保持器’,’一階保持器’,’Simulink’);

  3、在Simulink中繪製仿真圖


 注意:Simulink中的變量名和工作區變量關聯方法請點擊:https://www.cnblogs.com/KaifengGuan/p/11942615.html

四、實驗結果


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!
【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

Docker-Compose基礎與實戰,看這一篇就夠了

what & why

Compose 項目是 Docker 官方的開源項目,負責實現對 Docker 容器集群的快速編排。使用前面介紹的Dockerfile我們很容易定義一個單獨的應用容器。然而在日常開發工作中,經常會碰到需要多個容器相互配合來完成某項任務的情況。例如要實現一個 Web 項目,除了 Web 服務容器本身,往往還需要再加上後端的數據庫服務容器;再比如在分佈式應用一般包含若干個服務,每個服務一般都會部署多個實例。如果每個服務都要手動啟停,那麼效率之低、維護量之大可想而知。這時候就需要一個工具能夠管理一組相關聯的的應用容器,這就是Docker Compose。
Compose有2個重要的概念

  • 項目(Project):由一組關聯的應用容器組成的一個完整業務單元,在 docker-compose.yml 文件中定義。
  • 服務(Service):一個應用的容器,實際上可以包括若干運行相同鏡像的容器實例。

docker compose 安裝與卸載

安裝

二進制包在線安裝

curl -L https://github.com/docker/compose/releases/download/1.25.0/docker-compose-`uname -s`-`uname -m` -o /usr/local/bin/docker-compose 

sudo chmod +x /usr/local/bin/docker-compose

這個方法現在基本行不通,下載太慢了,不推薦使用。

二進制包離線安裝

從https://github.com/docker/compose/releases/download/1.25.0/docker-compose-Linux-x86_64下載對應的安裝包,比如我下載了Linux-x86_64的。

將下載好的安裝包剪切到/usr/local/bin/docker-compose目錄下
mv /app/download/docker-compose-Linux-x86_64 /usr/local/bin/docker-compose

添加執行權限
sudo chmod +x /usr/local/bin/docker-compose

pip安裝

  • 先安裝好pip工具
#安裝依賴 
yum -y install epel-release 
#安裝PIP 
yum -y install python-pip 
#升級PIP 
pip install --upgrade pip
  • 驗證pip 版本
[root@tymonitor bin]# pip --version
pip 8.1.2 from /usr/lib/python2.7/site-packages (python 2.7)
  • 安裝docker compose
    pip install -U docker-compose==1.25.0

  • 驗證docker compose版本
[root@tymonitor bin]# docker-compose --version
docker-compose version 1.25.0, build b42d419

安裝補全插件

curl -L https://raw.githubusercontent.com/docker/compose/1.25.0/contrib/completion/bash/docker-compose > /etc/bash_completion.d/docker-compose

卸載

二進制卸載

rm /usr/local/bin/docker-compose

pip卸載

pip uninstall docker-compose

docker compose 重要命令

命令選項

  • -f, –file FILE 指定使用的 Compose 模板文件,默認為 docker-compose.yml,可以多次指定。
  • -p, –project-name NAME 指定項目名稱,默認將使用所在目錄名稱作為項目名。
  • –x-networking 使用 Docker 的可拔插網絡後端特性
  • –x-network-driver DRIVER 指定網絡後端的驅動,默認為 bridge
  • –verbose 輸出更多調試信息。
  • -v, –version 打印版本並退出。

常用&重要命令

  • config
    驗證 Compose 文件格式是否正確,若正確則显示配置,若格式錯誤显示錯誤原因。
    如:docker-compose -f skywalking.yml config
    此命令不會執行真正的操作,而是显示 docker-compose 程序解析到的配置文件內容:

  • images
    列出 Compose 文件中包含的鏡像。如docker-compose -f skywalking.yml images

  • ps
    列出項目中目前的所有容器。如docker-compose -f skywalking.yml ps

  • build
    構建(重新構建)項目中的服務容器。如:docker-compose -f skywalking.yml build,一般搭配自定義鏡像,比如編寫的Dockfile,功能類似於docker build .

  • up
    該命令十分強大(重點掌握),它將嘗試自動完成包括構建鏡像,(重新)創建服務,啟動服務,並關聯服務相關容器的一系列操作。如docker-compose -f skywalking.yml up。默認情況,docker-compose up 啟動的容器都在前台,控制台將會同時打印所有容器的輸出信息,可以很方便進行調試。

    如果使用docker-compose up -d將會在後台啟動並運行所有的容器。一般推薦生產環境下使用該選項。
    默認情況,如果服務容器已經存在,docker-compose up 將會嘗試停止容器,然後重新創建(保持使用 volumes-from 掛載的卷),以保證新啟動的服務匹配 docker-compose.yml 文件的最新內容。如果用戶不希望容器被停止並重新創建,可以使用 docker-compose up --no-recreate。這樣將只會啟動處於停止狀態的容器,而忽略已經運行的服務。如果用戶只想重新部署某個服務,可以使用 docker-compose up --no-deps -d <SERVICE_NAME> 來重新創建服務並後台停止舊服務,啟動新服務,並不會影響到其所依賴的服務。此命令有如下選項:
    ①:-d 在後台運行服務容器。
    ②:--no-color 不使用顏色來區分不同的服務的控制台輸出。
    ③:--no-deps 不啟動服務所鏈接的容器。
    ④:--force-recreate 強制重新創建容器,不能與 –no-recreate 同時使用。
    ⑤:--no-recreate 如果容器已經存在了,則不重新創建,不能與 –force-recreate 同時使用。
    ⑥:--no-build 不自動構建缺失的服務鏡像。
    ⑦:-t, --timeout TIMEOUT 停止容器時候的超時(默認為 10 秒)。

  • down
    此命令停止用up命令所啟動的容器並移除網絡,如docker-compose -f skywalking.yml down

  • stop
    格式為 docker-compose stop [options] [SERVICE...]
    停止已經處於運行狀態的容器,但不刪除它。通過 docker-compose start 可以再次啟動這些容器,如果不指定service則默認停止所有的容器。如docker-compose -f skywalking.yml stop elasticsearch
    選項:
    -t, --timeout TIMEOUT 停止容器時候的超時(默認為 10 秒)。

  • start
    啟動已經存在的服務容器。用法跟上面的stop剛好相反,如docker-compose -f skywalking.yml start elasticsearch

  • restart
    重啟項目中的服務。用法跟上面的stop,start一樣

  • logs
    格式為docker-compose logs [options] [SERVICE...]
    查看服務容器的輸出。默認情況下,docker-compose 將對不同的服務輸出使用不同的顏色來區分。可以通過 –no-color 來關閉顏色。該命令在調試問題的時候十分有用。如docker-compose -f skywalking.yml logs 查看整體的日誌,docker-compose -f skywalking.yml logs elasticsearch 查看單獨容器的日誌

docker compose 模板文件

模板文件是使用 Compose 的核心,涉及到的指令關鍵字也比較多。本文主要列出幾個常見&重要的指令,其他指令大家可以自行百度。
默認的模板文件名稱為 docker-compose.yml,格式為 YAML 格式。

version: '3'
services:
  elasticsearch:
    image: elasticsearch:6.8.5
    container_name: elasticsearch
    restart: always
    volumes:
      - /app/skywalking/elasticsearch/data:/usr/share/elasticsearch/data:rw
      - /app/skywalking/elasticsearch/conf/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
      - /app/skywalking/elasticsearch/conf/jvm.options:/usr/share/elasticsearch/config/jvm.options
      - /app/skywalking/elasticsearch/logs:/usr/share/elasticsearch/logs:rw
    environment:
      - TZ=Asia/Shanghai
      - xpack.monitoring.enabled=false
      - xpack.watcher.enabled=false
    ports:
      - "9200:9200"
      - "9300:9300"

注意每個服務都必須通過 image 指令指定鏡像或 build 指令(需要 Dockerfile)等來自動構建生成鏡像。如果使用 build 指令,在 Dockerfile 中設置的選項(例如:CMD, EXPOSE, VOLUME, ENV 等) 將會自動被獲取,無需在 docker-compose.yml 中重複設置。

常用&重要命令

  • images
    指定為鏡像名稱或鏡像 ID。如果鏡像在本地不存在,Compose 將會嘗試拉取這個鏡像。
image: apache/skywalking-oap-server:6.5.0
image: apache/skywalking-ui:6.5.0
  • ports
    暴露端口信息。
    使用宿主端口:容器端口 (HOST:CONTAINER) 格式,或者僅僅指定容器的端口(宿主將會隨機選擇端口)都可以,端口字符串都使用引號包括起來的字符串格式。
ports: 
    - "3000" 
    - "8080:8080" 
    - "127.0.0.1:8001:8001"
  • volumes
    數據卷所掛載路徑設置。可以設置為宿主機路徑(HOST:CONTAINER)或者數據卷名稱(VOLUME:CONTAINER),並且可以設置訪問模式 (HOST:CONTAINER:ro)。
volumes:
      - /app/skywalking/elasticsearch/data:/usr/share/elasticsearch/data:rw
      - conf/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
version: "3"
services:
  my_src:
    image: mysql:8.0
    volumes:
      - mysql_data:/var/lib/mysql
volumes:
  mysql_data:
  • ulimits
    指定容器的 ulimits 限制值。
    例如,指定最大進程數為 65535,指定文件句柄數為 20000(軟限制,應用可以隨時修改,不能超過硬限制) 和 40000(系統硬限制,只能 root 用戶提高)。
ulimits:
   nproc: 65535
   nofile:
     soft: 20000
     hard: 40000
  • depends_on
    解決容器的依賴、啟動先後的問題。以下例子中會先啟動 redis mysql 再啟動 web
version: '3'
services:
  web:
    build: .
    depends_on:
      - db
      - redis     
  redis:
    image: redis    
  db:
    image: mysql
  • environment
    設置環境變量。你可以使用數組或字典兩種格式。
environment:
      SW_STORAGE: elasticsearch
      SW_STORAGE_ES_CLUSTER_NODES: elasticsearch:9200
      
environment:
      - SW_STORAGE= elasticsearch
      - SW_STORAGE_ES_CLUSTER_NODES=elasticsearch:9200
  • restart
    指定容器退出后的重啟策略為始終重啟。該命令對保持服務始終運行十分有效,在生產環境中推薦配置為 always 或者 unless-stopped。
    restart: always

docker-compose 實戰

首先我需要推薦兩件事:

  • 配置docker加速鏡像
    創建或修改/etc/docker/daemon.json
sudo mkdir -p /etc/docker
sudo tee /etc/docker/daemon.json <<-'EOF'
{
    "registry-mirrors": [
        "https://hub-mirror.c.163.com",
        "https://mirror.ccs.tencentyun.com",
        "https://reg-mirror.qiniu.co"
    ]
}
EOF
sudo systemctl daemon-reload
sudo systemctl restart docker
  • 給你的ide工具裝上docker插件

本次實戰我們以docker-compose部署skywalking為例。編寫skywalking.yml,內容如下。

version: '3.3'
services:
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:6.8.5
    container_name: elasticsearch
    restart: always
    ports:
      - 9200:9200
      - 9300:9300
    environment:
      discovery.type: single-node
    ulimits:
      memlock:
        soft: -1
        hard: -1
  oap:
    image: skywalking/oap
    container_name: oap
    depends_on:
      - elasticsearch
    links:
      - elasticsearch
    restart: always
    ports:
      - 11800:11800
      - 12800:12800
    environment:
      SW_STORAGE: elasticsearch
      SW_STORAGE_ES_CLUSTER_NODES: elasticsearch:9200
  ui:
    image: skywalking/ui
    container_name: ui
    depends_on:
      - oap
    links:
      - oap
    restart: always
    ports:
      - 8080:8080
    environment:
      SW_OAP_ADDRESS: oap:12800

部署完成后將其上傳至服務器,執行docker-compose -f /app/skywalking.yml up -d即可。

個人公眾號:JAVA日知錄 ,

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

設計模式之美學習(九):業務開發常用的基於貧血模型的MVC架構違背OOP嗎?

我們都知道,很多業務系統都是基於 MVC 三層架構來開發的。實際上,更確切點講,這是一種基於貧血模型的 MVC 三層架構開發模式。

雖然這種開發模式已經成為標準的 Web 項目的開發模式,但它卻違反了面向對象編程風格,是一種徹徹底底的面向過程的編程風格,因此而被有些人稱為反模式(anti-pattern)。特別是領域驅動設計(Domain Driven Design,簡稱 DDD)盛行之後,這種基於貧血模型的傳統的開發模式就更加被人詬病。而基於充血模型的 DDD 開發模式越來越被人提倡。

基於上面的描述,我們先搞清楚下面幾個問題:

  • 什麼是貧血模型?什麼是充血模型?
  • 為什麼說基於貧血模型的傳統開發模式違反 OOP?
  • 基於貧血模型的傳統開發模式既然違反 OOP,那又為什麼如此流行?
  • 什麼情況下我們應該考慮使用基於充血模型的 DDD 開發模式?

什麼是基於貧血模型的傳統開發模式?

對於大部分的後端開發工程師來說,MVC 三層架構都不會陌生。

MVC 三層架構中的 M 表示 Model,V 表示 View,C 表示 Controller。它將整個項目分為三層:展示層、邏輯層、數據層。MVC 三層開發架構是一個比較籠統的分層方式,落實到具體的開發層面,很多項目也並不會 100% 遵從 MVC 固定的分層方式,而是會根據具體的項目需求,做適當的調整。

比如,現在很多 Web 或者 App 項目都是前後端分離的,後端負責暴露接口給前端調用。這種情況下,我們一般就將後端項目分為 Repository 層、Service 層、Controller 層。其中,Repository 層負責數據訪問,Service 層負責業務邏輯,Controller 層負責暴露接口。當然,這隻是其中一種分層和命名方式。不同的項目、不同的團隊,可能會對此有所調整。不過,萬變不離其宗,只要是依賴數據庫開發的 Web 項目,基本的分層思路都大差不差。

再來看一下,什麼是貧血模型?

目前幾乎所有的業務後端系統,都是基於貧血模型的。舉一個簡單的例子來解釋一下。

////////// Controller+VO(View Object) //////////
public class UserController {
  private UserService userService; //通過構造函數或者IOC框架注入
  
  public UserVo getUserById(Long userId) {
    UserBo userBo = userService.getUser(userId);
    UserVo userVo = [...convert userBo to userVo...];
    return userVo;
  }
}

public class UserVo {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

////////// Service+BO(Business Object) //////////
public class UserService {
  private UserRepository userRepository; //通過構造函數或者IOC框架注入
  
  public UserBo getUserById(Long userId) {
    UserEntity userEntity = userRepository.getUserById(userId);
    UserBo userBo = [...convert userEntity to userBo...];
    return userBo;
  }
}

public class UserBo {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

////////// Repository+Entity //////////
public class UserRepository {
  public UserEntity getUserById(Long userId) { //... }
}

public class UserEntity {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

平時開發 Web 後端項目的時候,基本上都是這麼組織代碼的。其中,UserEntity 和 UserRepository 組成了數據訪問層,UserBo 和 UserService 組成了業務邏輯層,UserVo 和 UserController 在這裏屬於接口層。

從代碼中可以發現,UserBo 是一個純粹的數據結構,只包含數據,不包含任何業務邏輯。業務邏輯集中在 UserService 中。我們通過 UserService 來操作 UserBo。換句話說,Service 層的數據和業務邏輯,被分割為 BO 和 Service 兩個類中。像 UserBo 這樣,只包含數據,不包含業務邏輯的類,就叫作貧血模型(Anemic Domain Model)。同理,UserEntity、UserVo 都是基於貧血模型設計的。這種貧血模型將數據與操作分離,破壞了面向對象的封裝特性,是一種典型的面向過程的編程風格。

什麼是基於充血模型的 DDD 開發模式?

首先,我們先來看一下,什麼是充血模型?

在貧血模型中,數據和業務邏輯被分割到不同的類中。充血模型(Rich Domain Model)正好相反,數據和對應的業務邏輯被封裝到同一個類中。因此,這種充血模型滿足面向對象的封裝特性,是典型的面向對象編程風格。

接下來,再來看一下,什麼是領域驅動設計?

領域驅動設計,即 DDD,主要是用來指導如何解耦業務系統,劃分業務模塊,定義業務領域模型及其交互。領域驅動設計這個概念並不新穎,早在 2004 年就被提出了,到現在已經有十幾年的歷史了。不過,它被大眾熟知,還是基於另一個概念的興起,那就是微服務。

除了監控、調用鏈追蹤、API 網關等服務治理系統的開發之外,微服務還有另外一個更加重要的工作,那就是針對公司的業務,合理地做微服務拆分。而領域驅動設計恰好就是用來指導劃分服務的。所以,微服務加速了領域驅動設計的盛行。

領域驅動設計有點兒類似敏捷開發、SOA、PAAS 等概念,聽起來很高大上,但實際上只值“五分錢”。即便你沒有聽說過領域驅動設計,對這個概念一無所知,只要你是在開發業務系統,也或多或少都在使用它。做好領域驅動設計的關鍵是,看你對自己所做業務的熟悉程度,而並不是對領域驅動設計這個概念本身的掌握程度。即便你對領域驅動搞得再清楚,但是對業務不熟悉,也並不一定能做出合理的領域設計。所以,不要把領域驅動設計當銀彈,不要花太多的時間去過度地研究它。

實際上,基於充血模型的 DDD 開發模式實現的代碼,也是按照 MVC 三層架構分層的。Controller 層還是負責暴露接口,Repository 層還是負責數據存取,Service 層負責核心業務邏輯。它跟基於貧血模型的傳統開發模式的區別主要在 Service 層。

在基於貧血模型的傳統開發模式中,Service 層包含 Service 類和 BO 類兩部分,BO 是貧血模型,只包含數據,不包含具體的業務邏輯。業務邏輯集中在 Service 類中。在基於充血模型的 DDD 開發模式中,Service 層包含 Service 類和 Domain 類兩部分。Domain 就相當於貧血模型中的 BO。不過,Domain 與 BO 的區別在於它是基於充血模型開發的,既包含數據,也包含業務邏輯。而 Service 類變得非常單薄。總結一下的話就是,基於貧血模型的傳統的開發模式,重 Service 輕 BO;基於充血模型的 DDD 開發模式,輕 Service 重 Domain。

為什麼基於貧血模型的傳統開發模式如此受歡迎?

基於貧血模型的傳統開發模式,將數據與業務邏輯分離,違反了 OOP 的封裝特性,實際上是一種面向過程的編程風格。但是,現在幾乎所有的 Web 項目,都是基於這種貧血模型的開發模式,甚至連 Java Spring 框架的官方 demo,都是按照這種開發模式來編寫的。

面向過程編程風格有種種弊端,比如,數據和操作分離之後,數據本身的操作就不受限制了。任何代碼都可以隨意修改數據。既然基於貧血模型的這種傳統開發模式是面向過程編程風格的,那它又為什麼會被廣大程序員所接受呢?

第一點原因是,大部分情況下,我們開發的系統業務可能都比較簡單,簡單到就是基於 SQL 的 CRUD 操作,所以,我們根本不需要動腦子精心設計充血模型,貧血模型就足以應付這種簡單業務的開發工作。除此之外,因為業務比較簡單,即便我們使用充血模型,那模型本身包含的業務邏輯也並不會很多,設計出來的領域模型也會比較單薄,跟貧血模型差不多,沒有太大意義。

第二點原因是,充血模型的設計要比貧血模型更加有難度。因為充血模型是一種面向對象的編程風格。我們從一開始就要設計好針對數據要暴露哪些操作,定義哪些業務邏輯。而不是像貧血模型那樣,我們只需要定義數據,之後有什麼功能開發需求,我們就在 Service 層定義什麼操作,不需要事先做太多設計。

第三點原因是,思維已固化,轉型有成本。基於貧血模型的傳統開發模式經歷了這麼多年,已經深得人心、習以為常。你隨便問一個旁邊的大齡同事,基本上他過往參与的所有 Web 項目應該都是基於這個開發模式的,而且也沒有出過啥大問題。如果轉向用充血模型、領域驅動設計,那勢必有一定的學習成本、轉型成本。很多人在沒有遇到開發痛點的情況下,是不願意做這件事情的。

什麼項目應該考慮使用基於充血模型的 DDD 開發模式?

基於貧血模型的傳統的開發模式,比較適合業務比較簡單的系統開發。相對應的,基於充血模型的 DDD 開發模式,更適合業務複雜的系統開發。比如,包含各種利息計算模型、還款模型等複雜業務的金融系統。

這兩種開發模式,落實到代碼層面,區別不就是一個將業務邏輯放到 Service 類中,一個將業務邏輯放到 Domain 領域模型中嗎?為什麼基於貧血模型的傳統開發模式,就不能應對複雜業務系統的開發?而基於充血模型的 DDD 開發模式就可以呢?

實際上,除了我們能看到的代碼層面的區別之外(一個業務邏輯放到 Service 層,一個放到領域模型中),還有一個非常重要的區別,那就是兩種不同的開發模式會導致不同的開發流程。基於充血模型的 DDD 開發模式的開發流程,在應對複雜業務系統的開發的時候更加有優勢。為什麼這麼說呢?先來回憶一下,我們平時基於貧血模型的傳統的開發模式,都是怎麼實現一個功能需求的。

不誇張地講,我們平時的開發,大部分都是 SQL 驅動(SQL-Driven)的開發模式。我們接到一個後端接口的開發需求的時候,就去看接口需要的數據對應到數據庫中,需要哪張表或者哪幾張表,然後思考如何編寫 SQL 語句來獲取數據。之後就是定義 Entity、BO、VO,然後模板式地往對應的 Repository、Service、Controller 類中添加代碼。

業務邏輯包裹在一個大的 SQL 語句中,而 Service 層可以做的事情很少。SQL 都是針對特定的業務功能編寫的,復用性差。當我要開發另一個業務功能的時候,只能重新寫個滿足新需求的 SQL 語句,這就可能導致各種長得差不多、區別很小的 SQL 語句滿天飛。

所以,在這個過程中,很少有人會應用領域模型、OOP 的概念,也很少有代碼復用意識。對於簡單業務系統來說,這種開發方式問題不大。但對於複雜業務系統的開發來說,這樣的開發方式會讓代碼越來越混亂,最終導致無法維護。

如果我們在項目中,應用基於充血模型的 DDD 的開發模式,那對應的開發流程就完全不一樣了。在這種開發模式下,我們需要事先理清楚所有的業務,定義領域模型所包含的屬性和方法。領域模型相當於可復用的業務中間層。新功能需求的開發,都基於之前定義好的這些領域模型來完成。

越複雜的系統,對代碼的復用性、易維護性要求就越高,我們就越應該花更多的時間和精力在前期設計上。而基於充血模型的 DDD 開發模式,正好需要我們前期做大量的業務調研、領域模型設計,所以它更加適合這種複雜系統的開發。

重點回顧

平時做 Web 項目的業務開發,大部分都是基於貧血模型的 MVC 三層架構,這裏把它稱為傳統的開發模式。之所以稱之為“傳統”,是相對於新興的基於充血模型的 DDD 開發模式來說的。基於貧血模型的傳統開發模式,是典型的面向過程的編程風格。相反,基於充血模型的 DDD 開發模式,是典型的面向對象的編程風格。

不過,DDD 也並非銀彈。對於業務不複雜的系統開發來說,基於貧血模型的傳統開發模式簡單夠用,基於充血模型的 DDD 開發模式有點大材小用,無法發揮作用。相反,對於業務複雜的系統開發來說,基於充血模型的 DDD 開發模式,因為前期需要在設計上投入更多時間和精力,來提高代碼的復用性和可維護性,所以相比基於貧血模型的開發模式,更加有優勢。

思考

  • 對於舉的例子中,UserEntity、UserBo、UserVo 包含的字段都差不多,是否可以合併為一個類呢?

參考:

本文由博客一文多發平台 發布!
更多內容請點擊我的博客

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

RocketMQ一個新的消費組初次啟動時從何處開始消費呢?

目錄

@(本文目錄)

1、拋出問題

一個新的消費組訂閱一個已存在的Topic主題時,消費組是從該Topic的哪條消息開始消費呢?

首先翻閱DefaultMQPushConsumer的API時,setConsumeFromWhere(ConsumeFromWhere consumeFromWhere)API映入眼帘,從字面意思來看是設置消費者從哪裡開始消費,正是解開該問題的”鑰匙“。ConsumeFromWhere枚舉類圖如下:

  • CONSUME_FROM_MAX_OFFSET
    從消費隊列最大的偏移量開始消費。
  • CONSUME_FROM_FIRST_OFFSET
    從消費隊列最小偏移量開始消費。
  • CONSUME_FROM_TIMESTAMP
    從指定的時間戳開始消費,默認為消費者啟動之前的30分鐘處開始消費。可以通過DefaultMQPushConsumer#setConsumeTimestamp。

是不是點小激動,還不快試試。

需求:新的消費組啟動時,從隊列最後開始消費,即只消費啟動后發送到消息服務器后的最新消息。

1.1 環境準備

本示例所用到的Topic路由信息如下:

Broker的配置如下(broker.conf)

brokerClusterName = DefaultCluster
brokerName = broker-a
brokerId = 0
deleteWhen = 04
fileReservedTime = 48
brokerRole = ASYNC_MASTER
flushDiskType = ASYNC_FLUSH

storePathRootDir=E:/SH2019/tmp/rocketmq_home/rocketmq4.5_simple/store
storePathCommitLog=E:/SH2019/tmp/rocketmq_home/rocketmq4.5_simple/store/commitlog
namesrvAddr=127.0.0.1:9876
autoCreateTopicEnable=false
mapedFileSizeCommitLog=10240
mapedFileSizeConsumeQueue=2000

其中重點修改了如下兩個參數:

  • mapedFileSizeCommitLog
    單個commitlog文件的大小,這裏使用10M,方便測試用。
  • mapedFileSizeConsumeQueue
    單個consumequeue隊列長度,這裏使用1000,表示一個consumequeue文件中包含1000個條目。

1.2 消息發送者代碼

public static void main(String[] args) throws MQClientException, InterruptedException {
    DefaultMQProducer producer = new DefaultMQProducer("please_rename_unique_group_name");
    producer.setNamesrvAddr("127.0.0.1:9876");
    producer.start();
    for (int i = 0; i < 300; i++) {
        try {
            Message msg = new Message("TopicTest" ,"TagA" , ("Hello RocketMQ " + i).getBytes(RemotingHelper.DEFAULT_CHARSET));
            SendResult sendResult = producer.send(msg);
            System.out.printf("%s%n", sendResult);
        } catch (Exception e) {
            e.printStackTrace();
            Thread.sleep(1000);
        }
    }
    producer.shutdown();
}

通過上述,往TopicTest發送300條消息,發送完畢后,RocketMQ Broker存儲結構如下:

1.3 消費端驗證代碼

public static void main(String[] args) throws InterruptedException, MQClientException {
    DefaultMQPushConsumer consumer = new DefaultMQPushConsumer("my_consumer_01");
    consumer.setConsumeFromWhere(ConsumeFromWhere.CONSUME_FROM_LAST_OFFSET);
    consumer.subscribe("TopicTest", "*");
    consumer.setNamesrvAddr("127.0.0.1:9876");
    consumer.registerMessageListener(new MessageListenerConcurrently() {
        @Override
        public ConsumeConcurrentlyStatus consumeMessage(List<MessageExt> msgs,
            ConsumeConcurrentlyContext context) {
            System.out.printf("%s Receive New Messages: %s %n", Thread.currentThread().getName(), msgs);
            return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;
        }
    });
    consumer.start();
    System.out.printf("Consumer Started.%n");
}

執行上述代碼后,按照期望,應該是不會消費任何消息,只有等生產者再發送消息后,才會對消息進行消費,事實是這樣嗎?執行效果如圖所示:

令人意外的是,竟然從隊列的最小偏移量開始消費了,這就“尷尬”了。難不成是RocketMQ的Bug。帶着這個疑問,從源碼的角度嘗試來解讀該問題,並指導我們實踐。

2、探究CONSUME_FROM_MAX_OFFSET實現原理

對於一個新的消費組,無論是集群模式還是廣播模式都不會存儲該消費組的消費進度,可以理解為-1,此時就需要根據DefaultMQPushConsumer#consumeFromWhere屬性來決定其從何處開始消費,首先我們需要找到其對應的處理入口。我們知道,消息消費者從Broker服務器拉取消息時,需要進行消費隊列的負載,即RebalanceImpl。

溫馨提示:本文不會詳細介紹RocketMQ消息隊列負載、消息拉取、消息消費邏輯,只會展示出通往該問題的簡短流程,如想詳細了解消息消費具體細節,建議購買筆者出版的《RocketMQ技術內幕》書籍。

RebalancePushImpl#computePullFromWhere

public long computePullFromWhere(MessageQueue mq) {
        long result = -1;                                                                                                                                                                                                                  // @1
        final ConsumeFromWhere consumeFromWhere = this.defaultMQPushConsumerImpl.getDefaultMQPushConsumer().getConsumeFromWhere();    
        final OffsetStore offsetStore = this.defaultMQPushConsumerImpl.getOffsetStore();
        switch (consumeFromWhere) {
            case CONSUME_FROM_LAST_OFFSET_AND_FROM_MIN_WHEN_BOOT_FIRST:
            case CONSUME_FROM_MIN_OFFSET:
            case CONSUME_FROM_MAX_OFFSET:
            case CONSUME_FROM_LAST_OFFSET: {                                                                                                                                                                // @2
               // 省略部分代碼
                break;
            }
            case CONSUME_FROM_FIRST_OFFSET: {                                                                                                                                                              // @3
                // 省略部分代碼
                break;
            }
            case CONSUME_FROM_TIMESTAMP: {                                                                                                                                                                  //@4
                // 省略部分代碼
                break;
            }
            default:
                break;
        }
        return result;                                                                                                                                                                                                                  // @5
    }

代碼@1:先解釋幾個局部變量。

  • result
    最終的返回結果,默認為-1。
  • consumeFromWhere
    消息消費者開始消費的策略,即CONSUME_FROM_LAST_OFFSET等。
  • offsetStore
    offset存儲器,消費組消息偏移量存儲實現器。

代碼@2:CONSUME_FROM_LAST_OFFSET(從隊列的最大偏移量開始消費)的處理邏輯,下文會詳細介紹。

代碼@3:CONSUME_FROM_FIRST_OFFSET(從隊列最小偏移量開始消費)的處理邏輯,下文會詳細介紹。

代碼@4:CONSUME_FROM_TIMESTAMP(從指定時間戳開始消費)的處理邏輯,下文會詳細介紹。

代碼@5:返回最後計算的偏移量,從該偏移量出開始消費。

2.1 CONSUME_FROM_LAST_OFFSET計算邏輯

case CONSUME_FROM_LAST_OFFSET: {
    long lastOffset = offsetStore.readOffset(mq, ReadOffsetType.READ_FROM_STORE);   // @1
    if (lastOffset >= 0) {                                                                                                             // @2
        result = lastOffset;
    }
    // First start,no offset
    else if (-1 == lastOffset) {                                                                                                  // @3
        if (mq.getTopic().startsWith(MixAll.RETRY_GROUP_TOPIC_PREFIX)) {               
            result = 0L;
        } else {
            try {
                result = this.mQClientFactory.getMQAdminImpl().maxOffset(mq);                     
            } catch (MQClientException e) {                                                                              // @4
                result = -1;
            }
        }
    } else {
        result = -1;    
    }
    break;
}

代碼@1:使用offsetStore從消息消費進度文件中讀取消費消費進度,本文將以集群模式為例展開。稍後詳細分析。

代碼@2:如果返回的偏移量大於等於0,則直接使用該offset,這個也能理解,大於等於0,表示查詢到有效的消息消費進度,從該有效進度開始消費,但我們要特別留意lastOffset為0是什麼場景,因為返回0,並不會執行CONSUME_FROM_LAST_OFFSET(語義)。

代碼@3:如果lastOffset為-1,表示當前並未存儲其有效偏移量,可以理解為第一次消費,如果是消費組重試主題,從重試隊列偏移量為0開始消費;如果是普通主題,則從隊列當前的最大的有效偏移量開始消費,即CONSUME_FROM_LAST_OFFSET語義的實現。

代碼@4:如果從遠程服務拉取最大偏移量拉取異常或其他情況,則使用-1作為第一次拉取偏移量。

分析,上述執行的現象,雖然設置的是CONSUME_FROM_LAST_OFFSET,但現象是從隊列的第一條消息開始消費,根據上述源碼的分析,只有從消費組消費進度存儲文件中取到的消息偏移量為0時,才會從第一條消息開始消費,故接下來重點分析消息消費進度存儲器(OffsetStore)在什麼情況下會返回0。

接下來我們將以集群模式來查看一下消息消費進度的查詢邏輯,集群模式的消息進度存儲管理器實現為:
RemoteBrokerOffsetStore,最終Broker端的命令處理類為:ConsumerManageProcessor。

ConsumerManageProcessor#queryConsumerOffset
private RemotingCommand queryConsumerOffset(ChannelHandlerContext ctx, RemotingCommand request) throws RemotingCommandException {
    final RemotingCommand response =
        RemotingCommand.createResponseCommand(QueryConsumerOffsetResponseHeader.class);
    final QueryConsumerOffsetResponseHeader responseHeader =
        (QueryConsumerOffsetResponseHeader) response.readCustomHeader();
    final QueryConsumerOffsetRequestHeader requestHeader =
        (QueryConsumerOffsetRequestHeader) request
            .decodeCommandCustomHeader(QueryConsumerOffsetRequestHeader.class);

    long offset =
        this.brokerController.getConsumerOffsetManager().queryOffset(
            requestHeader.getConsumerGroup(), requestHeader.getTopic(), requestHeader.getQueueId());    // @1

    if (offset >= 0) {                                                                                                                                          // @2
        responseHeader.setOffset(offset);
        response.setCode(ResponseCode.SUCCESS);
        response.setRemark(null);
    } else {                                                                                                                                                       // @3
        long minOffset =
            this.brokerController.getMessageStore().getMinOffsetInQueue(requestHeader.getTopic(),
                requestHeader.getQueueId());                                                                                                     // @4
        if (minOffset <= 0
            && !this.brokerController.getMessageStore().checkInDiskByConsumeOffset(                                // @5
            requestHeader.getTopic(), requestHeader.getQueueId(), 0)) {
            responseHeader.setOffset(0L);
            response.setCode(ResponseCode.SUCCESS);
            response.setRemark(null);
        } else {                                                                                                                                                 // @6
            response.setCode(ResponseCode.QUERY_NOT_FOUND);
            response.setRemark("Not found, V3_0_6_SNAPSHOT maybe this group consumer boot first");
        }
    }
    return response;
}

代碼@1:從消費消息進度文件中查詢消息消費進度。

代碼@2:如果消息消費進度文件中存儲該隊列的消息進度,其返回的offset必然會大於等於0,則直接返回該偏移量該客戶端,客戶端從該偏移量開始消費。

代碼@3:如果未從消息消費進度文件中查詢到其進度,offset為-1。則首先獲取該主題、消息隊列當前在Broker服務器中的最小偏移量(@4)。如果小於等於0(返回0則表示該隊列的文件還未曾刪除過)並且其最小偏移量對應的消息存儲在內存中而不是存在磁盤中,則返回偏移量0,這就意味着ConsumeFromWhere中定義的三種枚舉類型都不會生效,直接從0開始消費,到這裏就能解開其謎團了(@5)。

代碼@6:如果偏移量小於等於0,但其消息已經存儲在磁盤中,此時返回未找到,最終RebalancePushImpl#computePullFromWhere中得到的偏移量為-1。

看到這裏,大家應該能回答文章開頭處提到的問題了吧?

看到這裏,大家應該明白了,為什麼設置的CONSUME_FROM_LAST_OFFSET,但消費組是從消息隊列的開始處消費了吧,原因就是消息消費進度文件中並沒有找到其消息消費進度,並且該隊列在Broker端的最小偏移量為0,說的更直白點,consumequeue/topicName/queueNum的第一個消息消費隊列文件為00000000000000000000,並且消息其對應的消息緩存在Broker端的內存中(pageCache),其返回給消費端的偏移量為0,故會從0開始消費,而不是從隊列的最大偏移量處開始消費。

為了知識體系的完備性,我們順便來看一下其他兩種策略的計算邏輯。

2.2 CONSUME_FROM_FIRST_OFFSET

case CONSUME_FROM_FIRST_OFFSET: {
    long lastOffset = offsetStore.readOffset(mq, ReadOffsetType.READ_FROM_STORE);   // @1
    if (lastOffset >= 0) {    // @2
        result = lastOffset;
    } else if (-1 == lastOffset) {  // @3
        result = 0L;
    } else {                                  
        result = -1;                    // @4
    }
    break;
}

從隊列的開始偏移量開始消費,其計算邏輯如下:
代碼@1:首先通過偏移量存儲器查詢消費隊列的消費進度。

代碼@2:如果大於等於0,則從當前該偏移量開始消費。

代碼@3:如果遠程返回-1,表示並沒有存儲該隊列的消息消費進度,從0開始。

代碼@4:否則從-1開始消費。

2.4 CONSUME_FROM_TIMESTAMP

從指定時戳后的消息開始消費。

case CONSUME_FROM_TIMESTAMP: {
    ong lastOffset = offsetStore.readOffset(mq, ReadOffsetType.READ_FROM_STORE);   // @1
    if (lastOffset >= 0) {                                                                                                            // @2
        result = lastOffset;
    } else if (-1 == lastOffset) {                                                                                                 // @3
        if (mq.getTopic().startsWith(MixAll.RETRY_GROUP_TOPIC_PREFIX)) {
            try {
                result = this.mQClientFactory.getMQAdminImpl().maxOffset(mq);
            } catch (MQClientException e) {
                result = -1;
            }
        } else {
            try {
                long timestamp = UtilAll.parseDate(this.defaultMQPushConsumerImpl.getDefaultMQPushConsumer().getConsumeTimestamp(),
                    UtilAll.YYYYMMDDHHMMSS).getTime();
                result = this.mQClientFactory.getMQAdminImpl().searchOffset(mq, timestamp);
            } catch (MQClientException e) {
                result = -1;
            }
        }
    } else {
        result = -1;
    }
    break;
}

其基本套路與CONSUME_FROM_LAST_OFFSET一樣:
代碼@1:首先通過偏移量存儲器查詢消費隊列的消費進度。

代碼@2:如果大於等於0,則從當前該偏移量開始消費。

代碼@3:如果遠程返回-1,表示並沒有存儲該隊列的消息消費進度,如果是重試主題,則從當前隊列的最大偏移量開始消費,如果是普通主題,則根據時間戳去Broker端查詢,根據查詢到的偏移量開始消費。

原理就介紹到這裏,下面根據上述理論對其進行驗證。

3、猜想與驗證

根據上述理論分析我們得知設置CONSUME_FROM_LAST_OFFSET但並不是從消息隊列的最大偏移量開始消費的“罪魁禍首”是因為消息消費隊列的最小偏移量為0,如果不為0,則就會符合預期,我們來驗證一下這個猜想。
首先我們刪除commitlog目錄下的文件,如圖所示:

其消費隊列截圖如下:

消費端的驗證代碼如下:

public static void main(String[] args) throws InterruptedException, MQClientException {
    DefaultMQPushConsumer consumer = new DefaultMQPushConsumer("my_consumer_02");
    consumer.setConsumeFromWhere(ConsumeFromWhere.CONSUME_FROM_LAST_OFFSET);
    consumer.subscribe("TopicTest", "*");
    consumer.setNamesrvAddr("127.0.0.1:9876");
    consumer.registerMessageListener(new MessageListenerConcurrently() {
        @Override
        public ConsumeConcurrentlyStatus consumeMessage(List<MessageExt> msgs,
            ConsumeConcurrentlyContext context) {
            System.out.printf("%s Receive New Messages: %s %n", Thread.currentThread().getName(), msgs);
            return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;
        }
    });
    consumer.start();
    System.out.printf("Consumer Started.%n");
}

運行結果如下:

並沒有消息存在的消息,符合預期。

4、解決方案

如果在生產環境下,一個新的消費組訂閱一個已經存在比較久的topic,設置CONSUME_FROM_MAX_OFFSET是符合預期的,即該主題的consumequeue/{queueNum}/fileName,fileName通常不會是00000000000000000000,如是是上面文件名,想要實現從隊列的最後開始消費,該如何做呢?那就走自動創建消費組的路子,執行如下命令:

./mqadmin updateSubGroup -n 127.0.0.1:9876 -c DefaultCluster -g my_consumer_05

//克隆一個訂閱了該topic的消費組消費進度
./mqadmin cloneGroupOffset -n 127.0.0.1:9876 -s my_consumer_01 -d my_consumer_05 -t TopicTest

//重置消費進度到當前隊列的最大值
./mqadmin resetOffsetByTime -n 127.0.0.1:9876 -g my_consumer_05 -t TopicTest -s -1

按照上上述命令后,即可實現其目的。

您都看到這裏了,麻煩幫忙點個贊,謝謝您的認可與鼓勵。

—

作者介紹:
丁威,《RocketMQ技術內幕》作者,RocketMQ 社區佈道師,公眾號: 維護者,目前已陸續發表源碼分析Java集合、Java 併發包(JUC)、Netty、Mycat、Dubbo、RocketMQ、Mybatis等源碼專欄。歡迎加入我的知識星球,構建一個高質量的技術交流社群。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※公開收購3c價格,不怕被賤賣!

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

在React舊項目中安裝並使用TypeScript的實踐

前言

本篇文章默認您大概了解什麼是TypeScript,主要講解如何在React舊項目中安裝並使用TypeScript。

寫這個的目的主要是網上關於TypeScript這塊的講解雖然很多,但都是一些語法概念或者簡單例子,真正改造一個React舊項目使用TypeScript的文章很少。

所以在這裏記錄下改造一個React項目的實踐。

博客內容部分參照 ,這個網站有官方文檔的中文版。

安裝TypeScript及相關庫

對於集成了TypeScript的腳手架可以略過這一步,這裏主要講一下如何將TypeScript集成到一個React腳手架中。

首先執行

npm install --save @types/react @types/react-dom

這一步主要是為了獲取react和react-dom的聲明文件,因為並不是所有的庫都有TypeScript的聲明文件,所以通過運行

npm install --save @types/庫名字

的方式來獲取TypeScript的聲明文件。

只有獲取了聲明文件,才能實現對這個庫的類型檢查。

如果你使用了一些其它的沒有聲明文件的庫,那麼可能也需要這麼做。

然後運行命令:

npm install --save-dev typescript awesome-typescript-loader source-map-loader

這一步,我們安裝了typescript、awesome-typescript-loader和source-map-loader。

awesome-typescript-loader可以讓Webpack使用TypeScript的標準配置文件tsconfig.json編譯TypeScript代碼。

source-map-loader使用TypeScript輸出的sourcemap文件來告訴webpack何時生成自己的sourcemaps,源碼映射,方便調試。

添加TypeScript配置文件

在項目根目錄下創建一個tsconfig.json文件,以下為內容示例:

{
  "compilerOptions": {
    "allowSyntheticDefaultImports": true, // 允許從沒有設置默認導出的模塊中默認導入。這並不影響代碼的輸出,僅為了類型檢查。
    "outDir": "./dist/", // 重定向輸出目錄
    "sourceMap": true, // 生成相應的 .map文件
    "noImplicitAny": true, // 在表達式和聲明上有隱含的 any類型時報錯。
    "module": "esnext", // 模塊引入方式
    "target": "esnext", // 指定ECMAScript目標版本
    "moduleResolution": "node", // 決定如何處理模塊
    "lib": [
      "esnext",
      "dom"
    ], // 編譯過程中需要引入的庫文件的列表。
    "skipLibCheck": true, //忽略所有庫中的聲明文件( *.d.ts)的類型檢查。
    "jsx": "react" // 在 .tsx文件里支持JSX
  },
  "include": [
    "./src/**/*", // 這個表示處理根目錄的src目錄下所有的.ts和.tsx文件,並不是所有文件
  ]
}

skipLibCheck非常重要,並不是每個庫都能通過typescript的檢測。

moduleResolution設為node也很重要。如果不這麼設置的話,找聲明文件的時候typescript不會在node_modules這個文件夾中去找。

更多配置文件信息可以參考:。

配置webpack

這裏列出一些TypeScript需要在webpack中使用的配置。

解析tsx文件的rule配置

示例如下:

module: {
    rules: [
      {
        test: /\.jsx?$/,
        exclude: /(node_modules)/,
        use: {
          loader: 'babel-loader',
          options: {
            presets: ['react', 'env', 'stage-0', 'stage-3'],
            plugins: [
              'transform-decorators-legacy',
              ['import', { libraryName: 'antd', style: 'css' }], // `style: true` 會加載 less 文件
            ],
          },
        },
      },
      { test: /\.tsx?$/, loader: "awesome-typescript-loader" }
      //...
    ]
    //...
}

其實就只是多加了一行:

{ test: /\.tsx?$/, loader: "awesome-typescript-loader" }

注意這一行需要加在解析jsx的rule下面,因為rule的執行順序是從下往上的,先解析tsx和ts再解析js和jsx。

當然用

enforce: 'pre'

調整過rule順序的可以不用在意這一點。

解決使用css-moudule的問題

如果代碼中使用了以下這種代碼:

import styles from './index.css'

那麼很可能報下面的錯:

Cannot find module './index.css'

解決方法就是在根目錄下新建文件一個叫declaration.d.ts的文件,內容為:

declare module '*.css' {
  const content: any;
  export default content;
}

這行代碼就是為所有的css文件進行聲明。

同時需要更改一下我們之前的tsconfig.json文件,將這個文件路徑放在include中:

"include": [
  "./src/**/*", 
  "./declaration.d.ts"
]

這個問題有通過安裝一些庫來解決的辦法,但是會給每個css生成一個聲明文件,感覺有點奇怪,我這裏自己考慮了一下採用了上面這種方法。

用於省略後綴名的配置

如果你慣於在使用

import Chart from './Chart/index.jsx'

時省略後綴,即:

import Chart from './Chart/index'

那麼在webpack的resolve中同樣需要加入ts和tsx:

resolve: {
  extensions: [".ts", ".tsx", ".js", ".jsx"]
},

引入Ant Design

實際上這個東西Ant Design的官網上就有怎麼在TypeScript中使用:。

那麼為什麼還是要列出來呢?

因為這裏要指出,對於已經安裝了Ant Design的舊項目而言(一般都是配了按需加載的吧),在安裝配置TypeScript時上面這個文檔基本沒有任何用處。

在網上可以搜到的貌似都是文檔中的方案,而實際上我們需要做的只是安裝ts-import-plugin。

npm i ts-import-plugin --save-dev

然後結合之前的 awesome-typescript-loader ,在webpack中進行如下配置

const tsImportPluginFactory = require('ts-import-plugin')

module.exports = {
  // ...
  module: {
    rules: [
      {
        test: /\.tsx?$/,
        loader: "awesome-typescript-loader",
        options: {
          getCustomTransformers: () => ({
            before: [tsImportPluginFactory([
              {
                libraryName: 'antd',
                libraryDirectory: 'lib',
                style: 'css'
              }
            ])]
          }),
        },
        exclude: /node_modules/
      }
    ]
  },
  // ...
}

配置完成,修改前的準備

注意,直到這一步,實際上您的項目在編譯過程中仍然沒有用到TypeScript。

因為我們這裏只會用TypeScript處理.ts和.tsx後綴的文件,除非在配置中將allowJs設為true。

在使用之前,默認您已經對TypeScript語法有了了解,不了解可以參考:。

也就是說,經過了上面的這些步驟,您的原有代碼在不改動後綴的情況下應該是可以繼續用的。

如果要使用TypeScript,那麼新建tsx和ts文件,或者修改原有的文件後綴名即可。

接下來會列出一些典型的修改示例。

函數式組件的修改示例(含children)

import React from 'react'
import styles from './index.css'

interface ComputeItemProps {
  label: string;
  children: React.ReactNode;
}

function ComputeItem({ label, children }: ComputeItemProps) {
  return <div className={styles['item']}>
    <div className={styles['label']}>{label}:</div>
    <div className={styles['content']}>{children}</div>
  </div>
}
export default ComputeItem

這個例子中語法都可以在TypeScript的官網查到,唯一需要注意的是children的類型是React.ReactNode。

class組件修改示例(含函數聲明,事件參數的定義)

import React from 'react'
import styles from './index.css'

interface DataSourceItem {
  dayOfGrowth: string;
  netValueDate: string;
}

interface ComputeProps {
  fundCode: string;
  dataSource: DataSourceItem[];
  onChange(value: Object): void;
}

export default class Compute extends React.Component<ComputeProps, Object> {
  // 改變基金代碼
  handleChangeFundCode = (e: React.ChangeEvent<HTMLInputElement>) => {
    const fundCode = e.target.value
    this.props.onChange({
      fundCode
    })

  }  
  render() {
      //...
    );
  }
}

這個例子展示如何聲明class組件:

React.Component<ComputeProps, Object>

語法雖然看起來很怪,但是這就是TypeScript中的泛型,以前有過C#或者Java經驗的應該很好理解。

其中,第一個參數定義Props的類型,第二個參數定義State的類型。

而react的事件參數類型應該如下定義:

React.ChangeEvent<HTMLInputElement>

這裏同樣使用了泛型,上面表示Input的Change事件類型。

而組件的Prop上有函數類型的定義,這裏就不單獨列出來了。

這幾個例子算是比較典型的TypeScript與React結合的例子。

處理window上的變量

使用寫在window上的全局變量會提示window上不存在這個屬性。

為了處理這點,可以在declaration.d.ts這個文件中定義變量:

// 定義window變量
interface Window{
  r:string[]
}

其中r是變量名。

總結

本來還想再多寫幾個示例的,但是Dota2版本更新了,導致我不想繼續寫下去了,以後如果有時間再更新常用的示例吧。

本篇文章只專註於在React舊項目中安裝並集成TypeScript,盡可能做到不涉及TypeScript的具體語法與介紹,因為介紹這些東西就不是一篇博客能搞定的了。

文章如有疏漏還請指正,希望能幫助到在TypeScript面前遲疑的你。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

物聯網架構成長之路(47)-利用GitLab實現CI持續集成

0.前言
  前段時間,考慮到要練習部署一套CI/CD的系統。一開始考慮到Jenkins,隨着這两天的了解,發現最新版的GitLab已經提供有CI/CD集成了。所以本次博客,乾脆一步到位,直接用GitLab裏面的CI/CD模塊。Jenkins可能需要更高級的應用場合。經過測試GitLab自帶的功能完全符合我的需求。

1. 安裝GitLab和GitLab-CI(gitlab-runner)
  英語比較好的,可以直接看官方文檔。https://docs.gitlab.com/omnibus/docker/#install-gitlab-using-docker-compose https://docs.gitlab.com/ee/ci/quick_start/README.html
  下面提供我使用的 docker-compose.yml

 1 version: '3'
 2 services:
 3     gitlab:
 4         image: twang2218/gitlab-ce-zh:latest
 5         #image: gitlab/gitlab-ce:rc
 6         restart: always
 7         hostname: '172.16.23.203'
 8         environment:
 9             GITLAB_OMNIBUS_CONFIG: |
10                 external_url 'http://172.16.23.203:8929'
11                 gitlab_rails["time_zone"] = "Asia/Shanghai"
12         ports:
13             - 8929:8929
14             - 1080:80
15             - 1443:443
16             - 1022:22
17         volumes:
18             - /root/workspace/docker/gitlab/1/config:/etc/gitlab
19             - /root/workspace/docker/gitlab/1/logs:/var/log/gitlab
20             - /root/workspace/docker/gitlab/1/data:/var/opt/gitlab
21     gitlab-runner:
22         image: gitlab/gitlab-runner:latest
23         restart: always
24         volumes:
25             - /root/workspace/docker/gitlab/2/config:/etc/gitlab-runner
26             - /var/run/docker.sock:/var/run/docker.sock

  執行docker-compose up -d 就運行起來,幾點需要說明的
    1. gitlab的image,可以選擇中文版或者英文版
    2. hostname 這裏指定本機IP地址
    3. gitlab環境變量,external_url表示提供訪問的IP和端口,時區配置上海
    4. 端口映射,默認是80端口,由於我上面配置了8929,所以映射8929到Host主機
    5. volumes 配置持久化數據
    6. 這裏的/var/run/docker.sock 要映射到主機,因為會用到主機的一些資源,同時還會在docker裏面安裝docker
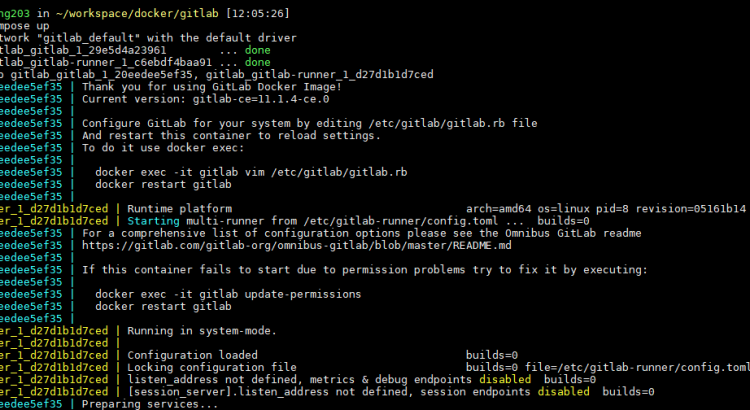
  下面是運行效果,第一次運行會比較久,因為要拉取鏡像和初始化GitLab

2. 登錄使用GitLab
  首次登錄,設置密碼。 登錄默認用戶名是root
  利用模版,新建一個Spring項目

  利用IDE,或者其他工具,或者直接在GitLab修改代碼

3. 配置CI/CD,把機器(gitlab-runner)註冊到GitLab中
  可以在項目配置CI/CD機器,也可以在個人所有項目下配置,也可以由管理員配置所有項目下CI/CD機器。原理和流程都是一樣的,只是比Jenkins更加細粒度控制而已。

  進入gitlab-runner的Docker,執行初始化命令 gitlab-ci-multi-runner register,完整命令如下:

1 sudo docker exec -it gitlab-runner gitlab-ci-multi-runner register

  需要錄入的信息,安裝上圖進行,填寫,後續還可以修改。

  如果需要修改,可以修改之前volumes配置的路徑下, config/config.toml


 1 concurrent = 1
 2 check_interval = 0
 3 
 4 [session_server]
 5   session_timeout = 1800
 6 
 7 [[runners]]
 8   name = "myRunner"
 9   url = "http://172.16.23.203:8929/"
10   token = "96beefdaa54832b0c8369ffa3811c9"
11   executor = "docker"
12   [runners.custom_build_dir]
13   [runners.docker]
14     tls_verify = false
15     image = "docker:latest"
16     privileged = true
17     disable_entrypoint_overwrite = false
18     oom_kill_disable = false
19     disable_cache = false
20     volumes = ["/cache", "/root/.m2:/root/.m2", "/var/run/docker.sock:/var/run/docker.sock"]
21     shm_size = 0
22   [runners.cache]
23     [runners.cache.s3]
24     [runners.cache.gcs]


  上面這個是配置文件,裏面有幾個注意點
    1. privileged 這裏要配置 true,因為要在docker裏面安裝docker
    2. /root/.m2 這個是配置maven的倉庫使用宿主主機的緩存,這樣就不用每次CI都要下載依賴
    3. /var/run/docker.sock 這個也要配置,在構建dockerfile的時候會用到
  還有一個需要配置的就是,這個Runner需要設置tag,這個是標識Runner的名稱。在.gitlab-ci.yml中會用到

4. 配置CI/CD
  默認GitLab是啟用該功能的,根目錄配置新增 .gitlab-ci.yml 文件,然後每次git push,都會觸發CI持續集成。當然可以在yml配置,在主線master觸發。
  來個簡單的配置,測試一下

 1 image: maven:3-jdk-8
 2 cache:
 3     paths:
 4         - .m2/repository
 5 test:
 6     stage: test
 7     script:
 8         - mvn package
 9     tags:
10         - tag

  上面這個配置,寫到.gitlab-ci.yml然後提交到repo,我們提交該文件到gitlab對應項目上去。

1 git add .gitlab-ci.yml
2 git commit -m "Add .gitlab-ci.yml"
3 git push origin master

  如果嫌慢,pom.xml 可以換個阿里源

 1         <repository>
 2             <id>maven-ali</id>
 3             <url>http://maven.aliyun.com/nexus/content/groups/public/</url>
 4             <releases>
 5                 <enabled>true</enabled>
 6             </releases>
 7             <snapshots>
 8                 <enabled>true</enabled>
 9                 <updatePolicy>always</updatePolicy>
10                 <checksumPolicy>fail</checksumPolicy>
11             </snapshots>
12         </repository>

  一提交,就會觸發自動構建

  可以看到整個構建過程,如果出現錯誤,也是到這個日誌裏面排查問題。


5. 測試、打包、發布
  這一步,我們實現一個簡單的測試、打包、發布
5.1 增加 Dockerfile

1 FROM openjdk:8-jdk-alpine
2 VOLUME /tmp
3 COPY  target/demo-0.0.1-SNAPSHOT.jar app.jar
4 ENV PORT 5000
5 EXPOSE $PORT
6 ENTRYPOINT ["java","-Djava.security.egd=file:/dev/./urandom","-Dserver.port=${PORT}","-jar","/app.jar"]

5.2 修改 .gitlab-ci.yml

 1 image: maven:3-jdk-8
 2 
 3 variables:
 4     DOCKER_TAG: test/demo-spring:0.1
 5 
 6 cache:
 7     paths:
 8         - .m2/repository
 9 
10 stages:
11     - test
12     - package
13     - deploy
14 
15 test:
16     stage: test
17     tags:
18         - tag
19     script:
20         - mvn test
21 
22 package:
23     stage: package
24     tags:
25         - tag
26     script:
27         - mvn clean package -Dmaven.test.skip=true
28     artifacts:
29         paths:
30             - target/*.jar
31 
32 deploy:
33     image: docker:latest
34     stage: deploy
35     services:
36         - docker:dind
37     tags:
38         - tag
39     script:
40         - docker version 
41         - docker build -t $DOCKER_TAG .
42         - docker rm -f test || true
43         - docker run -d --name test -p 5000:5000 $DOCKER_TAG

  那個artifacts.paths 配置,提交target目錄下的文件到下一個流水線,因為不同流水線,由於是基於Docker,所以每一步都是隔離的。同時,上傳的附件還可以在構建成功后,在流水線pipelines界面進行下載。每一步的image都是可以指定的,那個tags也是可以指定的。可以提交到不同的機器進行構建。
  上面一共就三步流程,先test(測試),然後package(打包編譯),最後deploy(發布測試)。前兩個比較好理解,就是maven的基本命令。最後那個deploy就是利用docker裏面的docker來進行打包成docker,然後運行起來,作為測試發布。
  更新代碼.gitlab-ci.yml,然後提交,觸發持續集成。

  查看構建日誌

  查看宿主機鏡像和運行狀態

  查看瀏覽器,已經發布到測試環境了

5.3 釘釘通知

 1 image: maven:3-jdk-8
 2 
 3 variables:
 4     DOCKER_TAG: test/demo-spring:0.1
 5 
 6 cache:
 7     paths:
 8         - .m2/repository
 9 
10 stages:
11     - test
12     - package
13     - deploy
14     - notify
15 
16 test:
17     stage: test
18     tags:
19         - tag
20     script:
21         - mvn test
22 
23 package:
24     stage: package
25     tags:
26         - tag
27     script:
28         - mvn clean package -Dmaven.test.skip=true
29     artifacts:
30         paths:
31             - target/*.jar
32 
33 deploy:
34     image: docker:latest
35     stage: deploy
36     services:
37         - docker:dind
38     tags:
39         - tag
40     script:
41         - docker version 
42         - docker build -t $DOCKER_TAG .
43         - docker rm -f test || true
44         - docker run -d --name test -p 5000:5000 $DOCKER_TAG
45 
46 notify:
47     image: appropriate/curl:latest
48     stage: notify
49     tags:
50         - tag
51     script: "curl 'https://oapi.dingtalk.com/robot/send?access_token=d6c15304c1***************************************' -H 'Content-Type: application/json' -d '{\"msgtype\": \"text\", \"text\": {\"content\": \"功能已更新部署至測試環境\"}}' "

  有了這個通知,就可以做很多事情了,寫個腳本,封裝成一個Docker 鏡像,可以發送釘釘,發送郵件,可以對接到第三方系統等。

  更多高級應用,如集成之前了解的Harbor,Rancher。使整個系統更加強大,更加智能化。


參考資料


本文地址:
本系列目錄:
個人主頁:

volumes

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選