在React舊項目中安裝並使用TypeScript的實踐

前言

本篇文章默認您大概了解什麼是TypeScript,主要講解如何在React舊項目中安裝並使用TypeScript。

寫這個的目的主要是網上關於TypeScript這塊的講解雖然很多,但都是一些語法概念或者簡單例子,真正改造一個React舊項目使用TypeScript的文章很少。

所以在這裏記錄下改造一個React項目的實踐。

博客內容部分參照 ,這個網站有官方文檔的中文版。

安裝TypeScript及相關庫

對於集成了TypeScript的腳手架可以略過這一步,這裏主要講一下如何將TypeScript集成到一個React腳手架中。

首先執行

npm install --save @types/react @types/react-dom

這一步主要是為了獲取react和react-dom的聲明文件,因為並不是所有的庫都有TypeScript的聲明文件,所以通過運行

npm install --save @types/庫名字

的方式來獲取TypeScript的聲明文件。

只有獲取了聲明文件,才能實現對這個庫的類型檢查。

如果你使用了一些其它的沒有聲明文件的庫,那麼可能也需要這麼做。

然後運行命令:

npm install --save-dev typescript awesome-typescript-loader source-map-loader

這一步,我們安裝了typescript、awesome-typescript-loader和source-map-loader。

awesome-typescript-loader可以讓Webpack使用TypeScript的標準配置文件tsconfig.json編譯TypeScript代碼。

source-map-loader使用TypeScript輸出的sourcemap文件來告訴webpack何時生成自己的sourcemaps,源碼映射,方便調試。

添加TypeScript配置文件

在項目根目錄下創建一個tsconfig.json文件,以下為內容示例:

{
  "compilerOptions": {
    "allowSyntheticDefaultImports": true, // 允許從沒有設置默認導出的模塊中默認導入。這並不影響代碼的輸出,僅為了類型檢查。
    "outDir": "./dist/", // 重定向輸出目錄
    "sourceMap": true, // 生成相應的 .map文件
    "noImplicitAny": true, // 在表達式和聲明上有隱含的 any類型時報錯。
    "module": "esnext", // 模塊引入方式
    "target": "esnext", // 指定ECMAScript目標版本
    "moduleResolution": "node", // 決定如何處理模塊
    "lib": [
      "esnext",
      "dom"
    ], // 編譯過程中需要引入的庫文件的列表。
    "skipLibCheck": true, //忽略所有庫中的聲明文件( *.d.ts)的類型檢查。
    "jsx": "react" // 在 .tsx文件里支持JSX
  },
  "include": [
    "./src/**/*", // 這個表示處理根目錄的src目錄下所有的.ts和.tsx文件,並不是所有文件
  ]
}

skipLibCheck非常重要,並不是每個庫都能通過typescript的檢測。

moduleResolution設為node也很重要。如果不這麼設置的話,找聲明文件的時候typescript不會在node_modules這個文件夾中去找。

更多配置文件信息可以參考:。

配置webpack

這裏列出一些TypeScript需要在webpack中使用的配置。

解析tsx文件的rule配置

示例如下:

module: {
    rules: [
      {
        test: /\.jsx?$/,
        exclude: /(node_modules)/,
        use: {
          loader: 'babel-loader',
          options: {
            presets: ['react', 'env', 'stage-0', 'stage-3'],
            plugins: [
              'transform-decorators-legacy',
              ['import', { libraryName: 'antd', style: 'css' }], // `style: true` 會加載 less 文件
            ],
          },
        },
      },
      { test: /\.tsx?$/, loader: "awesome-typescript-loader" }
      //...
    ]
    //...
}

其實就只是多加了一行:

{ test: /\.tsx?$/, loader: "awesome-typescript-loader" }

注意這一行需要加在解析jsx的rule下面,因為rule的執行順序是從下往上的,先解析tsx和ts再解析js和jsx。

當然用

enforce: 'pre'

調整過rule順序的可以不用在意這一點。

解決使用css-moudule的問題

如果代碼中使用了以下這種代碼:

import styles from './index.css'

那麼很可能報下面的錯:

Cannot find module './index.css'

解決方法就是在根目錄下新建文件一個叫declaration.d.ts的文件,內容為:

declare module '*.css' {
  const content: any;
  export default content;
}

這行代碼就是為所有的css文件進行聲明。

同時需要更改一下我們之前的tsconfig.json文件,將這個文件路徑放在include中:

"include": [
  "./src/**/*", 
  "./declaration.d.ts"
]

這個問題有通過安裝一些庫來解決的辦法,但是會給每個css生成一個聲明文件,感覺有點奇怪,我這裏自己考慮了一下採用了上面這種方法。

用於省略後綴名的配置

如果你慣於在使用

import Chart from './Chart/index.jsx'

時省略後綴,即:

import Chart from './Chart/index'

那麼在webpack的resolve中同樣需要加入ts和tsx:

resolve: {
  extensions: [".ts", ".tsx", ".js", ".jsx"]
},

引入Ant Design

實際上這個東西Ant Design的官網上就有怎麼在TypeScript中使用:。

那麼為什麼還是要列出來呢?

因為這裏要指出,對於已經安裝了Ant Design的舊項目而言(一般都是配了按需加載的吧),在安裝配置TypeScript時上面這個文檔基本沒有任何用處。

在網上可以搜到的貌似都是文檔中的方案,而實際上我們需要做的只是安裝ts-import-plugin。

npm i ts-import-plugin --save-dev

然後結合之前的 awesome-typescript-loader ,在webpack中進行如下配置

const tsImportPluginFactory = require('ts-import-plugin')

module.exports = {
  // ...
  module: {
    rules: [
      {
        test: /\.tsx?$/,
        loader: "awesome-typescript-loader",
        options: {
          getCustomTransformers: () => ({
            before: [tsImportPluginFactory([
              {
                libraryName: 'antd',
                libraryDirectory: 'lib',
                style: 'css'
              }
            ])]
          }),
        },
        exclude: /node_modules/
      }
    ]
  },
  // ...
}

配置完成,修改前的準備

注意,直到這一步,實際上您的項目在編譯過程中仍然沒有用到TypeScript。

因為我們這裏只會用TypeScript處理.ts和.tsx後綴的文件,除非在配置中將allowJs設為true。

在使用之前,默認您已經對TypeScript語法有了了解,不了解可以參考:。

也就是說,經過了上面的這些步驟,您的原有代碼在不改動後綴的情況下應該是可以繼續用的。

如果要使用TypeScript,那麼新建tsx和ts文件,或者修改原有的文件後綴名即可。

接下來會列出一些典型的修改示例。

函數式組件的修改示例(含children)

import React from 'react'
import styles from './index.css'

interface ComputeItemProps {
  label: string;
  children: React.ReactNode;
}

function ComputeItem({ label, children }: ComputeItemProps) {
  return <div className={styles['item']}>
    <div className={styles['label']}>{label}:</div>
    <div className={styles['content']}>{children}</div>
  </div>
}
export default ComputeItem

這個例子中語法都可以在TypeScript的官網查到,唯一需要注意的是children的類型是React.ReactNode。

class組件修改示例(含函數聲明,事件參數的定義)

import React from 'react'
import styles from './index.css'

interface DataSourceItem {
  dayOfGrowth: string;
  netValueDate: string;
}

interface ComputeProps {
  fundCode: string;
  dataSource: DataSourceItem[];
  onChange(value: Object): void;
}

export default class Compute extends React.Component<ComputeProps, Object> {
  // 改變基金代碼
  handleChangeFundCode = (e: React.ChangeEvent<HTMLInputElement>) => {
    const fundCode = e.target.value
    this.props.onChange({
      fundCode
    })

  }  
  render() {
      //...
    );
  }
}

這個例子展示如何聲明class組件:

React.Component<ComputeProps, Object>

語法雖然看起來很怪,但是這就是TypeScript中的泛型,以前有過C#或者Java經驗的應該很好理解。

其中,第一個參數定義Props的類型,第二個參數定義State的類型。

而react的事件參數類型應該如下定義:

React.ChangeEvent<HTMLInputElement>

這裏同樣使用了泛型,上面表示Input的Change事件類型。

而組件的Prop上有函數類型的定義,這裏就不單獨列出來了。

這幾個例子算是比較典型的TypeScript與React結合的例子。

處理window上的變量

使用寫在window上的全局變量會提示window上不存在這個屬性。

為了處理這點,可以在declaration.d.ts這個文件中定義變量:

// 定義window變量
interface Window{
  r:string[]
}

其中r是變量名。

總結

本來還想再多寫幾個示例的,但是Dota2版本更新了,導致我不想繼續寫下去了,以後如果有時間再更新常用的示例吧。

本篇文章只專註於在React舊項目中安裝並集成TypeScript,盡可能做到不涉及TypeScript的具體語法與介紹,因為介紹這些東西就不是一篇博客能搞定的了。

文章如有疏漏還請指正,希望能幫助到在TypeScript面前遲疑的你。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
【python測試開發棧】python內存管理機制(一)—引用計數

什麼是內存

在開始進入正題之前,我們先來回憶下,計算機基礎原理的知識,為什麼需要內存。我們都知道計算機的CPU相當於人類的大腦,其運算速度非常的快,而我們平時寫的數據,比如:文檔、代碼等都是存儲在磁盤上的。磁盤的存取速度完全不能匹配cpu的運算速度,因此就需要一个中間層來適配兩者的不對等,內存由此而來,內存的存取速率很快,但是存儲空間不大。

舉一個圖書館的例子,便於大家理解,我們圖書館的書架就相當於磁盤,存放了大量的圖書可以供我們閱讀,但是如果書放在書架上,我們沒辦法直接閱讀(效率低),只能將書取出來,放在書桌上看,那書桌就相當於內存。

內存回收

內存資源畢竟是有限的,所以在使用之後,必須被回收掉,否則系統運行一段時間后就會因無內存可用而癱瘓。我們軟件測試領域常用的兩種語言:java和python,全部都採用內存自動回收的方法,也就是我們只管申請內存,但是不管釋放內存,由jvm和python解釋器來定期觸發內存回收。作為對比,C語言和C++中,程序員需要使用malloc申請內存,使用free去釋放內存,malloc和free必須成對的出現,否則非常容易出現內存問題。

還拿上面圖書館的例子,假如圖書館的書看完之後放在書桌上就可以(因為圖書可自動回收),那麼很快的,就沒有位置給新進來的同學看書了。這時候就需要圖書館管理員(jvm或python解釋器)定期的回收圖書,清空書桌。不過正常情況下,我們離開圖書館時,要自己清空書桌,將書放回書架(類似C語言和C++的內存回收方式)。

python內存管理

引用計數

python通過引用計數來進行內存管理,每一個python對象,都維護了一個指向該對象的引用計數。python的sys庫提供了getrefcount()函數來獲取對象的引用計數。下面我們看個例子(注意:不同版本的python,運行結果不同,我這裏採用的是python3.7.4):

"""
    @author: xuanke
    @time: 2019/11/27
    @function: 測試python內存
"""
import sys

class RefClass(object):
    def __init__(self):
        print("this is init")

def ref_count_test():
    # 驗證普通字符串
    str1 = "abc"
    print(sys.getrefcount(str1))
    # 驗證稍微複雜點的字符串
    print(sys.getrefcount("xuankeTester"))
    # 驗證小的数字
    print(sys.getrefcount(12))
    # 驗證大的数字
    print(sys.getrefcount(257))
    # 驗證類
    a = RefClass()
    print(sys.getrefcount(a))
    # 驗證引用計數增加
    b = a
    print(sys.getrefcount(a))

    # 驗證引用計數減少
    b = None
    print(sys.getrefcount(a))

if __name__ == '__main__':
    ref_count_test()

大家先來思考下,最終的結果會是什麼?!我覺得應該很多人都會答錯,因為不同版本的python,對引用變量個數有影響(主要是可復用的對象)。我們先貼出來運行結果,再來分析產生結果的原因:

27
4
9
3
this is init
2
3
2

不過提前聲明一點:sys.getrefcount函數在使用時,因為將對象(比如上例中的str1)作為參數傳入,所以會額外增加一個變量(相當於getrefcount持有了str1的引用),因此實際每個對象的實際引用計數都得減1。下面分別介紹下上面的幾種情況:

  • 字符串: str1=’abc’的引用數是27-1=26,是因為字符串’abc’比較簡單,在python解釋器(CPython)中確實可能存在26個引用。作為對比,在python2.7中,str1的引用變量個數是3-1=2。而字符串’xuanketester’,是我自定義的一個字符串,所以不可能會有其他額外的引用,所以其引用變量個數是3-1=2(至於為什麼是2,理論應該是0,是因為python解釋器默認持有了所有字符串的兩個引用)。
  • 数字: 数字12對應的引用計數個數是9-1=8,而257對應的引用計數個數是3-1=2,這主要是因為,在python初始化過程中,就創建了從-5到256的数字,緩存起來,這樣做是為了頻繁的分配內存,提高效率。而對於不在這個區間的数字,則會重新分配內存空間。所以数字12因為被複用,其引用計數個數是8(在python2.7.14中,其引用計數個數是8)。
  • 類: 在上面例子中,創建一個RefClass對象,其引用計數就是2-1=1,因為其是一個我們自定義的類對象,在python解釋器(Cpython)中肯定不會被複用。

我們可以通過打印內存地址的方式來驗證上面這幾種情況:

    def memory_address_test():
    str1 = 'xuankeTester'
    str2 = 'xuankeTester'
    print(id(str1))
    print(id(str2))

    str3 = 'abc'
    str4 = 'abc'
    print(id(str3))
    print(id(str4))

    a = 12
    b = 12
    print(id(a))
    print(id(b))

    c = 257
    d = 257
    print(id(c))
    print(id(d))

按照我們上面的分析,c和d的地址應該是不一樣的,a和b的地址是一樣的,字符串str1和str2、str3和str4內存地址都是一樣的。但是我在pycharm中,直接運行py文件,結果卻和預想的不一致,結果如下:

2854496960176
2854496960176
2854496857840
2854496857840
140724423258720
140724423258720
2854498931120
2854498931120

所有情況的內存地址都是一樣的,這是為什麼呢?我考慮到是不是pycharm對py文件做了優化,於是我又在命令行嘗試執行,結果還是一樣的。所以,我猜測可能是python解釋器在執行文件時,為了提高py文件的執行效率,對文件的內存地址做了優化—相同內容的對象內存地址都一樣。

為了驗證這個想法,我直接在python交互模式下執行,果然得到了我想要的結果:

Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
Type "help", "copyright", "credits" or "license" for more information.
>>> a=12
>>> b=12
>>> id(a)
140724423258720
>>> id(b)
140724423258720
>>> a=257
>>> b=257
>>> id(a)
2559155778384
>>> id(b)
2559155778192
>>> a='xuankeTester'
>>> b='xuankeTester'
>>> id(a)
2559155711280
>>> id(b)
2559155711280
>>>

從上面可以看到兩個257對應的地址確實是不一樣的,和我們最初判斷的是一致的。

總結

python通過對象的引用計數來管理內存,其實java的JVM也有用引用計數,所以理解了引用計數,為我們理解python的垃圾回收方法打下了基礎。本計劃這一篇文章就將python內存管理的機制講完的,但是發現一個內存引用計數就有很多東西得寫,所以索性就分兩篇文章來寫,之後再寫一篇文章來介紹python的垃圾回收方式。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

.NET Core 3.0 使用Nswag生成Api文檔和客戶端代碼

摘要

在前後端分離、Restful API盛行的年代,完美的接口文檔,成了交流的紐帶。在項目中引入Swagger (也稱為OpenAPI),是種不錯的選擇,它可以讓接口數據可視化。下文將會演示

  • 利用Nswag如何生成Api文檔

  • 利用NSwagStudio如何生成客戶端代碼,並且進行測試

什麼是 Swagger/OpenAPI?

Swagger 是一個與語言無關的規範,用於描述 REST API。Swagger 項目已捐贈給 OpenAPI 計劃,現在它被稱為開放 API。這兩個名稱可互換使用,但 OpenAPI 是首選。它允許計算機和人員了解服務的功能,而無需直接訪問實現(源代碼、網絡訪問、文檔)。其中一個目標是盡量減少連接取消關聯的服務所需的工作量。另一個目標是減少準確記錄服務所需的時間。

Nswag VS Swashbuckle?

.NET Swagger 實現類庫有兩個比較流行:

  • Swashbuckle.AspNetCore 是一個開源項目,用於生成 ASP.NET Core Web API 的 Swagger 文檔。

  • NSwag 是另一個用於生成 Swagger 文檔並將 Swagger UI 或 ReDoc 集成到 ASP.NET Core Web API 中的開源項目。此外,NSwag 還提供了為 API 生成 C# 和 TypeScript 客戶端代碼的方法。


為什麼我在.NET core3.0中選擇NSwag呢,NSwag比較活躍,一直在更新,功能也很強大,可以完美的代替Swashbuckle.AspNetCore具體可以參考:https://github.com/aspnet/AspNetCore.Docs/issues/4258

一、利用Nswag生成Api文檔

步驟
  1. 創建Asp.NET Core Api項目,並且集成NSwag

  2. 配置項目

  3. 運行項目

創建Asp.NET Core Api項目,並且集成NSwag

我們將簡單的創建一個ASP.NET core API項目。將其命名為“WebAPIwithSwg”。基於.NETcore3.0

安裝nuget包NSwag.AspNetCore

接下來,在Startup.cs文件中配置Nswag服務和中間件。

在ConfigureServices方法中添加服務

  public void ConfigureServices(IServiceCollection services)
        {
            services.AddControllers();
            services.AddSwaggerDocument(); //註冊Swagger 服務
        }
在Configure方法中添加Nswag中間件
 public void Configure(IApplicationBuilder app, IWebHostEnvironment env)
        {
            if (env.IsDevelopment())
            {
                app.UseDeveloperExceptionPage();
            }
            app.UseRouting();
            app.UseAuthorization();
            app.UseEndpoints(endpoints =>
            {
                endpoints.MapControllers();
            });
            app.UseOpenApi(); //添加swagger生成api文檔(默認路由文檔 /swagger/v1/swagger.json)
            app.UseSwaggerUi3();//添加Swagger UI到請求管道中(默認路由: /swagger).
        }
配置項目

運行項目

右鍵項目在瀏覽器中查看,查看swagger UI需要在url後面添加“/swagger”。本示例http://localhost:54117/swagger

二、利用NSwagStudio如何生成客戶端代碼,並且進行測試
提供GUI界面是NSwag的一大特點,只需要下載安裝NSwagStudio,即可生成客戶端代碼。
步驟
  1. 現在安裝NSwagStudio

  2. NSwagStudio配置,生成客戶端代碼

  3. 創建測試客戶端項目

下載安裝NSwagStudio

下載NSwag Studio http://rsuter.com/Projects/NSwagStudio/installer.php 安裝之後打開 NSwag Studio 如圖

NSwagStudio配置,生成客戶端代碼

選擇runtime,我選擇的是NETCore30,切換OpenAPI/Swagger Specification ,在Specification URL 輸入你的Swagger.json路徑,本示例:http://localhost:54117/swagger/v1/swagger.json輸入路徑之後,點擊 create local copy 按鈕獲取json。

接下配置來生成客戶端代碼。我們首先選擇“csharp client”複選框,然後勾選掉 “Inject Http Client via Constructor (life cycle is managed by caller)” ,最後設置下輸出路徑 點擊生成文件(Generate Files)。步驟如下

到此客戶端代碼已經自動生成。

查看生成的部分代碼


public async System.Threading.Tasks.Task<System.Collections.Generic.ICollection<WeatherForecast>> GetAsync(System.Threading.CancellationToken cancellationToken)
        {
            var urlBuilder_ = new System.Text.StringBuilder();
            urlBuilder_.Append(BaseUrl != null ? BaseUrl.TrimEnd('/') : "").Append("/WeatherForecast");
    
            var client_ = new System.Net.Http.HttpClient();
            try
            {
                using (var request_ = new System.Net.Http.HttpRequestMessage())
                {
                    request_.Method = new System.Net.Http.HttpMethod("GET");
                    request_.Headers.Accept.Add(System.Net.Http.Headers.MediaTypeWithQualityHeaderValue.Parse("application/json"));
    
                    PrepareRequest(client_, request_, urlBuilder_);
                    var url_ = urlBuilder_.ToString();
                    request_.RequestUri = new System.Uri(url_, System.UriKind.RelativeOrAbsolute);
                    PrepareRequest(client_, request_, url_);
    
                    var response_ = await client_.SendAsync(request_, System.Net.Http.HttpCompletionOption.ResponseHeadersRead, cancellationToken).ConfigureAwait(false);
                    try
                    {
                        var headers_ = System.Linq.Enumerable.ToDictionary(response_.Headers, h_ => h_.Key, h_ => h_.Value);
                        if (response_.Content != null && response_.Content.Headers != null)
                        {
                            foreach (var item_ in response_.Content.Headers)
                                headers_[item_.Key] = item_.Value;
                        }
    
                        ProcessResponse(client_, response_);
    
                        var status_ = ((int)response_.StatusCode).ToString();
                        if (status_ == "200") 
                        {
                            var objectResponse_ = await ReadObjectResponseAsync<System.Collections.Generic.ICollection<WeatherForecast>>(response_, headers_).ConfigureAwait(false);
                            return objectResponse_.Object;
                        }
                        else
                        if (status_ != "200" && status_ != "204")
                        {
                            var responseData_ = response_.Content == null ? null : await response_.Content.ReadAsStringAsync().ConfigureAwait(false); 
                            throw new ApiException("The HTTP status code of the response was not expected (" + (int)response_.StatusCode + ").", (int)response_.StatusCode, responseData_, headers_, null);
                        }
            
                        return default(System.Collections.Generic.ICollection<WeatherForecast>);
                    }
                    finally
                    {
                        if (response_ != null)
                            response_.Dispose();
                    }
                }
            }
            finally
            {
                if (client_ != null)
                    client_.Dispose();
            }
        }
創建測試客戶端項目

創建一個控製程序項目,命名“WebApiClient”。

把自動生成的類“WeatherForecastClient”添加到客戶端項目中,然後安裝Newtonsoft

最後在Main函數中添加測試代碼,開始使用Api。

 static async System.Threading.Tasks.Task Main(string[] args)
        {

            var weatherForecastClient = new WeatherForecastClient();
            //gets all values from the API
            var allValues = await weatherForecastClient.GetAsync();
            Console.WriteLine("Hello World!");
        }

運行客戶端應用程序,進行調用api

當然如果需要調試api項目內部代碼,可以設置斷點,進入一步一步的調試

小結:NSwag 功能遠不止這些,本篇文章演示了如何生成api文檔和自動生成的api客戶端代碼方便我們調試,也可以作為對應的sdk。

參考:微軟官方文檔—https://docs.microsoft.com/zh-cn/aspnet/core/tutorials/getting-started-with-nswag?view=aspnetcore-2.2&tabs=visual-studio

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

中國動力電池技術突破,2025 年電動車成本效益比料勝燃油車


21 世紀經濟報導,中國電動汽車百人會理事長陳清泰表示,過去一年,中國電動汽車產業正在向高品質發輾轉型,發展形勢良好;而電動汽車再往前發展要跨越一個臨界點,就是電動車的成本效益比達到和超過燃油車,他預期這個臨界點會可能會在 2025 年前後出現。   中國 2017 年新能源汽車銷量目標 70 萬輛,去年 1 到 11 月累計銷售 60.9 萬輛、年增 51.4%。專家預測,中國去年新能源汽車總銷量可能超過 80 萬輛。中國汽車工業協會秘書長助理許海東日前表示,中國去年新能源汽車 70 萬輛銷量目標應可達成,2018 年新能源車銷量增速仍可保持 40% 至 50%,預期銷量將超過 100 萬輛。   陳清泰指出,電動汽車再往前發展要跨越一個臨界點,就是電動車的成本效益比達到和超過燃油車,如果跨過了這個門檻,電動車就可依託市場力量自主發展了,目前仍需靠政策、靠政府補貼。他亦預期,當財政補貼完全取消後,雙積分政策作為替代政策,新能源汽車積分比例將在 2020 年 12% 的基礎上繼續上調。   對於上述臨界點會出現在什麼時候?陳清泰的判斷是,大約在 2025 年前後。對此,他建議中國車企要在以下幾個方面做好準備,首先是在財政補貼退坡之後,做好可持續發展的保障工作,另外電動車自身要透過輕量化、節能化提高成本效益比;其次,產品技術要雙線作戰,其中一條戰線是完善汽車的行駛功能,另一條戰線則是將車聯網和共享化應用到新能源汽車上;第三,自動駕駛是爭奪未來的一個重點;第四,在有限的時間要加緊做品牌建設。   中國電動汽車百人會執行副理事長歐陽明高表示,2017 年中國動力電池技術已取得實質性進展,動力電池系統能量密度已達到 150 瓦時/公斤甚至以上,鋰離子動力電池單體比能量有望於 2020 年前實現 300 瓦時/公斤目標。   他進一步指出,2025 年,具備一般成本效益比的純電動轎車合理的里程是 300 到 400 公里;但 2030 年,最大的技術突破將體現在電解質上,固態電池會規模產業化,電池單體比能量可望觸及 500 瓦時/公斤;2030 年常規的成本效益比車型,續航里程應該可達到 500 公里以上。   (本文內容由授權使用。首圖來源:)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※平板收購,iphone手機收購,二手筆電回收,二手iphone收購-全台皆可收購

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

一文帶你深入了解 redis 複製技術及主從架構

主從架構可以說是互聯網必備的架構了,第一是為了保證服務的高可用,第二是為了實現讀寫分離,你可能熟悉我們常用的 MySQL 數據庫的主從架構,對於我們 redis 來說也不意外,redis 數據庫也有各種各樣的主從架構方式,在主從架構中會涉及到主節點與從節點之間的數據同步,這個數據同步的過程在 redis 中叫做複製,這在篇文章中,我們詳細的聊一聊 redis 的複製技術和主從架構 ,本文主要有以下內容:

  • 主從架構環境搭建
    • 主從架構的建立方式
    • 主從架構的斷開
  • 複製技術的原理
    • 數據同步過程
    • 心跳檢測
  • 主從拓撲架構
    • 一主一從
    • 一主多從
    • 樹狀結構

主從環境搭建

redis 的實例在默認的情況下都是主節點,所以我們需要修改一些配置來搭建主從架構,redis 的主從架構搭建還是比較簡單的,redis 提供了三種方式來搭建主從架構,在後面我們將就介紹,在介紹之前我們要先了解主從架構的特性:在主從架構中有一個主節點(master)和最少一個從節點(slave),並且數據複製是單向的,只能從主節點複製到從節點,不能由從節點到主節點。

主從架構的建立方式

主從架構的建立有以下三種方式:

  • 在 Redis.conf 配置文件中加入 slaveof {masterHost} {masterPort} 命令,隨 Redis 實例的啟動生效
  • 在 redis-server 啟動命令后加入 –slaveof {masterHost} {masterPort} 參數
  • 在 redis-cli 交互窗口下直接使用命令:slaveof {masterHost} {masterPort}

上面三種方式都可以搭建 Redis 主從架構,我們以第一種方式來演示,其他兩種方式自行嘗試,由於是演示,所以就在本地啟動兩個 Redis 實例,並不在多台機器上啟動 redis 的實例了,我們準備一個端口 6379 的主節點實例,準備一個端口 6480 從節點的實例,端口 6480 的 redis 實例配置文件取名為 6480.conf 並且在裏面添加 slaveof 語句,在配置文件最後加入如下一條語句

slaveof 127.0.0.1 6379

分別啟動兩個 redis 實例,啟動之後他們會自動建立主從關係,關於這背後的原理,我們後面在詳細的聊一聊,先來驗證一下我們的主從架構是否搭建成功,我們先在 6379 master 節點上新增一條數據:

然後再 6480 slave 節點上獲取該數據:

可以看出我們在 slave 節點上已經成功的獲取到了在 master 節點新增的值,說明主從架構已經搭建成功了,我們使用 info replication 命令來查看兩個節點的信息,先來看看主節點的信息

可以看出 6379 端口的實例 role 為 master,有一個正在連接的實例,還有其他運行的信息,我們再來看看 6480 端口的 redis 實例信息

可以看出兩個節點之間相互記錄著對象的信息,這些信息在數據複製時候將會用到。在這裡有一點需要說明一下,默認情況下 slave 節點是只讀的,並不支持寫入,也不建議開啟寫入,我們可以驗證一下,在 6480 實例上寫入一條數據

127.0.0.1:6480> set x 3
(error) READONLY You can't write against a read only replica.
127.0.0.1:6480> 

提示只讀,並不支持寫入操作,當然我們也可以修改該配置,在配置文件中 replica-read-only yes 配置項就是用來控制從服務器只讀的,為什麼只能只讀?因為我們知道複製是單向的,數據只能由 master 到 slave 節點,如果在 salve 節點上開啟寫入的話,那麼修改了 slave 節點的數據, master 節點是感知不到的,slave 節點的數據並不能複製到 master 節點上,這樣就會造成數據不一致的情況,所以建議 slave 節點只讀。

主從架構的斷開

主從架構的斷開同樣是 slaveof 命令,在從節點上執行 slaveof no one 命令就可以與主節點斷開追隨關係,我們在 6480 節點上執行 slaveof no one 命令

127.0.0.1:6480> slaveof no one
OK
127.0.0.1:6480> info replication
# Replication
role:master
connected_slaves:0
master_replid:a54f3ba841c67762d6c1e33456c97b94c62f6ac0
master_replid2:e5c1ab2a68064690aebef4bd2bd4f3ddfba9cc27
master_repl_offset:4367
second_repl_offset:4368
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:4367
127.0.0.1:6480> 

執行完 slaveof no one 命令之後,6480 節點的角色立馬恢復成了 master ,我們再來看看時候還和 6379 實例連接在一起,我們在 6379 節點上新增一個 key-value

127.0.0.1:6379> set y 3
OK

在 6480 節點上 get y

127.0.0.1:6480> get y
(nil)
127.0.0.1:6480> 

在 6480 節點上獲取不到 y ,因為 6480 節點已經跟 6379 節點斷開的聯繫,不存在主從關係了,slaveof 命令不僅能夠斷開連接,還能切換主服務器,使用命令為 slaveof {newMasterIp} {newMasterPort},我們讓 6379 成為 6480 的從節點, 在 6379 節點上執行 slaveof 127.0.0.1 6480 命令,我們在來看看 6379 的 info replication

127.0.0.1:6379> info replication
# Replication
role:slave
master_host:127.0.0.1
master_port:6480
master_link_status:up
master_last_io_seconds_ago:2
master_sync_in_progress:0
slave_repl_offset:4367
slave_priority:100
slave_read_only:1
connected_slaves:0
master_replid:99624d4b402b5091552b9cb3dd9a793a3005e2ea
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:4367
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:4368
repl_backlog_histlen:0
127.0.0.1:6379> 

6379 節點的角色已經是 slave 了,並且主節點的是 6480 ,我們可以再看看 6480 節點的 info replication

127.0.0.1:6480> info replication
# Replication
role:master
connected_slaves:1
slave0:ip=127.0.0.1,port=6379,state=online,offset=4479,lag=1
master_replid:99624d4b402b5091552b9cb3dd9a793a3005e2ea
master_replid2:a54f3ba841c67762d6c1e33456c97b94c62f6ac0
master_repl_offset:4479
second_repl_offset:4368
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:4479
127.0.0.1:6480> 

在 6480 節點上有 6379 從節點的信息,可以看出 slaveof 命令已經幫我們完成了主服務器的切換。

複製技術的原理

redis 的主從架構好像很簡單一樣,我們就執行了一條命令就成功搭建了主從架構,並且數據複製也沒有問題,使用起來確實簡單,但是這背後 redis 還是幫我們做了很多的事情,比如主從服務器之間的數據同步、主從服務器的狀態檢測等,這背後 redis 是如何實現的呢?接下來我們就一起看看

數據複製原理

我們執行完 slaveof 命令之後,我們的主從關係就建立好了,在這個過程中, master 服務器與 slave 服務器之間需要經歷多個步驟,如下圖所示:

slaveof 命令背後,主從服務器大致經歷了七步,其中權限驗證這一步不是必須的,為了能夠更好的理解這些步驟,就以我們上面搭建的 redis 實例為例來詳細聊一聊各步驟。

1、保存主節點信息

在 6480 的客戶端向 6480 節點服務器發送 slaveof 127.0.0.1 6379 命令時,我們會立馬得到一個 OK

127.0.0.1:6480> slaveof 127.0.0.1 6379
OK
127.0.0.1:6480> 

這時候數據複製工作並沒有開始,數據複製工作是在返回 OK 之後才開始執行的,這時候 6480 從節點做的事情是將給定的主服務器 IP 地址 127.0.0.1 以及端口 6379 保存到服務器狀態的 masterhost 屬性和 masterport 屬性裏面

2、建立 socket 連接

在 slaveof 命令執行完之後,從服務器會根據命令設置的 IP 地址和端口,跟主服務器創建套接字連接, 如果從服務器能夠跟主服務器成功的建立 socket 連接,那麼從服務器將會為這個 socket 關聯一個專門用於處理複製工作的文件事件處理器,這個處理器將負責後續的複製工作,比如接受全量複製的 RDB 文件以及服務器傳來的寫命令。同樣主服務器在接受從服務器的 socket 連接之後,將為該 socket 創建一個客戶端狀態,這時候的從服務器同時具有服務器和客戶端兩個身份,從服務器可以向主服務器發送命令請求而主服務器則會向從服務器返回命令回復。

3、發送 ping 命令

從服務器與主服務器連接成功后,做的第一件事情就是向主服務器發送一個 ping 命令,發送 ping 命令主要有以下目的:

  • 檢測主從之間網絡套接字是否可用
  • 檢測主節點當前是否可接受處理命令

在發送 ping 命令之後,正常情況下主服務器會返回 pong 命令,接受到主服務器返回的 pong 回復之後就會進行下一步工作,如果沒有收到主節點的 pong 回復或者超時,比如網絡超時或者主節點正在阻塞無法響應命令,從服務器會斷開複製連接,等待下一次定時任務的調度。

4、身份驗證

從服務器在接收到主服務器返回的 pong 回復之後,下一步要做的事情就是根據配置信息決定是否需要身份驗證:

  • 如果從服務器設置了 masterauth 參數,則進行身份驗證
  • 如果從服務器沒有設置 masterauth 參數,則不進行身份驗證

在需要身份驗證的情況下,從服務器將就向主服務器發送一條 auth 命令,命令參數為從服務器 masterauth 選項的值,舉個例子,如果從服務器的配置里將 masterauth 參數設置為:123456,那麼從服務器將向主服務器發送 auth 123456 命令,身份驗證的過程也不是一帆風順的,可能會遇到以下幾種情況:

  • 從服務器通過 auth 命令發送的密碼與主服務器的 requirepass 參數值一致,那麼將繼續進行後續操作,如果密碼不一致,主服務將返回一個 invalid password 錯誤
  • 如果主服務器沒有設置 requirepass 參數,那麼主服務器將返回一個 no password is set 錯誤

所有的錯誤情況都會令從服務器中止當前的複製工作,並且要從建立 socket 開始重新發起複制流程,直到身份驗證通過或者從服務器放棄執行複製為止

5、發送端口信息

在身份驗證通過後,從服務器將執行 REPLCONF listening 命令,向主服務器發送從服務器的監聽端口號,例如在我們的例子中從服務器監聽的端口為 6480,那麼從服務器將向主服務器發送 REPLCONF listening 6480 命令,主服務器接收到這個命令之後,會將端口號記錄在從服務器所對應的客戶端狀態的 slave_listening_port 屬性了,也就是我們在 master 服務器的 info replication 裏面看到的 port 值。

6、數據複製

數據複製是最複雜的一塊了,由 psync 命令來完成,從服務器會向主服務器發送一個 psync 命令來進行數據同步,在 redis 2.8 版本以前使用的是 sync 命令,除了命令不同之外,在複製的方式上也有很大的不同,在 redis 2.8 版本以前使用的都是全量複製,這對主節點和網絡會造成很大的開銷,在 redis 2.8 版本以後,數據同步將分為全量同步和部分同步。

  • 全量複製:一般用於初次複製場景,不管是新舊版本的 redis 在從服務器第一次與主服務連接時都將進行一次全量複製,它會把主節點的全部數據一次性發給從節點,當數據較大時,會對主節點和網絡造成很大的開銷,redis 的早期版本只支持全量複製,這不是一種高效的數據複製方式

  • 部分複製:用於處理在主從複製中因網絡閃斷等原因造成的數據丟失 場景,當從節點再次連上主節點后,如果條件允許,主節點會補發丟失數據 給從節點。因為補發的數據遠遠小於全量數據,可以有效避免全量複製的過高開銷,部分複製是對老版複製的重大優化,有效避免了不必要的全量複製操作

redis 之所以能夠支持全量複製和部分複製,主要是對 sync 命令的優化,在 redis 2.8 版本以後使用的是一個全新的 psync 命令,命令格式為:psync {runId} {offset},這兩個參數的意義:

  • runId:主節點運行的id
  • offset:當前從節點複製的數據偏移量

也許你對上面的 runid、offset 比較陌生,沒關係,我們先來看看下面三個概念:

1、複製偏移量

參与複製的主從節點都會分別維護自身複製偏移量:主服務器每次向從服務器傳播 N 個字節的數據時,就將自己的偏移量的值加上 N,從服務器每次接收到主服務器傳播的 N個字節的數據時,將自己的偏移量值加上 N。通過對比主從服務器的複製偏移量,就可以知道主從服務器的數據是否一致,如果主從服務器的偏移量總是相同,那麼主從數據一致,相反,如果主從服務器兩個的偏移量並不相同,那麼說明主從服務器並未處於數據一致的狀態,比如在有多個從服務器時,在傳輸的過程中某一個服務器離線了,如下圖所示:

由於從服務器A 在數據傳輸時,由於網絡原因掉線了,導致偏移量與主服務器不一致,那麼當從服務器A 重啟並且與主服務器連接成功后,重新向主服務器發送 psync 命令,這時候數據複製應該執行全量複製還是部分複製呢?如果執行部分複製,主服務器又如何補償從服務器A 在斷線期間丟失的那部分數據呢?這些問題的答案都在複製積壓緩衝區裏面

2、複製積壓緩衝區

複製積壓緩衝區是保存在主節點上的一個固定長度的隊列,默認大小為 1MB,當主節點有連接的從節點(slave)時被創建,這時主節點(master) 響應寫命令時,不但會把命令發送給從節點,還會寫入複製積壓緩衝區,如下圖所示:

因此,主服務器的複製積壓緩衝區裏面會保存着一部分最近傳播的寫命令,並且複製積壓緩衝區會為隊列中的每個字節記錄相應的複製偏移量。所以當從服務器重新連上主服務器時,從服務器通過 psync 命令將自己的複製偏移量 offset 發送給主服務器,主服務器會根據這個複製偏移量來決定對從服務器執行何種數據同步操作:

  • 如果從服務器的複製偏移量之後的數據仍然存在於複製積壓緩衝區裏面,那麼主服務器將對從服務器執行部分複製操作
  • 如果從服務器的複製偏移量之後的數據不存在於複製積壓緩衝區裏面,那麼主服務器將對從服務器執行全量複製操作

3、服務器運行ID

每個 Redis 節點啟動后都會動態分配一個 40 位的十六進制字符串作為運行 ID,運行 ID 的主要作用是用來唯一識別 Redis 節點,我們可以使用 info server 命令來查看

127.0.0.1:6379> info server
# Server
redis_version:5.0.5
redis_git_sha1:00000000
redis_git_dirty:0
redis_build_id:2ef1d58592147923
redis_mode:standalone
os:Linux 3.10.0-957.27.2.el7.x86_64 x86_64
arch_bits:64
multiplexing_api:epoll
atomicvar_api:atomic-builtin
gcc_version:4.8.5
process_id:25214
run_id:7b987673dfb4dfc10dd8d65b9a198e239d20d2b1
tcp_port:6379
uptime_in_seconds:14382
uptime_in_days:0
hz:10
configured_hz:10
lru_clock:14554933
executable:/usr/local/redis-5.0.5/src/./redis-server
config_file:/usr/local/redis-5.0.5/redis.conf
127.0.0.1:6379> 

這裏面有一個run_id 字段就是服務器運行的ID

了解這幾個概念之後,我們一起來看看 psync 命令的運行流程,psync 命令運行流程如下圖所示:

psync 命令的邏輯比較簡單,整個流程分為兩步:

1、從節點發送 psync 命令給主節點,參數 runId 是當前從節點保存的主節點運行ID,參數offset是當前從節點保存的複製偏移量,如果是第一次參与複製則默認值為 -1。

2、主節點接收到 psync 命令之後,會向從服務器返回以下三種回復中的一種:

  • 回復 +FULLRESYNC {runId} {offset}:表示主服務器將與從服務器執行一次全量複製操作,其中 runid 是這個主服務器的運行 id,從服務器會保存這個id,在下一次發送 psync 命令時使用,而 offset 則是主服務器當前的複製偏移量,從服務器會將這個值作為自己的初始化偏移量
  • 回復 +CONTINUE:那麼表示主服務器與從服務器將執行部分複製操作,從服務器只要等着主服務器將自己缺少的那部分數據發送過來就可以了
  • 回復 +ERR:那麼表示主服務器的版本低於 redis 2.8,它識別不了 psync 命令,從服務器將向主服務器發送 sync 命令,並與主服務器執行全量複製

7、命令持續複製

當主節點把當前的數據同步給從節點后,便完成了複製的建立流程。但是主從服務器並不會斷開連接,因為接下來主節點會持續地把寫命令發送給從節點,保證主從數據一致性。

經過上面 7 步就完成了主從服務器之間的數據同步,由於這篇文章的篇幅比較長,關於全量複製和部分複製的細節就不介紹了,全量複製就是將主節點的當前的數據生產 RDB 文件,發送給從服務器,從服務器再從本地磁盤加載,這樣當文件過大時就需要特別大的網絡開銷,不然由於數據傳輸比較慢會導致主從數據延時較大,部分複製就是主服務器將複製積壓緩衝區的寫命令直接發送給從服務器。

心跳檢測

心跳檢測是發生在主從節點在建立複製后,它們之間維護着長連接並彼此發送心跳命令,便以後續持續發送寫命令,主從心跳檢測如下圖所示:

主從節點彼此都有心跳檢測機制,各自模擬成對方的客戶端進行通信,主從心跳檢測的規則如下:

  • 主節點默認每隔 10 秒對從節點發送 ping 命令,判斷從節點的存活性和連接狀態。可通過修改 redis.conf 配置文件裏面的 repl-ping-replica-period 參數來控制發送頻率
  • 從節點在主線程中每隔 1 秒發送 replconf ack {offset} 命令,給主節點 上報自身當前的複製偏移量,這條命令除了檢測主從節點網絡之外,還通過發送複製偏移量來保證主從的數據一致

主節點根據 replconf 命令判斷從節點超時時間,體現在 info replication 統 計中的 lag 信息中,我們在主服務器上執行 info replication 命令:

127.0.0.1:6379> info replication
# Replication
role:master
connected_slaves:1
slave0:ip=127.0.0.1,port=6480,state=online,offset=25774,lag=0
master_replid:c62b6621e3acac55d122556a94f92d8679d93ea0
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:25774
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:25774
127.0.0.1:6379> 

可以看出 slave0 字段的值最後面有一個 lag,lag 表示與從節點最後一次通信延遲的秒數,正常延遲應該在 0 和 1 之間。如果超過 repl-timeout 配置的值(默認60秒),則判定從節點下線並斷開複製客戶端連接,如果從節點重新恢復,心跳檢測會繼續進行。

主從拓撲架構

Redis的主從拓撲結構可以支持單層或多層複製關係,根據拓撲複雜性可以分為以下三種:一主一從、一主多從、樹狀主從架構

一主一從結構

一主一從結構是最簡單的複製拓撲結構,我們前面搭建的就是一主一從的架構,架構如圖所示:

一主一從架構用於主節點出現宕機時從節點 提供故障轉移支持,當應用寫命令併發量較高且需要持久化時,可以只在從節點上開啟 AOF,這樣既保證數據安全性同時也避免了持久化對主節點的性能干擾。但是這裡有一個坑,需要你注意,就是當主節點關閉持久化功能時, 如果主節點脫機要避免自動重啟操作。因為主節點之前沒有開啟持久化功能自動重啟后數據集為空,這時從節點如果繼續複製主節點會導致從節點數據也被清空的情況,喪失了持久化的意義。安全的做法是在從節點上執行 slaveof no one 斷開與主節點的複製關係,再重啟主節點從而避免這一問題

一主多從架構

一主多從架構又稱為星形拓撲結構,一主多從架構如下圖所示:

一主多從架構可以實現讀寫分離來減輕主服務器的壓力,對於讀佔比較大的場景,可以把讀命令發送到 從節點來分擔主節點壓力。同時在日常開發中如果需要執行一些比較耗時的讀命令,如:keys、sort等,可以在其中一台從節點上執行,防止慢查詢對主節點造成阻塞從而影響線上服務的穩定性。對於寫併發量較高的場景,多個從節點會導致主節點寫命令的多次發送從而過度消耗網絡帶寬,同時也加重了主節點的負載影響服務穩定性。

樹狀主從架構

樹狀主從架構又稱為樹狀拓撲架構,樹狀主從架構如下圖所示:

樹狀主從架構使得從節點不但可以複製主節 數據,同時可以作為其他從節點的主節點繼續向下層複製。解決了一主多從架構中的不足,通過引入複製中 間層,可以有效降低主節點負載和需要傳送給從節點的數據量。如架構圖中,數據寫入節點A 後會同步到 B 和 C節點,B節點再把數據同步到 D 和 E節點,數據實現了一層一層的向下複製。當主節點需要掛載多個從節點時為了避免對主節點的性能干擾,可以採用樹狀主從結構降低主節點壓力。

最後

目前互聯網上很多大佬都有 Redis 系列教程,如有雷同,請多多包涵了。原創不易,碼字不易,還希望大家多多支持。若文中有所錯誤之處,還望提出,謝謝。

歡迎掃碼關注微信公眾號:「平頭哥的技術博文」,和平頭哥一起學習,一起進步。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

物聯網架構成長之路(47)-利用GitLab實現CI持續集成

0.前言
  前段時間,考慮到要練習部署一套CI/CD的系統。一開始考慮到Jenkins,隨着這两天的了解,發現最新版的GitLab已經提供有CI/CD集成了。所以本次博客,乾脆一步到位,直接用GitLab裏面的CI/CD模塊。Jenkins可能需要更高級的應用場合。經過測試GitLab自帶的功能完全符合我的需求。

1. 安裝GitLab和GitLab-CI(gitlab-runner)
  英語比較好的,可以直接看官方文檔。https://docs.gitlab.com/omnibus/docker/#install-gitlab-using-docker-compose https://docs.gitlab.com/ee/ci/quick_start/README.html
  下面提供我使用的 docker-compose.yml

 1 version: '3'
 2 services:
 3     gitlab:
 4         image: twang2218/gitlab-ce-zh:latest
 5         #image: gitlab/gitlab-ce:rc
 6         restart: always
 7         hostname: '172.16.23.203'
 8         environment:
 9             GITLAB_OMNIBUS_CONFIG: |
10                 external_url 'http://172.16.23.203:8929'
11                 gitlab_rails["time_zone"] = "Asia/Shanghai"
12         ports:
13             - 8929:8929
14             - 1080:80
15             - 1443:443
16             - 1022:22
17         volumes:
18             - /root/workspace/docker/gitlab/1/config:/etc/gitlab
19             - /root/workspace/docker/gitlab/1/logs:/var/log/gitlab
20             - /root/workspace/docker/gitlab/1/data:/var/opt/gitlab
21     gitlab-runner:
22         image: gitlab/gitlab-runner:latest
23         restart: always
24         volumes:
25             - /root/workspace/docker/gitlab/2/config:/etc/gitlab-runner
26             - /var/run/docker.sock:/var/run/docker.sock

  執行docker-compose up -d 就運行起來,幾點需要說明的
    1. gitlab的image,可以選擇中文版或者英文版
    2. hostname 這裏指定本機IP地址
    3. gitlab環境變量,external_url表示提供訪問的IP和端口,時區配置上海
    4. 端口映射,默認是80端口,由於我上面配置了8929,所以映射8929到Host主機
    5. volumes 配置持久化數據
    6. 這裏的/var/run/docker.sock 要映射到主機,因為會用到主機的一些資源,同時還會在docker裏面安裝docker
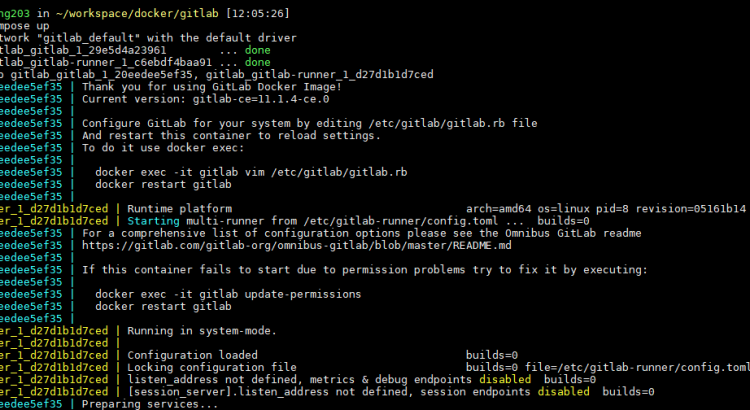
  下面是運行效果,第一次運行會比較久,因為要拉取鏡像和初始化GitLab

2. 登錄使用GitLab
  首次登錄,設置密碼。 登錄默認用戶名是root
  利用模版,新建一個Spring項目

  利用IDE,或者其他工具,或者直接在GitLab修改代碼

3. 配置CI/CD,把機器(gitlab-runner)註冊到GitLab中
  可以在項目配置CI/CD機器,也可以在個人所有項目下配置,也可以由管理員配置所有項目下CI/CD機器。原理和流程都是一樣的,只是比Jenkins更加細粒度控制而已。

  進入gitlab-runner的Docker,執行初始化命令 gitlab-ci-multi-runner register,完整命令如下:

1 sudo docker exec -it gitlab-runner gitlab-ci-multi-runner register

  需要錄入的信息,安裝上圖進行,填寫,後續還可以修改。

  如果需要修改,可以修改之前volumes配置的路徑下, config/config.toml


 1 concurrent = 1
 2 check_interval = 0
 3 
 4 [session_server]
 5   session_timeout = 1800
 6 
 7 [[runners]]
 8   name = "myRunner"
 9   url = "http://172.16.23.203:8929/"
10   token = "96beefdaa54832b0c8369ffa3811c9"
11   executor = "docker"
12   [runners.custom_build_dir]
13   [runners.docker]
14     tls_verify = false
15     image = "docker:latest"
16     privileged = true
17     disable_entrypoint_overwrite = false
18     oom_kill_disable = false
19     disable_cache = false
20     volumes = ["/cache", "/root/.m2:/root/.m2", "/var/run/docker.sock:/var/run/docker.sock"]
21     shm_size = 0
22   [runners.cache]
23     [runners.cache.s3]
24     [runners.cache.gcs]


  上面這個是配置文件,裏面有幾個注意點
    1. privileged 這裏要配置 true,因為要在docker裏面安裝docker
    2. /root/.m2 這個是配置maven的倉庫使用宿主主機的緩存,這樣就不用每次CI都要下載依賴
    3. /var/run/docker.sock 這個也要配置,在構建dockerfile的時候會用到
  還有一個需要配置的就是,這個Runner需要設置tag,這個是標識Runner的名稱。在.gitlab-ci.yml中會用到

4. 配置CI/CD
  默認GitLab是啟用該功能的,根目錄配置新增 .gitlab-ci.yml 文件,然後每次git push,都會觸發CI持續集成。當然可以在yml配置,在主線master觸發。
  來個簡單的配置,測試一下

 1 image: maven:3-jdk-8
 2 cache:
 3     paths:
 4         - .m2/repository
 5 test:
 6     stage: test
 7     script:
 8         - mvn package
 9     tags:
10         - tag

  上面這個配置,寫到.gitlab-ci.yml然後提交到repo,我們提交該文件到gitlab對應項目上去。

1 git add .gitlab-ci.yml
2 git commit -m "Add .gitlab-ci.yml"
3 git push origin master

  如果嫌慢,pom.xml 可以換個阿里源

 1         <repository>
 2             <id>maven-ali</id>
 3             <url>http://maven.aliyun.com/nexus/content/groups/public/</url>
 4             <releases>
 5                 <enabled>true</enabled>
 6             </releases>
 7             <snapshots>
 8                 <enabled>true</enabled>
 9                 <updatePolicy>always</updatePolicy>
10                 <checksumPolicy>fail</checksumPolicy>
11             </snapshots>
12         </repository>

  一提交,就會觸發自動構建

  可以看到整個構建過程,如果出現錯誤,也是到這個日誌裏面排查問題。


5. 測試、打包、發布
  這一步,我們實現一個簡單的測試、打包、發布
5.1 增加 Dockerfile

1 FROM openjdk:8-jdk-alpine
2 VOLUME /tmp
3 COPY  target/demo-0.0.1-SNAPSHOT.jar app.jar
4 ENV PORT 5000
5 EXPOSE $PORT
6 ENTRYPOINT ["java","-Djava.security.egd=file:/dev/./urandom","-Dserver.port=${PORT}","-jar","/app.jar"]

5.2 修改 .gitlab-ci.yml

 1 image: maven:3-jdk-8
 2 
 3 variables:
 4     DOCKER_TAG: test/demo-spring:0.1
 5 
 6 cache:
 7     paths:
 8         - .m2/repository
 9 
10 stages:
11     - test
12     - package
13     - deploy
14 
15 test:
16     stage: test
17     tags:
18         - tag
19     script:
20         - mvn test
21 
22 package:
23     stage: package
24     tags:
25         - tag
26     script:
27         - mvn clean package -Dmaven.test.skip=true
28     artifacts:
29         paths:
30             - target/*.jar
31 
32 deploy:
33     image: docker:latest
34     stage: deploy
35     services:
36         - docker:dind
37     tags:
38         - tag
39     script:
40         - docker version 
41         - docker build -t $DOCKER_TAG .
42         - docker rm -f test || true
43         - docker run -d --name test -p 5000:5000 $DOCKER_TAG

  那個artifacts.paths 配置,提交target目錄下的文件到下一個流水線,因為不同流水線,由於是基於Docker,所以每一步都是隔離的。同時,上傳的附件還可以在構建成功后,在流水線pipelines界面進行下載。每一步的image都是可以指定的,那個tags也是可以指定的。可以提交到不同的機器進行構建。
  上面一共就三步流程,先test(測試),然後package(打包編譯),最後deploy(發布測試)。前兩個比較好理解,就是maven的基本命令。最後那個deploy就是利用docker裏面的docker來進行打包成docker,然後運行起來,作為測試發布。
  更新代碼.gitlab-ci.yml,然後提交,觸發持續集成。

  查看構建日誌

  查看宿主機鏡像和運行狀態

  查看瀏覽器,已經發布到測試環境了

5.3 釘釘通知

 1 image: maven:3-jdk-8
 2 
 3 variables:
 4     DOCKER_TAG: test/demo-spring:0.1
 5 
 6 cache:
 7     paths:
 8         - .m2/repository
 9 
10 stages:
11     - test
12     - package
13     - deploy
14     - notify
15 
16 test:
17     stage: test
18     tags:
19         - tag
20     script:
21         - mvn test
22 
23 package:
24     stage: package
25     tags:
26         - tag
27     script:
28         - mvn clean package -Dmaven.test.skip=true
29     artifacts:
30         paths:
31             - target/*.jar
32 
33 deploy:
34     image: docker:latest
35     stage: deploy
36     services:
37         - docker:dind
38     tags:
39         - tag
40     script:
41         - docker version 
42         - docker build -t $DOCKER_TAG .
43         - docker rm -f test || true
44         - docker run -d --name test -p 5000:5000 $DOCKER_TAG
45 
46 notify:
47     image: appropriate/curl:latest
48     stage: notify
49     tags:
50         - tag
51     script: "curl 'https://oapi.dingtalk.com/robot/send?access_token=d6c15304c1***************************************' -H 'Content-Type: application/json' -d '{\"msgtype\": \"text\", \"text\": {\"content\": \"功能已更新部署至測試環境\"}}' "

  有了這個通知,就可以做很多事情了,寫個腳本,封裝成一個Docker 鏡像,可以發送釘釘,發送郵件,可以對接到第三方系統等。

  更多高級應用,如集成之前了解的Harbor,Rancher。使整個系統更加強大,更加智能化。


參考資料


本文地址:
本系列目錄:
個人主頁:

volumes

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

JavaScript 是否應該重命名

  在誕生 25 年之後,JavaScript 語言仍然讓很多人困惑不已。所以一個老生常談的問題是:它是否應該重命名?呼籲改名的支持者列舉了一系列理由,包括:

  • JavaScript 本意指的是 ECMAScript 的子集,但使用中它經常被指代多種不同的 ECMAScript 超集
  • JavaScript 是甲骨文公司的商標,這與 JavaScript 作為 Web 平台核心組件的身份不相符合,Web 平台是建立在開放技術和標準基礎上的
  • JavaScript 連官方 logo 都沒有
  • JavaScript 與 Java 沒有一點關係,幾十年來它給非技術人員造成了混淆。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

雅虎日本在其餐廳徵收“油炸食品稅”

  為了推廣健康生活方式,減少僱員中間的肥胖率,雅虎日本在其總部餐廳開始徵收“油炸食品稅”。從 10 月 8 日開始,炸豬排之類的油炸食品價格上漲,而水煮魚或烤魚之類的魚類食品則價格下降。

  它在 2017 年的體檢显示,45% 的僱員 LDL 膽固醇含量較高。它的自助餐廳每天有 1000 名僱員吃飯,油炸食品要比水煮魚或烤魚受歡迎得多。除了炸豬排漲價外,炸雞排也漲了 100 日元至 691 日元。如今到了午餐點,魚類食品一售而空,官員表示效果顯著。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

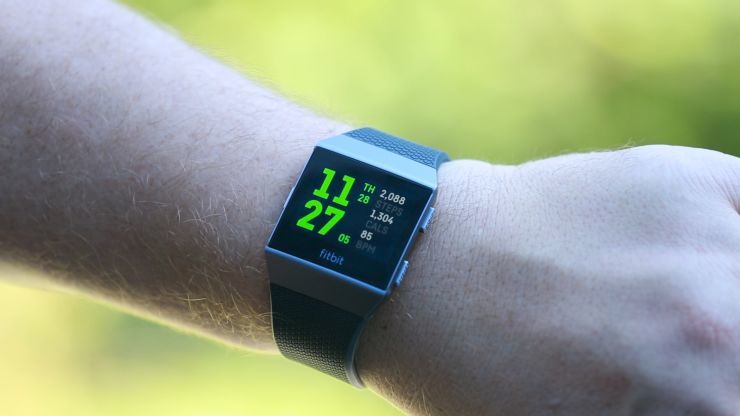
傳谷歌母公司欲收購Fitbit 擬推自有品牌可穿戴設備

  原標題:Google is reportedly trying to buy Fitbit

  網易科技訊,10 月 29 日消息,據外媒報道,據知情人士透露,谷歌母公司 Alphabet 正在就收購美國可穿戴設備公司 Fitbit 與後者進行談判。不過,目前兩家公司還沒有確認這筆交易,也不清楚 Alphabet 的報價。上個月,有報道稱 Fitbit 正在探索出售的可能。

  多年來,谷歌憑藉其 Wear OS 操作系統在可穿戴市場上佔據了重要地位,但它始終難以與 Apple Watch 競爭,儘管其得到了包括 LG、Fossil 和 TicWatch 在內的眾多公司支持。就連主要的安卓製造商三星也未使用 Wear OS,而是使用自己的 Tizen 操作系統。

  今年 1 月,谷歌斥資 4000 萬美元從 Fossil 手中收購了某種智能手錶技術,但目前尚不清楚該技術到底是什麼,Fossil 高管將其描述為“尚未投放市場的新產品創新”,不過迄今仍然沒有上市。

  多年來,始終有傳言稱谷歌希望推出自家品牌的 Pixel 智能手錶。在 2016 年的某個時候,這些計劃幾乎促使谷歌品牌的智能手錶上市,但該公司最終擱置了計劃,因為其擔心這些手錶可能“傷及谷歌硬件品牌的聲譽”。這些 LG 製造的智能手錶後來在 2017 年以 LG Watch Sports 和 LG Watch Style 的形式發布,評價一般。

  從那時起,谷歌打造自家硬件野心開始膨脹。2017 年,谷歌收購了 HTC 智能手機工程團隊以開發 Pixel 手機,而 Fitbit 的收購可能會幫助其在可穿戴設備領域取得類似的進展。

  與此同時,蘋果在 Apple Watch 上的經驗表明,健康正迅速成為智能手錶的殺手級應用,這也是 Fitbit 自身健身追蹤器越來越關注的一個領域。然而,儘管 Fitbit 在 2016 年收購了智能手錶製造商 Pebble,但其在智能手錶方面的表現卻不盡如人意。例如,今年早些時候發布的健身跟蹤器 Fitbit Versa 2,其實本質上就是一款普通的智能手錶。

  谷歌和 Fitbit 拒絕就上述報道置評。(小小)


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

現代汽車新一代氫燃料電池車「NEXO」於CES亮相


南韓現代汽車(Hyundai Motor Co.)全新一代氫燃料電池車「NEXO」,9日在拉斯維加斯消費性電子展(CES)上正式亮相。   根據,NEXO具備更加完備的駕駛輔助功能,將和豐田汽車(Toyota Motor Corp.)的「Mirai」、本田汽車 (Honda Motor Co.)的「Clarity Fuel Cell」一較高下。   NEXO將在3月起於南韓開賣,2018年還將出口到特定市場。這款汽車只要花五分鐘的時間加氫,就可跑超過590公里(相當於370英里)。   此外,NEXO還配備先進駕駛輔助系統(Advanced Driver Assistance Systems;ADAS)、遙控代客停車助理服務(Remote Smart Parking Assistant)、車道追隨系統(Lane Following System)和高速公路輔助駕駛系統(Highway Driving Assistant)。   BMW、特斯拉等車廠,都推出了遙控代客停車助理服務。ADAS則支援「Level 2」自駕功能,汽車可自主掌舵、加速和減速,但仍需由駕駛人負責變換車道、下高速公路、轉彎等。   在被問到氫燃料電池車未來的需求時,現代汽車副董事長Chung Eui-sun表示,目前這種車款需求雖不多,但20年內就能成長為龐然大物。   (本文內容由授權使用。首圖來源:)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【電動二輪車資訊】

綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

Google地圖已可更新顯示潭子電動車充電站設置地點!!